vLLM і SGLang: практичне порівняння двох серверів для мовних моделей
Привіт!
vLLM і SGLang — два головні відкриті сервери для запуску мовних моделей на власних відеокартах. Завдання в них одне, API однаковий, швидкість близька. Відрізняються вони роботою з пам'яттю, налаштуванням, безпекою та моніторингом.
У кожному розділі статті спочатку спільна частина, потім підрозділ про vLLM і підрозділ про SGLang. Версії: vLLM 0.34.0 від 16 листопада 2026 і SGLang 0.5.23 від 2 листопада 2026. Команди, файли налаштувань і вивід узято з робочого стенда; що переказано за документацією без запуску, позначено.
Головне:
- Один запит обидва обробляють з однаковою швидкістю. Різниця з'являється під навантаженням і залежить від моделі.
- Пам'ять: vLLM розподіляє її сам, у SGLang частку задаєте ви.
- Кеш діалогів у SGLang точніший: він економить більше на довгих діалогах і агентах.
- Безпека: жоден не можна виставляти в інтернет без проксі.
- vLLM — вибір за замовчуванням, SGLang — для агентів і великих кластерів. Схема вибору — наприкінці.
Як рушії інференсу влаштовані всередині, розібрано в окремій статті. Тут потрібні чотири поняття звідти: токени, фази prefill і decode, KV-кеш і батчинг. TTFT — час до першого токена відповіді.
Що таке vLLM і SGLang
Сервер інференсу тримає модель у відеопам'яті, приймає запити по HTTP у форматі OpenAI і обробляє багато запитів одночасно. Шлях запиту:
vLLM: хто його робить
- Репозиторій: близько 97 тисяч зірок, ліцензія Apache 2.0, нова версія кожні два тижні.
- З'явився у 2023 році в Берклі. З 2025 року — проєкт PyTorch Foundation. Із січня 2026-го за ним стоїть компанія Inferact (150 млн доларів інвестицій).
- Хто використовує: LinkedIn (понад 50 продуктів), Red Hat (основа її продуктів для OpenShift), AWS (SageMaker і Bedrock), NVIDIA (контейнери NIM 2 містять vLLM або SGLang).
SGLang: хто його робить
- Репозиторій: близько 39 тисяч зірок, ліцензія Apache 2.0, нова версія кожні два тижні.
- З'явився у 2024 році. Веде його неприбуткова LMSYS, автори рейтингу Chatbot Arena. З 2026 року за ним стоїть компанія RadixArk (100 млн доларів інвестицій).
- Хто використовує: xAI (картка Grok-2 велить запускати модель через SGLang), Meta (за її доповіддю у листопаді 2026-го), Cloudflare (Workers AI), LinkedIn (ранжування в пошуку; LinkedIn використовує обидва сервери).
Чим вони відрізняються від інших способів запустити модель
vLLM і SGLang розраховані на багато одночасних запитів на власних відеокартах. Для одного користувача вони не швидші за прості програми.
| Спосіб | Для чого | Відмінність від vLLM і SGLang |
|---|---|---|
| llama.cpp, Ollama, LM Studio | модель на власному комп'ютері | працює навіть без відеокарти, стиснуті моделі GGUF, старт за секунди; під навантаженням від багатьох користувачів слабший |
| TensorRT-LLM | максимум швидкості на NVIDIA | лише NVIDIA, менше моделей |
| NVIDIA NIM | готовий контейнер із платною підтримкою | не рушій: усередині vLLM або SGLang |
| TGI від Hugging Face | колишній головний суперник | в архіві, автори радять vLLM і SGLang |
| Dynamo, llm-d, AIBrix | десятки відеокарт у Kubernetes | шар над рушіями: роздає запити копіям vLLM або SGLang |
| LiteLLM | одна адреса для різних моделей, ключі, бюджети | шлюз перед серверами, моделі не запускає |
| Хмарний API | оплата за токени | нічого обслуговувати; власна відеокарта окупається лише за постійного завантаження |
Докладніше — в мапі рушіїв.
vLLM: місце серед інших систем
Вибір за замовчуванням. Найширший список моделей і заліза. Шари для Kubernetes (llm-d, AIBrix, KServe), Ray Serve і продукти Red Hat першим ділом підтримують його. У тестах MLPerf у квітні 2026 року на ньому працювали 20 учасників (підрахунок Red Hat).
SGLang: місце серед інших систем
Сильніший на запитах зі спільним початком: агенти, довгі діалоги, один системний промпт у багатьох користувачів. Часто попереду на дуже великих моделях на десятках відеокарт. Ті самі шари для кластерів його підтримують, але зазвичай пізніше, ніж vLLM.
Стенд
- Відеокарта RTX 5070 Ti Laptop, 12 ГБ; Ryzen 9 9955HX; 64 ГБ оперативної пам'яті.
- Windows 11, WSL2, Docker Desktop.
- Образи
vllm/vllm-openai:v0.34.0іlmsysorg/sglang:v0.5.23-runtime. - Prometheus 3.16, Grafana 13.3, Jaeger 2.23, nginx 1.30 — в одній мережі Docker.
Моделі — родина Qwen3.5: розуміють картинки, міркують перед відповіддю, викликають функції, ліцензія Apache 2.0.
| Модель | Ваги | На 12 ГБ |
|---|---|---|
| Qwen3.5-4B, FP8 | 7,5 ГіБ | основна модель статті |
| Qwen3.5-2B | 4,3 ГіБ | заміри під навантаженням |
| Qwen3.5-0.8B | 1,7 ГіБ | дві копії одразу, для маршрутизації |
| Qwen3.5-4B без стиснення | 8,7 ГіБ | не запускається |
| Qwen3.5-9B, 4 біти | 8,5 ГіБ | не запускається |
Абсолютні цифри швидкості на ноутбуці в рази нижчі за серверні. Налаштування, помилки та вміст журналів на великому залізі ті самі.
Залізо і системи
Обом серверам потрібні Linux, прискорювач із достатньою пам'яттю і свіжі драйвери.
vLLM: залізо і системи
- ОС: лише Linux. Windows — через WSL2 або Docker, Mac — через плагін vllm-metal.
- Python: 3.11–3.14.
- NVIDIA: від T4 і RTX 20xx. Збірки лише під CUDA 13. Для старих драйверів —
VLLM_ENABLE_CUDA_COMPATIBILITY=1. - AMD: Instinct MI200, MI300, MI350, Radeon RX 7900 і RX 9000 (ROCm).
- Intel: Arc і серверні прискорювачі.
- Плагінами: Google TPU, AWS Trainium, Huawei Ascend, Apple Silicon.
- Без відеокарти: працює, для маленьких моделей.
SGLang: залізо і системи
- ОС: Linux. Windows у документації не згадується; у Docker поверх WSL2 працює.
- Python: 3.11 і новіший. На 3.10 встановлення не падає, а ставить стару версію сервера.
- NVIDIA: від A100 до найновіших серверних, RTX 30, 40 і 50, DGX Spark, Jetson. Лише CUDA 13.
- AMD: Instinct MI300X, MI325X, MI350X, MI355X.
- Intel: Arc і Xeon.
- Інше: Google TPU, Huawei Ascend, Apple Silicon, Moore Threads.
- RTX 50 і встановлення через pip: жодна модель не запускається без ручного налаштування шляхів до компілятора CUDA (відкрита задача). В образі Docker проблеми немає.
Встановлення
Два способи: пакет Python або образ Docker. У продакшені беруть образ із номером версії, а не latest: обидві програми виходять кожні два тижні й регулярно змінюють прапорці.
Моделі завантажуються з Hugging Face під час першого запуску в ~/.cache/huggingface. Цю теку підключають до контейнера, щоб не завантажувати знову.
vLLM: встановлення
uv pip install vllm --torch-backend=autovllm download-kernelsДруга команда завантажує готові ядра для відеокарти. Без неї сервер компілює їх під час першого запуску кілька хвилин. Запускати після кожного встановлення й оновлення.
docker pull vllm/vllm-openai:v0.34.0Образ: 10 ГБ під час завантаження, 36 ГБ на диску.
SGLang: встановлення
uv pip install --prerelease=allow sglangБез --prerelease=allow старі версії uv мовчки ставлять SGLang 0.5.9.
docker pull lmsysorg/sglang:v0.5.23-runtimeОбраз -runtime полегшений: 14,5 ГБ під час завантаження, 50 ГБ на диску. Повний, v0.5.23, містить ще інструменти збирання.
Перший запуск
Сервер запускається однією командою. vLLM слухає порт 8000, SGLang — 30000. Запити до них однакові.
vLLM: перший запуск
docker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ vllm/vllm-openai:v0.34.0 \ RedHatAI/Qwen3.5-4B-FP8-dynamic \ --max-model-len 16384 --max-num-seqs 16--ipc=host— процеси сервера обмінюються даними через спільну пам'ять.- Том
vllm-cacheзберігає скомпільоване під час першого запуску. - Готовність: рядок
Application startup complete. На стенді — через 155 секунд.
Що сервер пише про пам'ять:
Model loading took 6.23 GiB memory and 11.814035 secondsAvailable KV cache memory: 3.99 GiBGraph capturing finished in 1 secs, took 0.14 GiBGPU KV cache size: 34,492 tokens, Maximum concurrency for 16,384 tokens per request: 2.11xПам'яті діалогів вистачає на 34 492 токени — два діалоги максимальної довжини.
Запит:
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "RedHatAI/Qwen3.5-4B-FP8-dynamic", "messages": [{"role": "user", "content": "What is a KV cache in LLM inference? Answer in two sentences."}], "max_tokens": 400 }'У полі content прийдуть міркування моделі, а не відповідь:
Thinking Process:
1.  **Analyze the Request:**    *   Topic: KV cache in Large Language Model (LLM) inference.    *   Constraint: Answer in exactly two sentences....
Сервер не знає, де в моделі закінчуються міркування, доки не заданий прапорець --reasoning-parser (розділ про налаштування).
Список усіх адрес API — на сторінці http://localhost:8000/docs, там 24 операції:
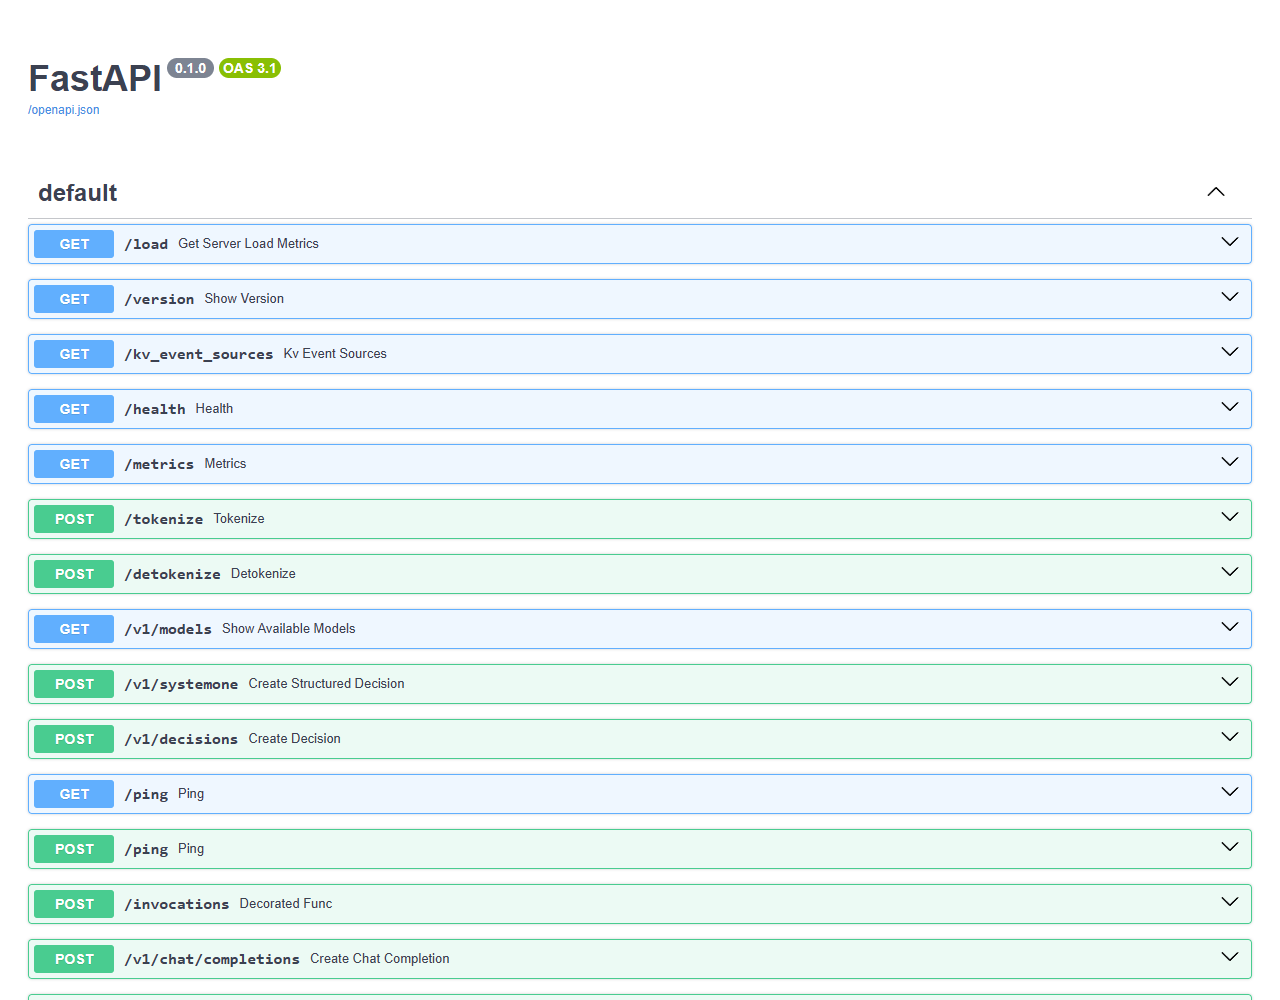
SGLang: перший запуск
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --host 0.0.0.0 --port 30000 \ --context-length 16384 --mem-fraction-static 0.8--host 0.0.0.0обов'язковий у контейнері. За замовчуванням сервер слухає127.0.0.1: журнал пише «готовий», а запити ззовні не проходять.- Готовність: рядок
The server is fired up and ready to roll!. На стенді — через 85–100 секунд.
Що сервер пише про пам'ять:
Load weight end. elapsed=2.19 s, quant=compressed-tensors, avail mem=4.44 GB, mem usage=6.28 GB.Mamba Cache is allocated. max_mamba_cache_size: 20, conv_state size: 0.02GB, ssm_state size: 0.98GBKV Cache is allocated. #tokens: 38949, K size: 0.59 GB, V size: 0.59 GBmax_total_num_tokens=38949, max_running_requests=4, context_len=16384, available_gpu_mem=0.37 GBПам'ять діалогів — 38 949 токенів, одночасно не більше чотирьох запитів.
Запит і відповідь такі самі, як у vLLM, змінюється лише порт. Міркування теж потрапляють у content, доки не заданий --reasoning-parser.
На сторінці /docs у SGLang 108 операцій:
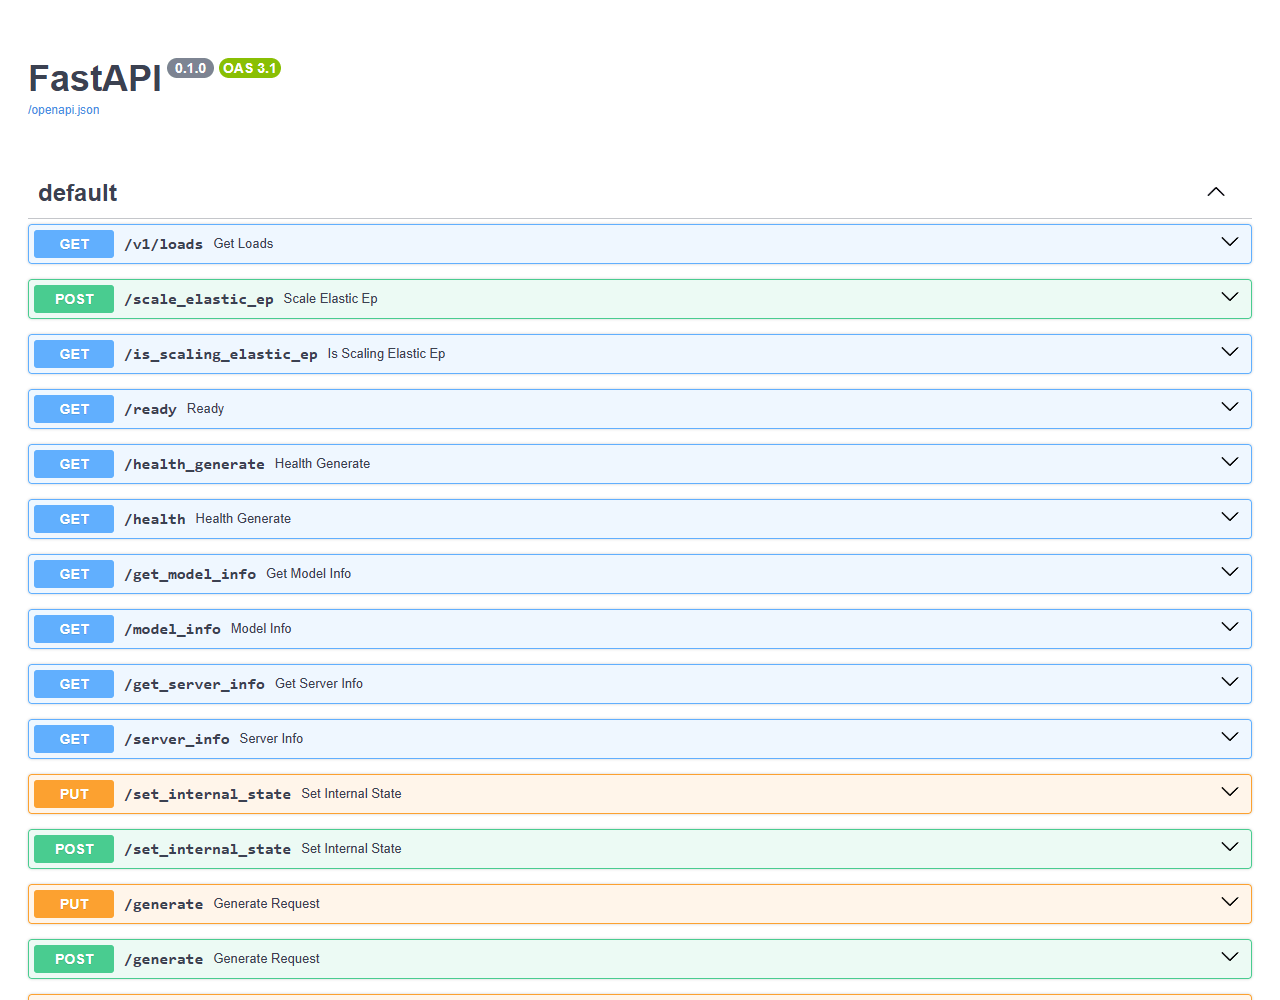
Окрім API для клієнтів, тут керування сервером: скидання кешу, оновлення ваг, завантаження адаптерів, профілювання. Усе це потрібно закрити від сторонніх (розділ про мережу).
Відеопам'ять
Від відеопам'яті залежить, чи запуститься модель, скільки діалогів поміститься одночасно і якої вони можуть бути довжини. Пам'ять ділять так:
- Ваги моделі. Розмір дорівнює розміру файлів моделі й не змінюється.
- Пам'ять діалогів (KV-кеш). У Qwen3.5-4B — 32 КіБ на токен: діалог на 16 тисяч токенів займає 512 МіБ. Зростає з кількістю користувачів.
- Стан гібридних моделей. У Qwen3.5 звичайна увага лише у 8 шарах із 32. Решта 24 зберігають для діалогу стиснений стан сталого розміру. У журналах він називається Mamba cache.
- Робочі буфери для обчислень одного кроку. На стенді — близько 1,6 ГіБ.
- Записані графи обчислень (CUDA-графи): 0,1–0,5 ГіБ.
- Інші програми. На ноутбуці робочий стіл і браузер займають 1,2 ГіБ, на виділеному сервері — нічого.
Одна й та сама модель у двох серверах:
Порядок, у якому сервери ділять пам'ять під час старту, різний:
Що з цього випливає:
- Крім ваг потрібно ще 3–4 ГіБ. Модель, яка за розміром файлів майже дорівнює відеопам'яті, не запуститься.
- Пам'ять діалогів — це залишок після ваг, буферів і графів.
- Важелів три: довжина діалогу, кількість одночасних запитів, частка пам'яті сервера.
vLLM: відеопам'ять
До версії 0.34 сервер забирав 92% відеопам'яті заздалегідь. З 0.34 він завантажує ваги, проганяє пробні запити, вимірює буфери й графи та віддає пам'яті діалогів усе, що залишилося. Прапорець --gpu-memory-utilization тепер краще не задавати: будь-яке значення лише зменшить пам'ять діалогів. Стара порада «не запускається — зменште --gpu-memory-utilization» застаріла.
Actual usage is 6.33 GiB for consumed memory (weights + non-torch), 1.59 GiB for peak activation, and 0.14 GiB for CUDAGraph memory.Memory after warmup: 4.17 GiB free, 1.59 GiB kept for transient activations; 80 KV cache blocks (1.41 GiB) fit within the requested 11.91 GiB.| Прапорець | Що робить |
|---|---|
--max-model-len | максимальна довжина діалогу в токенах. За замовчуванням з моделі: у Qwen3.5 це 262 144 |
--max-num-seqs | кількість одночасних запитів. За замовчуванням 256, на великих серверних картах 1024 |
--gpu-memory-utilization | частка відеопам'яті сервера. Потрібна, коли карту ділить кілька програм |
--kv-cache-memory-bytes | точний розмір пам'яті діалогів |
--kv-cache-dtype fp8 | стиснута пам'ять діалогів: удвічі більше діалогів |
Коли пам'ять діалогів закінчується, нові запити чекають у черзі. Якщо не вистачає вже розпочатим, сервер витісняє останній прийнятий запит і пізніше читає його промпт заново. Користувач бачить затримку, а не помилку.
Дві копії сервера на одній відеокарті: кожній --gpu-memory-utilization 0.4, інакше перша займе все.
SGLang: відеопам'ять
Прапорець --mem-fraction-static задає частку відеопам'яті під ваги й пам'ять діалогів разом. Решта дістається буферам і графам. Без прапорця сервер рахує частку сам; на карті з 12 ГБ вийшло 0,63.
Як підбирати, за документацією:
- під час старту сервер пише залишок вільної пам'яті —
available_gpu_mem; - на великих картах норма — 5–8 ГБ залишку;
- залишок набагато більший — частку можна підняти;
- сервер падає через брак пам'яті під навантаженням — частку потрібно зменшити.
На 12 ГБ значення за замовчуванням занадто обережне. Qwen3.5-4B у FP8 із ним не запускається:
RuntimeError: Hybrid (mamba/linear-attention) state cache is too small to serve any requests. max_mamba_cache_size=3, mamba_ratio=5, resulting max_num_reqs=0. Try: (1) reduce --max-running-requests, (2) increase --mem-fraction-static, or (3) use GPUs with more memory.З --mem-fraction-static 0.8 запускається: чотири одночасні запити.
| Прапорець | Що робить |
|---|---|
--mem-fraction-static | частка відеопам'яті під ваги й пам'ять діалогів |
--context-length | максимальна довжина діалогу в токенах |
--max-running-requests | кількість одночасних запитів |
--max-total-tokens | точний розмір пам'яті діалогів у токенах |
--chunked-prefill-size | розмір шматків, якими читається довгий промпт. Менше — менші буфери |
--kv-cache-dtype fp8_e4m3 | стиснута пам'ять діалогів. Для точності потрібен файл масштабів: --quantization-param-path |
--mamba-full-memory-ratio, --max-mamba-cache-size | пам'ять під стан гібридних моделей |
Коли пам'ять діалогів закінчується, SGLang знімає один із запитів, що виконуються, і повертає його в чергу. У журналі: KV cache pool is full. Retract requests. Якщо це відбувається часто, підніміть --schedule-conservativeness.
Що не вміщується в 12 ГБ
| Модель | Ваги в пам'яті | vLLM | SGLang |
|---|---|---|---|
| Qwen3.5-4B без стиснення | 8,6 ГіБ | немає місця під пам'ять діалогів | не вистачило 2,57 ГБ під стан |
| Qwen3.5-9B, 4 біти | 8,4–9,5 ГіБ | те саме | те саме |
Стиснення до 4 біт зменшує лише основні шари. Блок розбору картинок і таблиці токенів лишаються колишніми, тому модель на 9,7 млрд параметрів займає понад 8 ГіБ.
Відмова vLLM:
Memory after warmup: 0.91 GiB free, 1.59 GiB kept for transient activations; 0 KV cache blocks (0.0 GiB) fit within the requested 11.91 GiB.ValueError: No available memory for the cache blocks. [...] decrease `max_model_len` or `max_num_seqs`, or the model needs a device with more memory.Відмова SGLang:
Load weight end. avail mem=1.37 GB, mem usage=9.35 GB.RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache. Computed max_mamba_cache_size=-27 (total_rest_memory=-2.57 GB, mamba_cache_per_req=49.12 MB).vLLM повідомляє про брак пам'яті через 2–4 хвилини, наприкінці прогріву. SGLang — через 20–30 секунд, одразу після завантаження ваг.
У vLLM із гібридною моделлю трапляється ще одна помилка під час старту: значення --max-num-seqs за замовчуванням завелике.
ValueError: max_num_seqs (256) exceeds available Mamba cache blocks (42). Please lower max_num_seqs to at most 42 or increase gpu_memory_utilization.Формати моделей і квантування
Обидва сервери працюють із форматом safetensors з Hugging Face. GGUF, звичний за llama.cpp і Ollama, — не їхній формат. Що таке квантування — у розділі про нього.
Заздалегідь стиснуту модель обидва сервери розпізнають самі, без прапорців.
vLLM: формати і квантування
- Джерела: Hugging Face, тека на диску, ModelScope (
VLLM_USE_MODELSCOPE=True), об'єктне сховище (vllm serve s3://bucket/model --load-format runai_streamer). - Готові стиснуті моделі: FP8, AWQ, GPTQ, INT8, INT4, NVFP4, MXFP4, compressed-tensors, NVIDIA ModelOpt, AMD Quark.
- Стиснення під час завантаження:
--quantization fp8_per_tensor. - GGUF: окремий плагін
vllm-gguf-plugin, експериментальний. - bitsandbytes: окремий плагін
vllm-bnb-plugin. - Стиснути власну модель: LLM Compressor.
- LoRA-адаптери:
--enable-lora --lora-modules sql=шлях. Клієнт вибирає адаптер полемmodel; запити до різних адаптерів ідуть в одному батчі.
SGLang: формати і квантування
- Джерела: Hugging Face, тека на диску, ModelScope (
SGLANG_USE_MODELSCOPE=true), адресиs3://,gs://,az://. - Готові стиснуті моделі: ті самі основні формати. Прапорець
--quantizationдо вже стиснутої моделі додавати не можна. - Стиснення під час завантаження:
--quantization fp8. Стиснення через torchao з версії 0.5.23 прибрано. - GGUF: формат завантаження
ggufє, список підтримуваних архітектур документація не наводить. - LoRA-адаптери:
--enable-lora --lora-paths sql=шлях. Завантажуються й вивантажуються на ходу:/load_lora_adapter,/unload_lora_adapter. У запиті:"model": "базова-модель:адаптер".
Швидкість на стенді, один користувач:
| Модель | vLLM | SGLang |
|---|---|---|
| Qwen3.5-4B, FP8 | 84 ток/с | 56–60 ток/с |
| Qwen3.5-2B без стиснення | 110 ток/с | 109 ток/с |
Обчислення у FP8 для цієї моделі у vLLM швидші. На нестисненій моделі різниці немає.
Налаштування
Налаштування задаються прапорцями, файлом YAML або змінними середовища. Якщо значення є і в прапорці, і у файлі, перемагає прапорець.
Для моделей, що міркують, і виклику функцій потрібні два розбірники, свої для кожної родини моделей:
- reasoning parser відокремлює міркування від відповіді;
- tool call parser перетворює текст моделі на виклик функції з аргументами.
vLLM: налаштування
# vLLM 0.34 — усі налаштування сервера в одному файліmodel: RedHatAI/Qwen3.5-4B-FP8-dynamic# Під цим іменем модель бачать клієнтиserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 8000
# Пам'ять: найдовший діалог і кількість одночасних запитівmax-model-len: 16384max-num-seqs: 16
# Відокремлювати міркування моделі від відповідіreasoning-parser: qwen3# Перетворювати текст моделі на виклики функційenable-auto-tool-choice: truetool-call-parser: qwen3_xml
# Показувати у відповіді, скільки токенів промпта взято з кешуenable-prompt-tokens-details: true# Повертати ідентифікатор запиту в заголовку X-Request-Idenable-request-id-headers: truedocker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml- Довідка:
vllm serve --help=all— усе,--help=max-num-seqs— один прапорець. - Вкладені налаштування — через крапку:
--logging-config.formatter json. - Короткий запис чисел:
--max-model-len 16K— це 16 384. ВеликаK— 1024, малаk— 1000. - Параметри генерації з моделі. Сервер застосовує
generation_config.jsonз теки моделі. Вимикається прапорцем--generation-config vllm. - Змінні середовища:
HF_TOKEN,VLLM_API_KEY,VLLM_LOGGING_LEVEL,VLLM_NO_USAGE_STATS=1(відмова від телеметрії). - Kubernetes: не називайте сервіс
vllm. Kubernetes створить змінні з префіксомVLLM_, і сервер сприйме їх за свої налаштування.
SGLang: налаштування
# SGLang 0.5.23 — налаштування сервера в одному файлі.# Модель задається в командному рядку: sglang serve <модель> --config config.yaml# Під цим іменем модель бачать клієнтиserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 30000
# Пам'ять: найдовший діалог і частка відеопам'яті під ваги та кеш діалогівcontext-length: 16384mem-fraction-static: 0.8
# Відокремлювати міркування моделі від відповідіreasoning-parser: qwen3# Перетворювати текст моделі на виклики функційtool-call-parser: qwen3_coder
# Віддавати метрики для Prometheus за адресою /metricsenable-metrics: true# Показувати у відповіді, скільки токенів промпта взято з кешуenable-cache-report: truedocker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123- Модель — лише в командному рядку. З
model-pathу файлі й без моделі в командіsglang serveпадає:Error: --model-path is required. - Ключ доступу — лише прапорцем
--api-key. - Команда запуску:
sglang serve. Попередняpython -m sglang.launch_serverще працює і трапляється в більшості інструкцій. - Метрики вимкнені без
--enable-metrics. - Кількість токенів із кешу у відповіді — лише з
--enable-cache-report. - Імена розбірників інші: для тієї самої моделі у vLLM
qwen3_xml, тутqwen3_coder. - Довідка надійніша за документацію: 91 прапорець у таблиці документації не описаний. Дивіться
sglang serve --help. - Змінні середовища:
HF_TOKEN,SGLANG_CACHE_DIR(тека скомпільованих ядер, підключіть її томом),SGLANG_LOGGING_CONFIG_PATH(власний формат журналу).
API
Обидва сервери повторюють API OpenAI. Бібліотека openai працює з ними без змін: змінюється адреса. Приклади нижче запускалися з обома серверами без правок.
# vLLMexport BASE_URL=http://localhost:8000/v1 API_KEY=sk-lab-123# SGLangexport BASE_URL=http://localhost:30000/v1 API_KEY=sk-lab-123Звичайний запит. Міркування приходять окремо від відповіді:
import os
from openai import OpenAI
# Один і той самий код працює з обома серверами: змінюється лише адреса.# vLLM: http://localhost:8000/v1, SGLang: http://localhost:30000/v1client = OpenAI(    base_url=os.environ["BASE_URL"],    api_key=os.environ["API_KEY"],)
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {"role": "system", "content": "You are a concise assistant."},        {            "role": "user",            "content": "What is a KV cache in LLM inference? Answer in two sentences.",        },    ],    max_tokens=2048,)
message = response.choices[0].message# Міркування приходять окремим полем: у vLLM воно називається reasoning,# у SGLang — reasoning_contentreasoning = getattr(message, "reasoning", None) or getattr(message, "reasoning_content", None)print("REASONING:", (reasoning or "")[:200].replace("\n", " "), "...")print("ANSWER:", message.content.strip())print("USAGE:", response.usage.prompt_tokens, "+", response.usage.completion_tokens)
REASONING: Thinking Process: 1. **Analyze the Request:** * Topic: KV cache ...ANSWER: A KV cache stores the attention key-value pairs for all previous tokens, allowing the model to retrieve context without re-computing layer activations. This reuse significantly reduces the computational cost and latency of autoregressive inference, particularly when generating long sequences of text.USAGE: 36 + 1565Відповідь із двох речень коштувала 1565 токенів: майже все пішло на міркування. З малим max_tokens модель, що міркує, не доходить до відповіді, і content приходить порожнім.
Потік, вимкнення міркувань, замір TTFT:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
started = time.perf_counter()first_token_at = Nonetokens = 0
stream = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": "Explain in three sentences why one GPU can serve many LLM requests at once.",        }    ],    max_tokens=300,    stream=True,    # Попросити сервер надіслати наприкінці потоку лічильники токенів    stream_options={"include_usage": True},    # Вимкнути міркування: параметр іде в шаблон чату моделі    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
for chunk in stream:    if chunk.usage:        tokens = chunk.usage.completion_tokens    if not chunk.choices:        continue    piece = chunk.choices[0].delta.content    if piece:        if first_token_at is None:            first_token_at = time.perf_counter()        print(piece, end="", flush=True)
total = time.perf_counter() - startedttft = first_token_at - startedspeed = tokens / (total - ttft)print(f"\n\nTTFT: {ttft * 1000:.0f} ms, tokens: {tokens}, speed: {speed:.0f} tokens/s")
vLLM: TTFT: 71 ms, tokens: 93, speed: 84 tokens/sSGLang: TTFT: 82 ms, tokens: 93, speed: 56 tokens/sВиклик функцій. Модель називає функцію й аргументи, викликає її ваш код:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Опис функції, яку моделі дозволено викликатиtools = [    {        "type": "function",        "function": {            "name": "get_gpu_memory",            "description": "Returns used and total memory of a GPU in megabytes.",            "parameters": {                "type": "object",                "properties": {                    "gpu_index": {                        "type": "integer",                        "description": "Index of the GPU, starting from 0",                    },                },                "required": ["gpu_index"],            },        },    }]
messages = [{"role": "user", "content": "How much memory is free on GPU 0?"}]
# 1. Модель вирішує, що потрібна функція, і повертає її ім'я та аргументиfirst = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)call = first.choices[0].message.tool_calls[0]print("CALL:", call.function.name, call.function.arguments)
# 2. Функцію виконує наш код, а не сервер; тут відповідь підставлено вручнуresult = {"used_mb": 9896, "total_mb": 12227}messages.append(first.choices[0].message)messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
# 3. Модель отримує результат і відповідає людиніsecond = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)print("ANSWER:", second.choices[0].message.content.strip())
CALL: get_gpu_memory {"gpu_index": 0}ANSWER: GPU 0 has approximately **2.3 GB** free memory.Відповідь за схемою. Сервер забороняє моделі токени, що порушують схему, і відповідь завжди виходить правильним JSON:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Схема, якій зобов'язана відповідати відповідьschema = {    "type": "object",    "properties": {        "component": {"type": "string", "enum": ["memory", "network", "model", "other"]},        "severity": {"type": "string", "enum": ["low", "medium", "high"]},        "summary": {"type": "string"},    },    "required": ["component", "severity", "summary"],    "additionalProperties": False,}
log_line = "RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache."
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "system",            "content": "Classify the log line of an inference server. Keep the summary under 20 words.",        },        {"role": "user", "content": log_line},    ],    # Сервер не дасть моделі вибрати токен, що порушує схему    response_format={        "type": "json_schema",        "json_schema": {"name": "incident", "schema": schema, "strict": True},    },    max_tokens=300,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
incident = json.loads(response.choices[0].message.content)print(incident)
{'component': 'memory', 'severity': 'high', 'summary': 'GPU memory insufficient for hybrid attention cache.'}Картинка на вході:
import base64import os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Картинка йде в запиті у вигляді рядка base64with open("dashboard.png", "rb") as file:    image = base64.b64encode(file.read()).decode()
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": [                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image}"}},                {"type": "text", "text": "What does this picture show? Answer in two sentences."},            ],        }    ],    max_tokens=200,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
print(response.choices[0].message.content.strip())print("prompt tokens:", response.usage.prompt_tokens)
Картинка 1200×630 займає 785 токенів промпта в обох серверах.
vLLM: що є крім API OpenAI
- Responses API:
/v1/responses. - Anthropic Messages API:
/v1/messages. Так підключається Claude Code (інструкція). - Ембедінги, переранжування, розпізнавання мовлення.
- Токенізатор:
/tokenize,/detokenize. - gRPC:
vllm serve --grpc. - Поле з міркуваннями:
reasoning. - Заголовок
X-Request-Id: сервер приймає ідентифікатор запиту від клієнта і повертає його у відповіді. - Ключ — лише в
Authorization: Bearer. Заголовокx-api-key, який шлють клієнти Anthropic, не приймається: відповідь 401.
SGLang: що є крім API OpenAI
- Responses API і Anthropic Messages API — на тих самих адресах.
x-api-keyтеж не приймається. - API Ollama:
/api/chat,/api/generate,/api/tags. - Ембедінги, переранжування, розпізнавання мовлення, токенізатор.
- Запуск без HTTP:
sgl.Engine(model_path=...)у коді на Python. У vLLM для цього класLLM. - Поле з міркуваннями:
reasoning_content. Це єдине місце, де клієнтові потрібно знати, з яким сервером він розмовляє. - Власний API
/generate— сирий текст без шаблону чату:
curl http://localhost:30000/generate \ -H "Authorization: Bearer sk-lab-123" -H "Content-Type: application/json" \ -d '{"text": "The capital of Bulgaria is", "sampling_params": {"max_new_tokens": 8, "temperature": 0}}'{ "text": " Sofia. Sofia is the largest city in", "meta_info": { "finish_reason": {"type": "length", "length": 8}, "prompt_tokens": 5, "completion_tokens": 8, "cached_tokens": 0 }}Відповідь скорочено: у справжній ще два десятки службових полів.
Сесії та стан
Обидва сервери не зберігають діалоги. Клієнт у кожному запиті надсилає всю історію.
Щоб не читати історію заново на кожному кроці, працює кеш префіксів: сервер зберігає пам'ять діалогу після відповіді й бере з неї збіжний початок наступного запиту. Кеш увімкнений за замовчуванням і не прив'язаний до користувача: збіг шукається за текстом.
Діалог із чотирьох ходів із системним промптом на 2000 токенів:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Довгий системний промпт: близько 2000 токенів правил, однакових для всіх запитівrules = "\n".join(    f"Rule {n}: when the user asks about topic {n}, answer politely and mention the number {n * 7}."    for n in range(1, 81))messages = [{"role": "system", "content": "You are a support assistant.\n" + rules}]
questions = [    "What does rule 5 say?",    "And rule 12?",    "Which rule mentions the number 140?",    "Thanks. Summarize our conversation in one sentence.",]
for turn, question in enumerate(questions, start=1):    messages.append({"role": "user", "content": question})
    started = time.perf_counter()    first_token_at = None    answer = ""    usage = None    stream = client.chat.completions.create(        model="qwen3.5-4b",        messages=messages,        max_tokens=120,        stream=True,        stream_options={"include_usage": True},        extra_body={"chat_template_kwargs": {"enable_thinking": False}},    )    for chunk in stream:        if chunk.usage:            usage = chunk.usage        if chunk.choices and chunk.choices[0].delta.content:            if first_token_at is None:                first_token_at = time.perf_counter()            answer += chunk.choices[0].delta.content
    # Сервер не пам'ятає діалог: історію щоразу надсилає клієнт    messages.append({"role": "assistant", "content": answer})
    details = usage.prompt_tokens_details    cached = details.cached_tokens if details else 0    ttft = (first_token_at - started) * 1000    prompt = usage.prompt_tokens    print(f"turn {turn}: prompt {prompt} tokens, from cache {cached}, TTFT {ttft:.0f} ms")
vLLM:
turn 1: prompt 2157 tokens, from cache 0, TTFT 339 msturn 2: prompt 2202 tokens, from cache 1728, TTFT 84 msturn 3: prompt 2253 tokens, from cache 1728, TTFT 155 msturn 4: prompt 2320 tokens, from cache 1728, TTFT 103 msSGLang:
turn 1: prompt 2157 tokens, from cache 0, TTFT 341 msturn 2: prompt 2210 tokens, from cache 2112, TTFT 61 msturn 3: prompt 2266 tokens, from cache 2176, TTFT 55 msturn 4: prompt 2323 tokens, from cache 2240, TTFT 48 msІз другого ходу обидва відповідають у кілька разів швидше:
SGLang бере з кешу майже все, vLLM — 1728 токенів на кожному ході:
vLLM: кеш і стан
Пристрій. Пам'ять діалогів нарізана на блоки. Сервер рахує хеш кожного заповненого блока разом з усім, що було до нього, і порівнює новий запит із кешем блок за блоком. Незаповнений блок у кеш не потрапляє.
Розмір блока — 64 токени (до версії 0.34 — 16). У гібридних моделей більший: у Qwen3.5 — 576 токенів. Звідси 1728 у прикладі: це три блоки, а до четвертого діалог не дорос.
Наслідок. Спільний початок, коротший за блок, не кешується. За спільного системного промпта на 450 токенів vLLM із Qwen3.5 показав влучання в кеш 4%, SGLang на тому самому навантаженні — 87%. У звичайних моделей блок удев'ятеро менший, і такого розриву немає.
Як побачити роботу кешу:
- у відповіді:
usage.prompt_tokens_details.cached_tokens(прапорець--enable-prompt-tokens-details); - у метриках:
vllm:prefix_cache_hits_total,vllm:prefix_cache_queries_total; - у журналі:
Prefix cache hit rate, кожні десять секунд.
Ізоляція клієнтів. За часом відповіді можна зрозуміти, чи надсилав хтось такий самий початок запиту. Якщо клієнти не повинні нічого знати одне про одного, додайте в запити поле cache_salt, своє для кожного клієнта. Запити з різною сіллю не ділять блоки.
Зберігання відповідей на сервері (параметр previous_response_id у Responses API) вимкнене:
404 invalid_request_error, param: response_idResponse with id 'resp_123' not found.Вмикається змінною VLLM_ENABLE_RESPONSES_API_STORE=1. Відповіді лежать у пам'яті процесу, ніколи не видаляються і зникають під час перезапуску. Для продакшену не годиться: історію зберігає клієнт або шар перед сервером.
SGLang: кеш і стан
Пристрій. Кеш — дерево спільних початків (radix-дерево). Для нового запиту шукається найдовший збіг. Збіг точніший, ніж блоками: у прикладі 2112 токенів із 2210, і число зростає з кожним ходом. Коли пам'ять закінчується, видаляються гілки, до яких найдовше не зверталися (--radix-eviction-policy).
Як побачити роботу кешу:
- у відповіді: те саме поле
cached_tokens(прапорець--enable-cache-report); - у метриках:
sglang:cache_hit_rate,sglang:cached_tokens_total; - у журналі, у рядку кожного прочитаного промпта:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80, #running-req: 3, #queue-req: 1Із 517 токенів промпта 448 узято з кешу.
Захист кешу діалогу: прапорець --enable-session-radix-cache і поле session_id у запиті. Гілки цього діалогу видаляються в останню чергу. Історію, як і раніше, надсилає клієнт.
Сесії на сервері. Через власний API можна відкрити сесію (/open_session) і надсилати лише новий текст: сервер допише його до збереженого контексту. Зроблено для навчання з підкріпленням і агентів, працює лише через /generate. На стенді не запускалося.
Зберігання відповідей на сервері теж вимкнене:
400 invalid_request_error, param: previous_response_idResponse store is disabled. Stateful Responses require --enable-response-store on a standalone server; response storage is unavailable in PD mode.З --enable-response-store вмикається. Обмеження ті самі, що у vLLM: пам'ять процесу, без терміну зберігання, після перезапуску порожньо.
Мережа і безпека
Жоден із двох серверів не розрахований на те, щоб стояти в інтернеті без захисту. Ключ доступу є в обох, але закриває не все. Перед сервером ставлять зворотний проксі й пропускають назовні лише потрібні адреси.
- Проксі: TLS, ключі, обмеження кількості запитів, список дозволених адрес.
- Маршрутизатор: вибирає копію сервера (наступний розділ).
- Сервери моделей і моніторинг — у внутрішній мережі.
Налаштування nginx для одного сервера:
upstream llm {    server vllm:8000;    # Тримати з'єднання з сервером моделі відкритими    keepalive 32;}
server {    listen 80;    # Запити з картинками бувають великими    client_max_body_size 20m;
    # Назовні відкритий лише API для клієнтів    location /v1/ {        proxy_pass http://llm;        proxy_http_version 1.1;        proxy_set_header Connection "";        proxy_set_header Host $host;        # Один ідентифікатор запиту в журналах проксі та сервера моделі        proxy_set_header X-Request-Id $request_id;        # Без цього проксі збирає відповідь і віддає її одним шматком        proxy_buffering off;        # Довга відповідь може йти хвилини        proxy_read_timeout 600s;    }
    # Перевірка живості для балансувальника    location = /health {        proxy_pass http://llm;        access_log off;    }
    # Усе інше, включно з /metrics, /invocations і /docs, ззовні недоступне    location / {        return 404;    }}
proxy_buffering off— інакше замість тексту по словах користувач отримає паузу і всю відповідь одразу.proxy_read_timeout 600s— за замовчуванням nginx розриває з'єднання після 60 секунд тиші.location / { return 404; }— назовні виходить лише те, що перелічено явно.- Для продакшену додайте
listen 443 sslі сертифікати. Для SGLang замініть адресу наsglang:30000.
Що відповідає сервер на запит без ключа, коли ключ заданий:
| Адреса | vLLM | SGLang |
|---|---|---|
/health | 200 | 200 |
/metrics | 200 | 200 |
/docs, /openapi.json | 200 | 401 |
/version | 200 | — |
/v1/models, /v1/chat/completions | 401 | 401 |
POST /invocations (генерація) | 200 | — |
POST /tokenize | 200 | 401 |
| відомості про сервер, скидання кешу | — | 401 |
vLLM: мережа і безпека
- Адреса і порт:
--host,--port(за замовчуванням усі інтерфейси, 8000),--udsдля сокета Unix,--root-pathдля проксі не в корені сайту. - Ключ:
--api-keyабоVLLM_API_KEY. Можна кілька:--api-key k1 k2. - Ключ закриває лише
/v1і кілька службових префіксів. /invocationsгенерує без ключа. Адресу зроблено для AWS SageMaker, і вона приймає ті самі запити, що/v1/chat/completions:
curl -X POST http://localhost:8000/invocations \ -H "Content-Type: application/json" \ -d '{"model": "qwen3.5-4b", "messages": [{"role": "user", "content": "Say OK"}], "max_tokens": 5, "chat_template_kwargs": {"enable_thinking": false}}'{ "id": "chatcmpl-ab039d14c5d03cbf", "object": "chat.completion", "model": "qwen3.5-4b", "choices": [{"index": 0, "message": {"role": "assistant", "content": "OK"}}]}Це задокументована поведінка: сторінка про безпеку в документації vLLM перелічує /invocations серед незахищених адрес. Назовні — лише через проксі.
- TLS:
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh(перечитувати сертифікати),--ssl-cert-reqs(перевіряти сертифікат клієнта). - CORS: з версії 0.32 запити з чужих сайтів заборонені. Дозволені сайти —
--allowed-origins. - Зв'язок між вузлами не шифрується. Вузли тримають в ізольованій мережі.
- Картинки за посиланнями: сервер сам завантажує картинку за адресою із запиту, і так його можна спрямувати на внутрішні адреси мережі. Обмеження —
--allowed-media-domains. - Телеметрія: сервер надсилає розробникам анонімну статистику (відеокарта, архітектура моделі, версія, частина налаштувань; текстів запитів немає). Вимикається
VLLM_NO_USAGE_STATS=1абоDO_NOT_TRACK=1.
SGLang: мережа і безпека
- Адреса і порт:
--host,--port. За замовчуванням127.0.0.1:30000— лише з тієї самої машини. - Два ключі:
--api-keyдля клієнтів,--admin-api-keyдля керування (оновлення ваг, скидання кешу, відомості про сервер). - Без ключа відкриті лише перевірки стану та метрики.
/get_server_infoвіддає ключ. У відповіді всі налаштування сервера, включно зapi_keyвідкритим текстом. Запит вимагає ключа, але кожен клієнт із ключем бачить усі налаштування. З--admin-api-keyадреса закривається для клієнтів.- Без
--api-keyвідкрито все: усі 108 операцій, включно із завантаженням адаптерів і оновленням ваг. - CORS відкритий для всіх сайтів. Це прописано в коді, прапорця для обмеження немає.
- TLS: ті самі
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh. HTTP/2 —--enable-http2. - Зв'язок між вузлами не шифрується.
- Картинки за посиланнями:
--allowed-media-domains. Без нього сервер завантажує з будь-якої адреси. - Телеметрія: немає.
Кілька копій і маршрутизація
Коли однієї відеокарти замало, запускають кілька копій сервера й роздають запити між ними. Кеш префіксів у кожної копії свій. Якщо наступний хід діалогу потрапить на іншу копію, вона прочитає всю історію заново. Тому для серверів моделей є маршрутизатори, які надсилають запит туди, де його початок уже в кеші.
Замір на стенді: дві копії Qwen3.5-0.8B на одній відеокарті, шість діалогів по п'ять ходів із довгим системним промптом.
| Сервер | Роздача запитів | Токенів промпта з кешу |
|---|---|---|
| vLLM | одна копія | 59% |
| vLLM | nginx, менш завантаженому | 34% |
| vLLM | vLLM Router, з урахуванням кешу | 52% |
| SGLang | маршрутизатор, по колу | 53% |
| SGLang | маршрутизатор, з урахуванням кешу | 73% |
Роздача без урахування кешу забирає у vLLM майже половину влучань. Тест маленький (30 запитів), частки від прогону до прогону трохи змінюються.
vLLM: копії і маршрутизація
nginx — варіант із документації vLLM. Змінюється початок налаштування з розділу про мережу:
upstream llm { # Новий запит іде до того сервера, у якого менше відкритих з'єднань least_conn; server vllm-a:8000 max_fails=3 fail_timeout=30s; server vllm-b:8000 max_fails=3 fail_timeout=30s; keepalive 32;}vLLM Router — маршрутизатор на Rust від команди vLLM. Виріс із маршрутизатора SGLang (анонс).
pip install vllm-router==0.1.17vllm-router \ --worker-urls http://vllm-a:8000 http://vllm-b:8000 \ --policy cache_aware \ --host 0.0.0.0 --port 8090Правила роздачі (--policy):
| Значення | Як роздає |
|---|---|
round_robin | по колу |
random | випадково |
power_of_two | менш завантаженому з двох випадкових |
consistent_hash | за хешем запиту |
sticky_least_loaded | менш завантаженому, із закріпленням діалогу |
cache_aware | туди, де початок запиту в кеші |
kv_aware | за відомостями про кеш від самих серверів |
Ще вміє: повтор невдалих запитів, виключення копії, що збоїть, пошук копій у Kubernetes.
Production Stack — набір для Kubernetes від тієї самої команди: маршрутизатор, сервери, моніторинг, ставиться через Helm. На стенді не запускався.
Шари для кластерів: llm-d, AIBrix, NVIDIA Dynamo, KServe — для кожного є сторінка в документації vLLM.
SGLang: копії і маршрутизація
Маршрутизатор лежить в образі сервера:
docker run -d --name sglang-router --network lab -p 30010:30000 \ --entrypoint python lmsysorg/sglang:v0.5.23-runtime \ -m sglang_router.launch_router \ --worker-urls http://sglang-a:30000 http://sglang-b:30000 \ --policy cache_aware \ --host 0.0.0.0 --port 30000 --prometheus-port 29000Правила роздачі: round_robin, random, power_of_two, cache_aware, consistent_hashing, prefix_hash, bucket, manual. Ще вміє: повтор запитів, виключення копій, що збоять, обмеження кількості одночасних запитів, пошук копій у Kubernetes. Власні метрики віддає на окремому порту.
Маршрутизаторів у SGLang зараз три:
| Проєкт | Пакет | Стан |
|---|---|---|
| SGLang Model Gateway | sglang-router | в образі й у документації; пакет не оновлювався з січня 2026 |
| SMG | smg | продовження першого в окремому репозиторії; працює й з vLLM |
| sgl-router | sgl-router | новий полегшений, перша версія 18 листопада 2026 |
Перед вибором перевірте, який із них розвивається.
Копії всередині одного сервера: --dp-size N. Документація для цього випадку сама радить маршрутизатор.
Шари для кластерів: llm-d, AIBrix, Dynamo і власний оператор для Kubernetes — OME.
Спостережуваність
- Метрики — лічильники й часи у форматі Prometheus за адресою
/metricsна основному порту. - Журнали — що сервер робить, за бажанням кожен запит.
- Трасування — шлях одного запиту за кроками, за стандартом OpenTelemetry.
Часи, які показують метрики й траси:
Prometheus, Grafana і Jaeger поряд із серверами:
# Prometheus, Grafana і Jaeger поряд із серверами моделей.# Мережа lab створена заздалегідь: docker network create labservices:  prometheus:    image: prom/prometheus:latest    container_name: prometheus    volumes:      - ./prometheus.yaml:/etc/prometheus/prometheus.yml:ro    ports:      - "9090:9090"    networks: [lab]
  grafana:    image: grafana/grafana:latest    container_name: grafana    environment:      # Вхід без пароля — лише для стенда на власному комп'ютері      - GF_AUTH_ANONYMOUS_ENABLED=true      - GF_AUTH_ANONYMOUS_ORG_ROLE=Admin    volumes:      # Джерело даних і дашборди підключаються самі під час старту      - ./provisioning:/etc/grafana/provisioning:ro      - ./dashboards:/var/lib/grafana/dashboards:ro    ports:      - "3000:3000"    networks: [lab]    depends_on: [prometheus]
  jaeger:    image: jaegertracing/jaeger:latest    container_name: jaeger    ports:      - "16686:16686" # веб-інтерфейс      - "4317:4317"   # приймання трас по OTLP gRPC      - "4318:4318"   # приймання трас по OTLP HTTP    networks: [lab]
networks: lab: external: trueglobal: scrape_interval: 5s
scrape_configs: # Обидва сервери віддають метрики за адресою /metrics на своєму основному порту - job_name: vllm static_configs: - targets: ["vllm:8000"]
- job_name: sglang static_configs: - targets: ["sglang:30000"]Два файли, щоб Grafana сама підключила Prometheus і дашборди з теки:
apiVersion: 1datasources: - name: Prometheus uid: prometheus type: prometheus access: proxy url: http://prometheus:9090 isDefault: trueapiVersion: 1providers: - name: lab type: file options: path: /var/lib/grafana/dashboardsГрафіки нижче зняті під однаковим навантаженням: вісім клієнтів без пауз, спільний системний промпт, Qwen3.5-4B у FP8, чотири хвилини.
vLLM: метрики, журнали, трасування
Метрики ввімкнені завжди.
| Метрика | Що показує |
|---|---|
vllm:num_requests_running | запитів виконується |
vllm:num_requests_waiting | запитів у черзі. Головний сигнал для додавання копій |
vllm:kv_cache_usage_perc | заповненість пам'яті діалогів, 0–1 |
vllm:time_to_first_token_seconds | час до першого токена |
vllm:inter_token_latency_seconds | пауза між токенами |
vllm:e2e_request_latency_seconds | час запиту цілком |
vllm:prompt_tokens_total, vllm:generation_tokens_total | прочитано й написано токенів |
vllm:prefix_cache_hits_total, vllm:prefix_cache_queries_total | влучання в кеш префіксів |
vllm:num_preemptions_total | витіснення запитів через брак пам'яті |
vllm:request_success_total | завершені запити з причиною завершення |
Дашборд — у репозиторії: examples/observability/prometheus_grafana/grafana.json. Він розрахований на ручний імпорт; для автоматичного підключення замініть змінну джерела даних:
sed -i 's/${DS_PROMETHEUS}/prometheus/g' monitoring/dashboards/vllm.json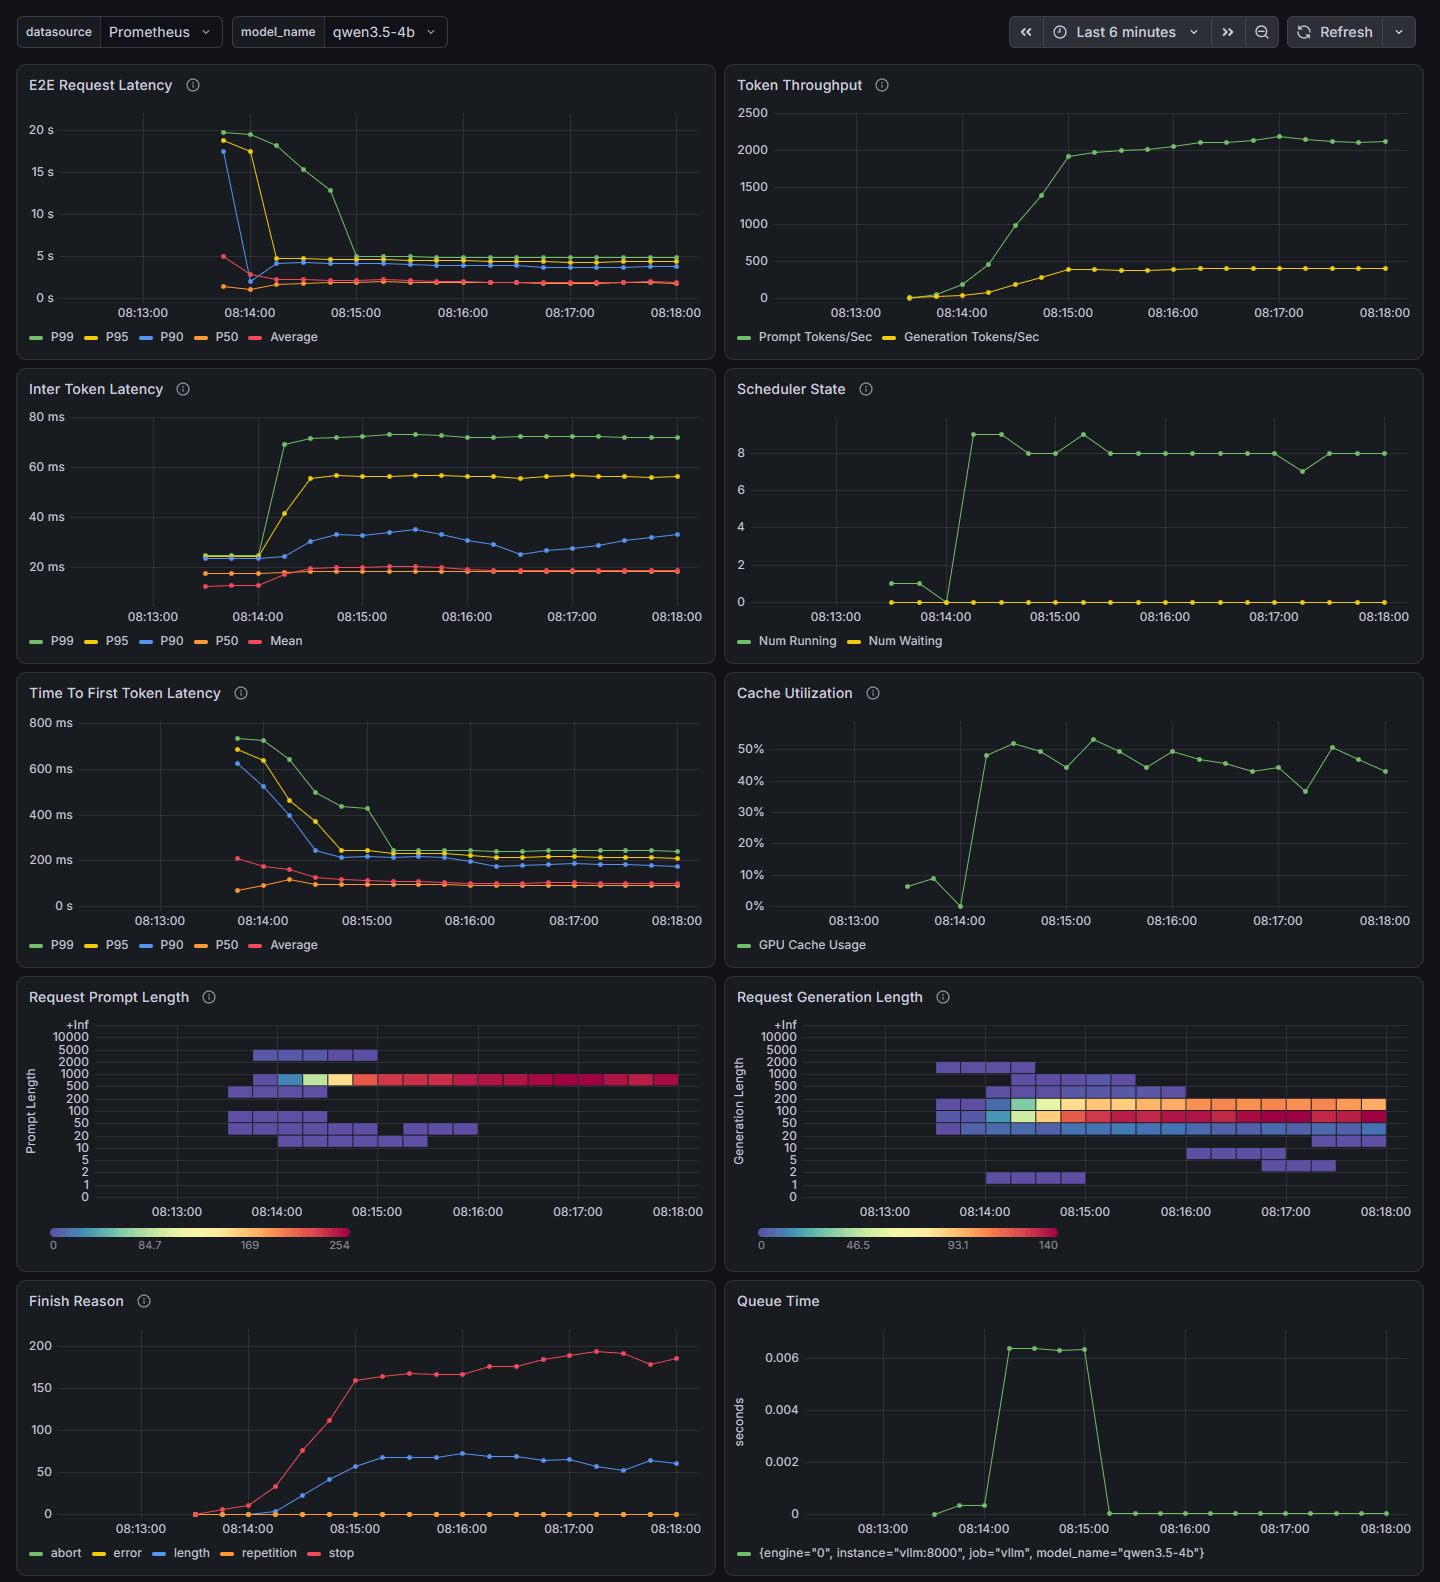
На графіках: вісім запитів виконуються, черги немає; близько 400 токенів за секунду на виході; перший токен у середньому через 0,1 секунди; пам'ять діалогів заповнена наполовину.
Журнал. Кожні десять секунд — рядок із підсумками:
Engine 000: Avg prompt throughput: 1913.3 tokens/s, Avg generation throughput: 371.4 tokens/s, Running: 9 reqs, Waiting: 0 reqs, GPU KV cache usage: 49.4%, Prefix cache hit rate: 3.6%| Прапорець | Що робить |
|---|---|
--enable-log-requests | рядок про кожен запит: ідентифікатор і параметри. Тексти — лише на рівні DEBUG |
--enable-log-outputs | писати й відповіді |
--max-log-len | обрізати довгі тексти |
--disable-access-log-for-endpoints /health,/metrics | не писати про перевірки стану |
--logging-config.formatter json | журнал у JSON |
Рядок журналу в JSON:
{ "asctime": "2026-11-21 06:22:43,840", "levelname": "INFO", "name": "vllm.v1.core.kv_cache_utils", "processName": "EngineCore", "process": 99, "message": "GPU KV cache size: 171,008 tokens, ..."}Трасування. Бібліотеки вже в образі. Потрібні адреса приймача і дві змінні:
docker run --gpus all --ipc=host -p 8000:8000 --network lab --name vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ -e OTEL_SERVICE_NAME=vllm \ -e OTEL_EXPORTER_OTLP_TRACES_INSECURE=true \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml \ --otlp-traces-endpoint grpc://jaeger:4317 --enable-log-requestsНа кожен запит vLLM пише один запис із готовими числами:
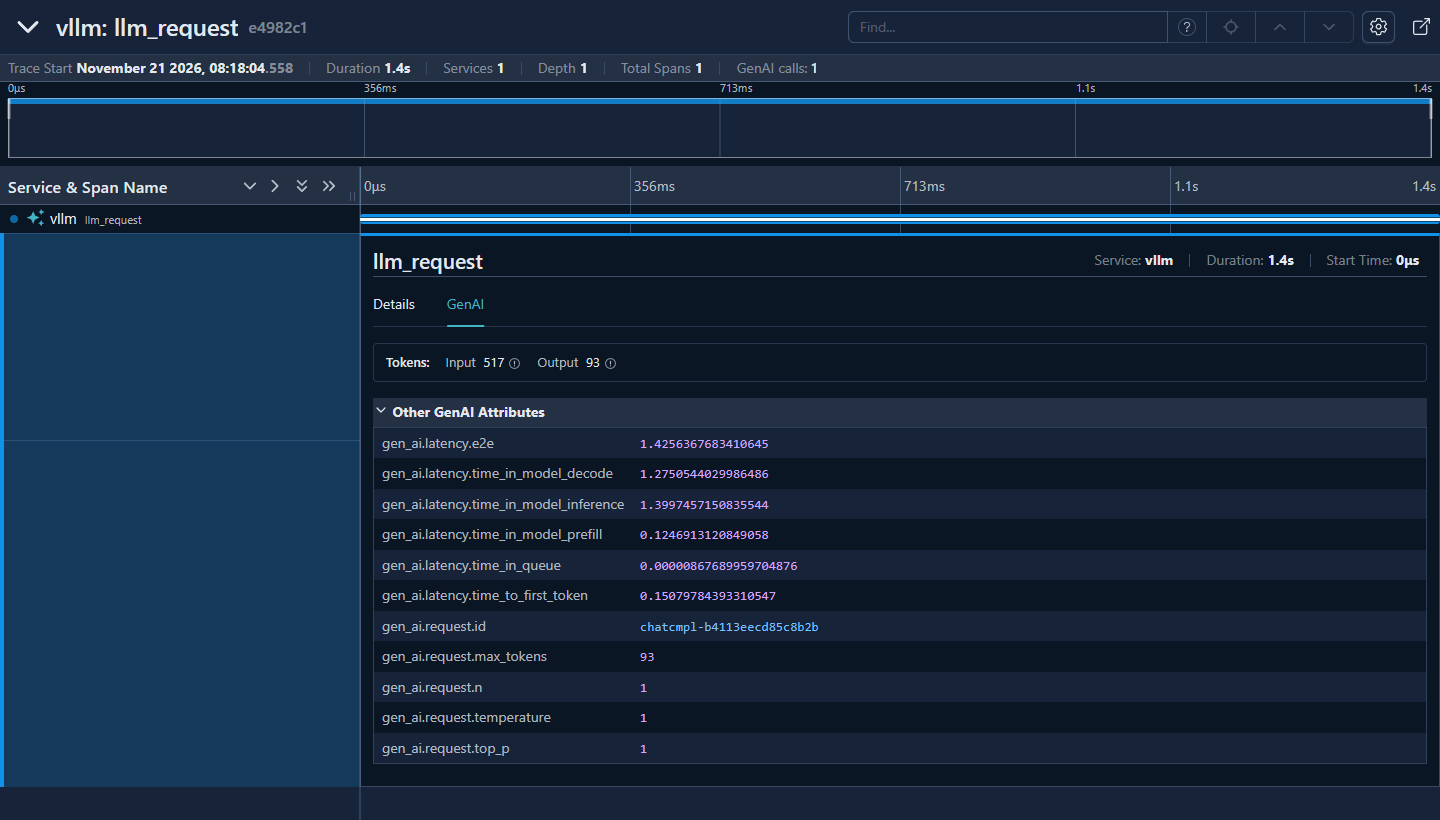
Промпт із 517 токенів читався 0,12 секунди, відповідь із 93 токенів писалася 1,28 секунди, перший токен прийшов через 0,15 секунди. Імена полів — із угоди OpenTelemetry для генеративного ШІ.
SGLang: метрики, журнали, трасування
Метрики вмикаються прапорцем --enable-metrics.
| Метрика | Що показує |
|---|---|
sglang:num_running_reqs | запитів виконується |
sglang:num_queue_reqs | запитів у черзі |
sglang:token_usage | заповненість пам'яті діалогів |
sglang:mamba_usage | заповненість пам'яті стану в гібридних моделей |
sglang:time_to_first_token_seconds | час до першого токена |
sglang:inter_token_latency_seconds | пауза між токенами |
sglang:e2e_request_latency_seconds | час запиту цілком |
sglang:gen_throughput | швидкість генерації, токенів за секунду |
sglang:cache_hit_rate | частка токенів промпта з кешу |
sglang:num_retracted_requests_total | зняті запити через брак пам'яті |
Дашборд — у репозиторії: examples/monitoring/grafana/dashboards/json/sglang-dashboard.json. У версії 0.5.23 він не показує дані:
Сервер публікує метрики з двокрапкою (sglang:num_running_reqs), а запити в дашборді написані з підкресленням (sglang_num_running_reqs). Виправлення:
sed -i 's/sglang_/sglang:/g' monitoring/dashboards/sglang.json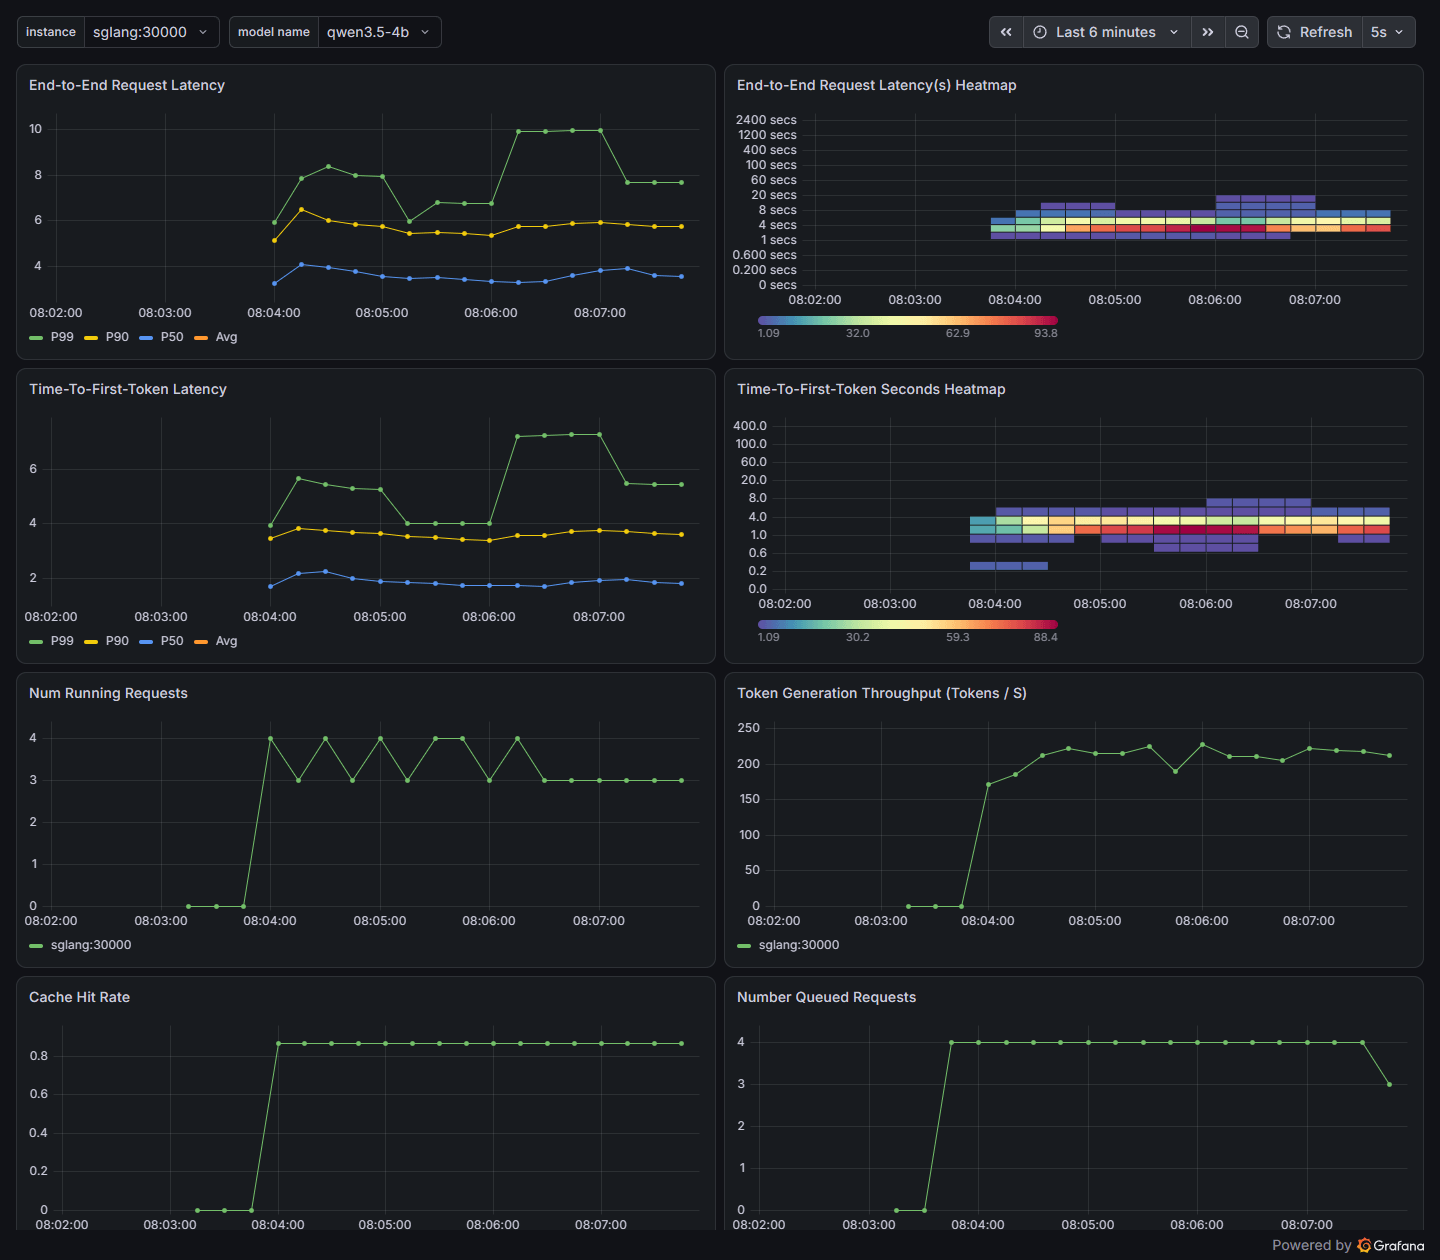
На графіках: чотири запити виконуються, чотири в черзі — більше на цій відеокарті з цією моделлю не вміщується; близько 215 токенів за секунду; перший токен через 2–4 секунди через чергу; влучання в кеш 0,87.
Журнал. Рядок на кожне читання промпта і раз на 40 кроків генерації:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80,Decode batch, #running-req: 4, #full token: 1011, full token usage: 0.03, mamba num: 16, mamba usage: 0.80, gen throughput (token/s): 217.87, #queue-req: 4Пам'ять діалогів майже порожня (full token usage: 0.03), пам'ять стану заповнена на 80% (mamba usage: 0.80). Вузьке місце — вона.
| Прапорець | Що робить |
|---|---|
--log-requests | писати про кожен запит |
--log-requests-level | докладність від 0 (метадані) до 3 (повні тексти) |
--log-requests-format json | записи про запити в JSON |
--log-requests-target | куди писати: консоль, тека або обидва |
--log-level, --log-level-http | докладність журналу сервера і HTTP |
Запис про запит у JSON, скорочений:
{ "timestamp": "2026-11-21T06:09:40.003283", "event": "request.finished", "rid": "369fb465a2ce4d5294e441b2e8fdba7f", "obj": { "sampling_params": {"temperature": 1.0, "max_new_tokens": 120, "top_p": 1.0}, "stream": true }}У JSON пишуться лише записи про запити. Решта журналу — текст; для JSON потрібен власний файл налаштування журналу (SGLANG_LOGGING_CONFIG_PATH).
Трасування:
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 --network lab --name sglang \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123 \ --enable-trace --otlp-traces-endpoint jaeger:4317 \ --log-requests --log-requests-level 1 --log-requests-format jsonSGLang пише дерево кроків:
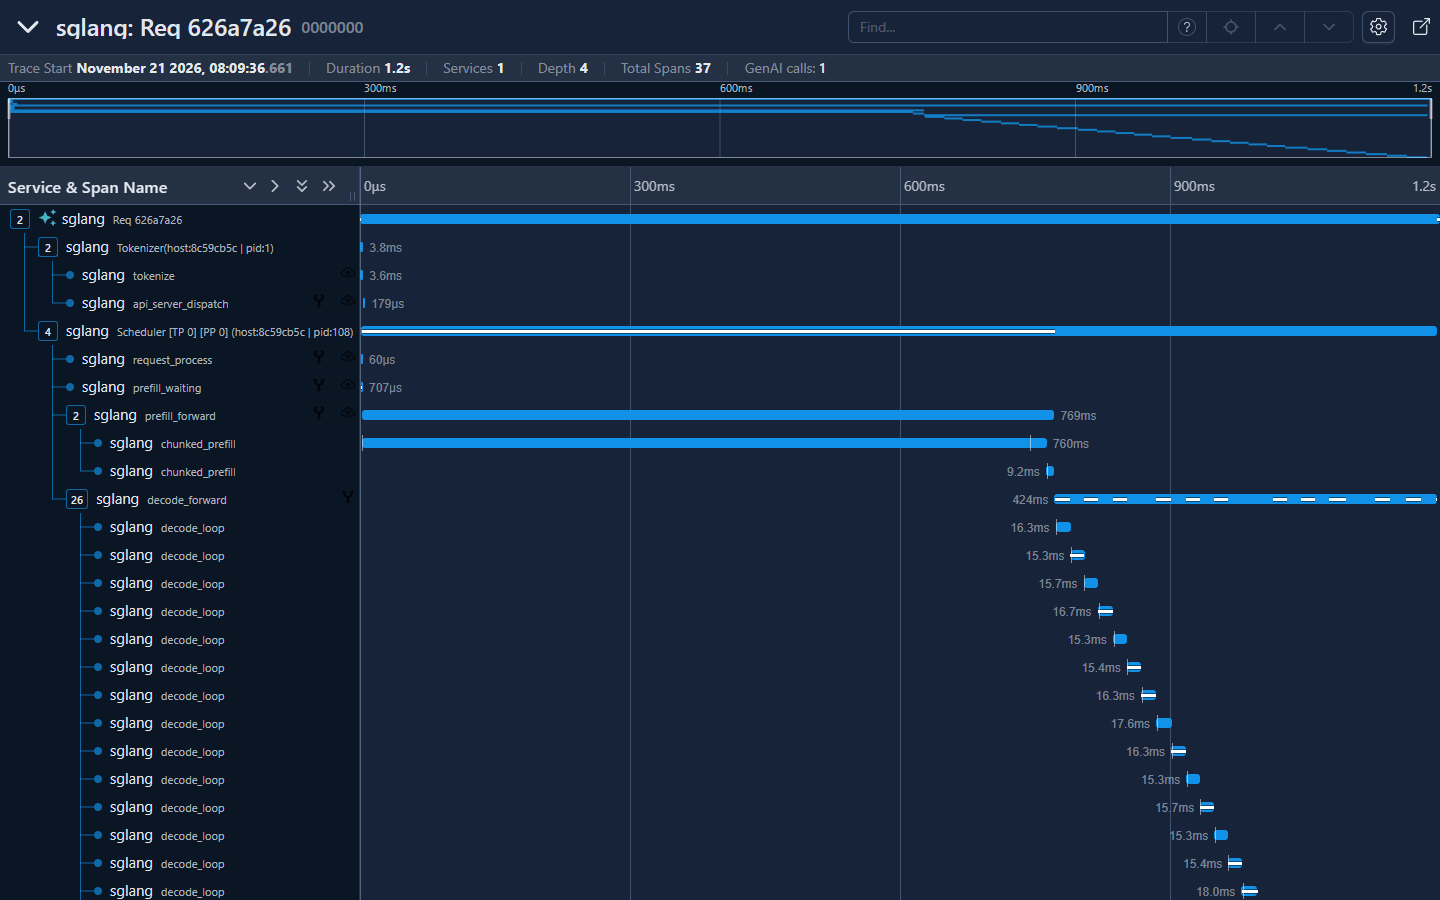
Токенізація — 3,6 мс, читання промпта з 2157 токенів — 769 мс, далі генерація порціями по 16 мс.
Запис vLLM легший: одна подія на запит. Дерево SGLang докладніше, але це десятки записів на запит; докладність знижується змінною SGLANG_TRACE_LEVEL.
Перевірки стану
| vLLM | SGLang | |
|---|---|---|
| Процес живий | /health: 200 або 503 | /health |
| Сервер справді генерує | — | /health_generate: генерує один токен |
| Готовий приймати запити | — | /ready: 503 під час запуску, паузи й зупинки |
Поки модель завантажується, порт vLLM закритий. У Kubernetes потрібна стартова перевірка (startupProbe) із запасом у кілька хвилин, інакше под перезапускатиметься безкінечно.
Продуктивність
Спільної відповіді «хто швидший» немає. Незалежні заміри 2026 року розходяться:
- Winder.AI, вересень, H100, Qwen3.8-27B: SGLang попереду на 7%.
- Jarvislabs, травень, H100, моделі Qwen минулих поколінь: попереду vLLM.
- Яким публічним тестам вірити — в розділі про бенчмарки.
Замір на стенді:
- Модель: Qwen3.5-2B без стиснення.
- Клієнт:
vllm bench serveдля обох серверів. Промпт — 512 випадкових токенів, відповідь — 256 токенів. На кожному рівні нові промпти. - vLLM:
--max-model-len 8192 --max-num-seqs 64. - SGLang: з налаштуваннями за замовчуванням і налаштований.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name random --random-input-len 512 --random-output-len 256 \ --num-prompts 96 --max-concurrency 16 --ignore-eos --seed 42185Швидкість генерації, токенів за секунду:
| Одночасних запитів | vLLM | SGLang за замовчуванням | SGLang налаштований |
|---|---|---|---|
| 1 | 110 | 109 | 107 |
| 4 | 468 | 454 | 416 |
| 16 | 1382 | 753 | 1150 |
| 32 | 1756 | 783 | 1427 |
| 64 | 2415 | 756 | 1518 |
Медіанний час до першого токена, мілісекунди:
| Одночасних запитів | vLLM | SGLang за замовчуванням | SGLang налаштований |
|---|---|---|---|
| 1 | 43 | 45 | 46 |
| 4 | 134 | 154 | 157 |
| 16 | 293 | 400 | 361 |
| 32 | 306 | 7796 | 698 |
| 64 | 330 | 16 667 | 5529 |
Висновки:
- Для одного користувача сервери рівні.
- Батчинг працює в обох. 64 одночасні запити дають у vLLM у 22 рази більше тексту, ніж один.
- SGLang за замовчуванням обмежив себе 12 запитами: мало пам'яті під стан гібридної моделі. Решта запитів чекала в черзі.
- Після налаштування SGLang удвічі швидший (29 одночасних запитів), але vLLM не наздогнав.
Налаштований SGLang:
sglang serve Qwen/Qwen3.5-2B --host 0.0.0.0 \ --served-model-name qwen3.5-2b --context-length 8192 --enable-metrics \ --max-running-requests 64 --mamba-full-memory-ratio 4 \ --cuda-graph-max-bs-decode 64 --mem-fraction-static 0.72Запити зі спільним початком: чотири початки по 3000 токенів, по 24 запити на кожен, вісім одночасно.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name prefix_repetition \ --prefix-repetition-num-prefixes 4 --prefix-repetition-prefix-len 3000 \ --prefix-repetition-suffix-len 200 --prefix-repetition-output-len 100 \ --num-prompts 96 --max-concurrency 8 --ignore-eos --seed 43995| vLLM | SGLang | |
|---|---|---|
| Швидкість генерації, токенів за секунду | 689 | 653 |
| Медіанний час до першого токена | 141 мс | 172 мс |
| Токенів промпта з кешу | 86% | 92% |
На довгому спільному початку сервери рівні. Різниця видна на коротких збігах і в діалозі, який росте потроху (розділ про сесії).
Обмеження заміру:
- Ноутбук. На серверній карті з 80 ГБ пам'ять під стан не буде вузьким місцем.
- Гібридна модель. Відставання SGLang пов'язане з тим, як він розміщує її стан. На звичайних моделях буває навпаки.
- Пам'ять на межі. Налаштований SGLang зайняв 11,3 з 12 ГБ.
- Випадкові промпти — найгірший випадок для кешу.
Заміряйте обидва сервери на своїй моделі, своїй відеокарті й своєму навантаженні.
vLLM: що налаштовувати для швидкості
| Налаштування | Дія |
|---|---|
--max-num-seqs | стеля одночасних запитів. Більше — вища загальна швидкість, довша пауза між токенами в кожного |
--max-num-batched-tokens | токенів за крок. Менше — рівніші паузи, більше — швидший перший токен |
--performance-mode | готові набори: balanced, interactivity, throughput |
-O0 … -O3 | рівень оптимізації. -O0 — швидкий старт і повільна робота |
--spec-method, --spec-model, --spec-tokens | спекулятивне декодування |
том /root/.cache/vllm | кеш компіляції; без нього кожен новий контейнер компілює заново |
VLLM_WSL2_ENABLE_PIN_MEMORY=1 | під WSL2 близько 12% швидкості генерації, за заміром з обговорень проєкту. На стенді не перевірялося |
SGLang: що налаштовувати для швидкості
| Налаштування | Дія |
|---|---|
--max-running-requests | стеля одночасних запитів |
--cuda-graph-max-bs-decode | найбільший батч, для якого записано граф. На картах менше 20 ГБ — 8; понад це сервер працює без графа і повільніше |
--schedule-policy | порядок черги. fcfs — за часом надходження, lpm — спочатку з найдовшим збігом у кеші |
--schedule-conservativeness | обережність приймання запитів. Менше 1 — сміливіше |
--chunked-prefill-size | розмір шматків читання промпта |
--mamba-full-memory-ratio, --max-mamba-cache-size | пам'ять під стан гібридних моделей |
--speculative-algorithm | спекулятивне декодування |
SGLANG_CACHE_DIR і том | кеш скомпільованих ядер |
Правило з документації: пам'ять діалогів заповнена менш ніж на 90%, а черга не порожня — зменште --schedule-conservativeness.
Кілька відеокарт
Розділ написано за документацією, без запуску. Способи розкласти модель по картах описані в розділі про масштабування; тут — прапорці.
| Спосіб | vLLM | SGLang |
|---|---|---|
| Шари діляться між картами (TP) | --tensor-parallel-size | --tp-size |
| Шари по черзі на різних картах (PP) | --pipeline-parallel-size | --pp-size |
| Копії моделі (DP) | --data-parallel-size | --dp-size |
| Експерти MoE по картах (EP) | --enable-expert-parallel | --ep-size |
vLLM: кілька відеокарт
Чотири карти одного сервера:
vllm serve <модель> --tensor-parallel-size 4Два сервери по вісім карт, головний вузол і другий:
vllm serve <модель> --tensor-parallel-size 8 --pipeline-parallel-size 2 \  --nnodes 2 --node-rank 0 --master-addr <адреса головного вузла>
vllm serve <модель> --tensor-parallel-size 8 --pipeline-parallel-size 2 \ --nnodes 2 --node-rank 1 --master-addr <адреса головного вузла> --headless- Розділення prefill і decode по різних серверах є, але позначене експериментальним. Воно вирівнює затримки, а не збільшує загальну швидкість. У продакшені його роблять через llm-d, Dynamo або AIBrix.
- Вивантаження пам'яті діалогів в оперативну пам'ять:
--kv-offloading-size. - Автомасштабування в Kubernetes — за метрикою
vllm:num_requests_waiting. Завантаження процесора тут нічого не говорить.
SGLang: кілька відеокарт
Чотири карти одного сервера:
sglang serve <модель> --tp-size 4Два сервери по чотири карти:
sglang serve <модель> --tp-size 4 --nnodes 2 --node-rank 0 \  --dist-init-addr <адреса першого вузла>:50000
sglang serve <модель> --tp-size 4 --nnodes 2 --node-rank 1 \ --dist-init-addr <адреса першого вузла>:50000- Розділення prefill і decode — сильна сторона SGLang: сервери з
--disaggregation-mode prefillі--disaggregation-mode decode, перед ними маршрутизатор з--pd-disaggregation. - Багаторівневий кеш HiCache: пам'ять діалогів вивантажується в оперативну пам'ять і на диск.
- Великі моделі з експертами:
--attn-dp-size.
Оновлення
Обидві програми виходять кожні два тижні, і в кожній версії щось перейменовано або прибрано.
- Фіксуйте версію образу.
- Читайте розділ про несумісні зміни в примітках до випуску.
- Перевіряйте оновлення на копії з тією самою моделлю.
vLLM: оновлення
| Версія | Що зламалося |
|---|---|
| 0.34 | пам'ять діалогів рахується по-новому; блок кешу 64 токени замість 16 |
| 0.33 | прибрано збірки під CUDA 12 і два способи спекулятивного декодування |
| 0.32 | прибрано Python 3.10; запити з браузера з чужих сайтів заборонені |
| 0.31 | стиснення fp8 перейменовано на fp8_per_tensor |
- Документація відстає. У 0.34 сторінка встановлення називає збіркою за замовчуванням CUDA 12.9, хоча пакети зібрані під 13.0. Вірте
vllm serve --help=all. - Виклики функцій перевіряйте на своїх даних. У хостингу Ubicloud вони відповідали схемі у 92% випадків, доки не ввімкнули сувору перевірку на сервері (розбір).
SGLang: оновлення
| Версія | Що зламалося |
|---|---|
| 0.5.23 | маршрутизатор переїхав, його прапорці перейменовано |
| 0.5.22 | потрібен Python 3.11; --enable-dp-attention замінено на --attn-dp-size |
| 0.5.21 | прибрано кілька адрес API; шаблон чату із запиту відхиляється |
| 0.5.20 | прибрано збірки під CUDA 12 і 17 прапорців; сховище Responses API вимкнене |
- Застаріле прибирають через два випуски, тобто через місяць.
- Ставте оновлення безпеки. З 27 серпня по 9 вересня 2026 року сервіс Cloudflare на SGLang повернув у 155 відповідях дані інших клієнтів: помилка SGLang у режимі розділення фаз плюс неправильне налаштування пам'яті в Cloudflare (розбір). Виправлено в 0.5.20–0.5.22.
- Версію 1.0 оголошено у листопаді 2026 року, але ще не випущено.
Часті помилки
| Що відбувається | Причина | Що робити |
|---|---|---|
| Сервер не запускається, хоча модель менша за відеопам'ять | крім ваг потрібно 3–4 ГіБ | менша або стиснена модель; розділ про відеопам'ять |
| Замість відповіді приходять міркування | не заданий розбірник міркувань | --reasoning-parser |
| Виклик функції приходить текстом | не заданий розбірник викликів | --tool-call-parser |
| SGLang у контейнері не відповідає ззовні | слухає 127.0.0.1 | --host 0.0.0.0 |
SGLang: --model-path is required | модель указана лише у файлі налаштувань | модель в командному рядку |
SGLang: state cache is too small | мала частка пам'яті за замовчуванням | --mem-fraction-static 0.8 |
vLLM: max_num_seqs exceeds available Mamba cache blocks | забагато одночасних запитів для гібридної моделі | зменшити --max-num-seqs |
| Дашборд SGLang порожній | у запитах sglang_ замість sglang: | замінити імена метрик |
| vLLM відповідає без ключа | /invocations не захищений ключем | проксі зі списком адрес |
| Клієнт SGLang бачить ключ сервера | /get_server_info віддає налаштування | --admin-api-key |
| Спільний системний промпт не кешується у vLLM | він коротший за блок кешу | для гібридних моделей — промпт довший за 576 токенів |
| Відповідь через nginx приходить одним шматком | проксі буферизує | proxy_buffering off |
Що вибрати
| vLLM 0.34 | SGLang 0.5.23 | |
|---|---|---|
| Хто робить | PyTorch Foundation, Inferact | LMSYS, RadixArk |
| Ліцензія | Apache 2.0 | Apache 2.0 |
| Моделі й залізо | найширший вибір | трохи вужчий |
| Запуск на стенді | 155 секунд | 85–100 секунд |
| Відмова при браку пам'яті | через 2–4 хвилини | через 20–30 секунд |
| Пам'ять | сам вимірює і розподіляє | частку задаєте ви |
| Файл налаштувань | усе, включно з моделлю | усе, крім моделі |
| API | OpenAI, Anthropic | OpenAI, Anthropic, Ollama, власний |
| Кеш префіксів | блоками | деревом, точніший на коротких збігах |
| Стан на сервері | немає | сесії у власному API |
| Відкрито без ключа | перевірки, метрики, документація, /invocations | перевірки й метрики |
| Метрики | ввімкнені завжди | вмикаються прапорцем |
| Готовий дашборд | працює | потрібна правка імен метрик |
| Трасування | один запис на запит | дерево кроків |
| Телеметрія розробникам | є, вимикається | немає |
| Маршрутизатор | окремий пакет | в образі; проєктів три |
| Швидкість, один запит | однакова | однакова |
| Швидкість, 64 запити | 2415 ток/с | 1518 ток/с після налаштування |
- vLLM — вибір за замовчуванням: частіше працює без налаштування, більше моделей і заліза, уся обв'язка підтримує його першим.
- SGLang — для агентів і довгих діалогів зі спільними початками, для сесій на сервері й розділення фаз на великому кластері. Вимагає налаштування пам'яті.
- Обидва варто заміряти, якщо сервіс великий. Клієнтський код від вибору не залежить; змінюються команда запуску, файл налаштувань і дашборд.
- Жоден, якщо користувач один: простіше llama.cpp. За малого або нерівного навантаження дешевший хмарний API.