vLLM и SGLang: практическо сравнение на два сървъра за езикови модели
Здравейте!
vLLM и SGLang са двата основни отворени сървъра за стартиране на езикови модели на собствени видеокарти. Задачата им е една и съща, API-то е еднакво, скоростта е близка. Различават се в работата с паметта, настройката, сигурността и мониторинга.
Във всеки раздел на статията първо има обща част, после подраздел за vLLM и подраздел за SGLang. Версии: vLLM 0.34.0 от 16 ноември 2026 г. и SGLang 0.5.23 от 2 ноември 2026 г. Командите, конфигурационните файлове и изходът са взети от работещ стенд; това, което е преразказано по документацията без стартиране, е отбелязано.
Накратко:
- Една заявка и двата сървъра обработват със същата скорост. Разликата се появява при натоварване и зависи от модела.
- Памет: vLLM я разпределя сам, а в SGLang делът се задава от вас.
- Кешът на диалозите при SGLang е по-точен: пести повече при дълги диалози и при агенти.
- Сигурност: нито един от двата не бива да се оставя в интернет без прокси.
- vLLM е изборът по подразбиране, SGLang е за агенти и големи клъстери. Схемата за избор е в края.
Как са устроени двигателите за инференс отвътре, е разгледано в отделна статия. Тук са ни нужни четири понятия от нея: токени, фази prefill и decode, KV кеш и батчинг. TTFT е времето до първия токен от отговора.
Какво са vLLM и SGLang
Сървърът за инференс държи модела във видеопаметта, приема заявки по HTTP във формата на OpenAI и обработва много заявки едновременно. Пътят на заявката:
vLLM: кой го разработва
- Хранилище: около 97 хиляди звезди, лиценз Apache 2.0, нова версия на всеки две седмици.
- Появява се през 2023 г. в Бъркли. От 2025 г. е проект на PyTorch Foundation. От януари 2026 г. зад него стои компанията Inferact (150 млн. долара инвестиции).
- Кой го използва: LinkedIn (повече от 50 продукта), Red Hat (основата на продуктите ѝ за OpenShift), AWS (SageMaker и Bedrock), NVIDIA (контейнерите NIM 2 съдържат vLLM или SGLang).
SGLang: кой го разработва
- Хранилище: около 39 хиляди звезди, лиценз Apache 2.0, нова версия на всеки две седмици.
- Появява се през 2024 г. Води го нестопанската организация LMSYS, авторите на рейтинга Chatbot Arena. От 2026 г. зад него стои компанията RadixArk (100 млн. долара инвестиции).
- Кой го използва: xAI (картата на Grok-2 изисква моделът да се стартира през SGLang), Meta (по нейния доклад през ноември 2026 г.), Cloudflare (Workers AI), LinkedIn (класиране в търсенето; LinkedIn използва и двата сървъра).
С какво се различават от другите начини за стартиране на модел
vLLM и SGLang са предназначени за много едновременни заявки на собствени видеокарти. За един потребител не са по-бързи от простите програми.
| Начин | За какво | Разлика от vLLM и SGLang |
|---|---|---|
| llama.cpp, Ollama, LM Studio | модел на собствения компютър | работи дори без видеокарта, компресирани модели GGUF, старт за секунди; при натоварване от много потребители е по-слаб |
| TensorRT-LLM | максимална скорост на NVIDIA | само NVIDIA, по-малко модели |
| NVIDIA NIM | готов контейнер с платена поддръжка | не е двигател: вътре има vLLM или SGLang |
| TGI от Hugging Face | бивш главен съперник | в архив, авторите съветват vLLM и SGLang |
| Dynamo, llm-d, AIBrix | десетки видеокарти в Kubernetes | слой над двигателите: разпределя заявките между копия на vLLM или SGLang |
| LiteLLM | един адрес за различни модели, ключове, бюджети | шлюз пред сървърите, не стартира модели |
| Облачно API | плащане за токени | няма какво да се поддържа; собствената видеокарта се изплаща само при постоянно натоварване |
По-подробно – в картата на двигателите.
vLLM: място сред другите системи
Изборът по подразбиране. Най-широкият списък с модели и хардуер. Слоевете за Kubernetes (llm-d, AIBrix, KServe), Ray Serve и продуктите на Red Hat поддържат на първо място него. В тестовете MLPerf през април 2026 г. на него са работили 20 участници (изчисление на Red Hat).
SGLang: място сред другите системи
По-силен при заявки с общо начало: агенти, дълги диалози, един системен промпт у много потребители. Често е начело при много големи модели на десетки видеокарти. Същите слоеве за клъстери го поддържат, но обикновено по-късно от vLLM.
Стенд
- Видеокарта RTX 5070 Ti Laptop, 12 GB; Ryzen 9 9955HX; 64 GB оперативна памет.
- Windows 11, WSL2, Docker Desktop.
- Образи
vllm/vllm-openai:v0.34.0иlmsysorg/sglang:v0.5.23-runtime. - Prometheus 3.16, Grafana 13.3, Jaeger 2.23, nginx 1.30 – в същата мрежа на Docker.
Моделите са от семейството Qwen3.5: разбират картинки, разсъждават преди отговора, извикват функции, лиценз Apache 2.0.
| Модел | Тегла | На 12 GB |
|---|---|---|
| Qwen3.5-4B, FP8 | 7,5 GiB | основният модел на статията |
| Qwen3.5-2B | 4,3 GiB | измервания при натоварване |
| Qwen3.5-0.8B | 1,7 GiB | две копия наведнъж, за маршрутизацията |
| Qwen3.5-4B без компресия | 8,7 GiB | не се стартира |
| Qwen3.5-9B, 4 бита | 8,5 GiB | не се стартира |
Абсолютните цифри за скорост на лаптоп са пъти по-ниски от серверните. Настройките, грешките и съдържанието на логовете на голям хардуер са същите.
Хардуер и системи
И на двата сървъра са нужни Linux, ускорител с достатъчно памет и нови драйвери.
vLLM: хардуер и системи
- ОС: само Linux. Windows – през WSL2 или Docker, Mac – през плъгина vllm-metal.
- Python: 3.11–3.14.
- NVIDIA: от T4 и RTX 20xx. Билдовете са само за CUDA 13. За стари драйвери –
VLLM_ENABLE_CUDA_COMPATIBILITY=1. - AMD: Instinct MI200, MI300, MI350, а също Radeon RX 7900 и RX 9000 (ROCm).
- Intel: Arc и сървърни ускорители.
- Чрез плъгини: Google TPU, AWS Trainium, Huawei Ascend, Apple Silicon.
- Без видеокарта: работи, за малки модели.
SGLang: хардуер и системи
- ОС: Linux. Windows в документацията не се споменава; в Docker върху WSL2 работи.
- Python: 3.11 и по-нов. При 3.10 инсталирането не се проваля, а поставя стара версия на сървъра.
- NVIDIA: от A100 до най-новите сървърни, RTX 30, 40 и 50, DGX Spark, Jetson. Само CUDA 13.
- AMD: Instinct MI300X, MI325X, MI350X, MI355X.
- Intel: Arc и Xeon.
- Друго: Google TPU, Huawei Ascend, Apple Silicon, Moore Threads.
- RTX 50 и инсталиране през pip: нито един модел не се стартира без ръчна настройка на пътищата към компилатора на CUDA (отворена задача). В образа на Docker проблемът го няма.
Инсталиране
Два начина: пакет за Python или образ на Docker. В продукция се взема образ с номер на версията, а не latest: двете програми излизат на всеки две седмици и редовно променят флаговете.
Моделите се теглят от Hugging Face при първото стартиране в ~/.cache/huggingface. Тази папка се свързва с контейнера, за да не се тегли отново.
vLLM: инсталиране
uv pip install vllm --torch-backend=autovllm download-kernelsВтората команда изтегля готови ядра за видеокартата. Без нея сървърът ги компилира при първото стартиране в продължение на няколко минути. Изпълнява се след всяко инсталиране и обновяване.
docker pull vllm/vllm-openai:v0.34.0Образът: 10 GB при изтегляне, 36 GB на диска.
SGLang: инсталиране
uv pip install --prerelease=allow sglangБез --prerelease=allow старите версии на uv мълчаливо инсталират SGLang 0.5.9.
docker pull lmsysorg/sglang:v0.5.23-runtimeОбразът -runtime е олекотен: 14,5 GB при изтегляне, 50 GB на диска. Пълният, v0.5.23, съдържа и инструменти за билд.
Първо стартиране
Сървърът се стартира с една команда. vLLM слуша порт 8000, SGLang – 30000. Заявките към тях са еднакви.
vLLM: първо стартиране
docker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ vllm/vllm-openai:v0.34.0 \ RedHatAI/Qwen3.5-4B-FP8-dynamic \ --max-model-len 16384 --max-num-seqs 16--ipc=host– процесите на сървъра обменят данни през обща памет.- Томът
vllm-cacheпази това, което е компилирано при първото стартиране. - Готовност: редът
Application startup complete. На стенда – след 155 секунди.
Какво пише сървърът за паметта:
Model loading took 6.23 GiB memory and 11.814035 secondsAvailable KV cache memory: 3.99 GiBGraph capturing finished in 1 secs, took 0.14 GiBGPU KV cache size: 34,492 tokens, Maximum concurrency for 16,384 tokens per request: 2.11xПаметта за диалози стига за 34 492 токена – два диалога с максимална дължина.
Заявка:
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "RedHatAI/Qwen3.5-4B-FP8-dynamic", "messages": [{"role": "user", "content": "What is a KV cache in LLM inference? Answer in two sentences."}], "max_tokens": 400 }'В полето content ще дойдат разсъжденията на модела, а не отговорът:
Thinking Process:
1.  **Analyze the Request:**    *   Topic: KV cache in Large Language Model (LLM) inference.    *   Constraint: Answer in exactly two sentences....
Сървърът не знае къде свършват разсъжденията на модела, докато не е зададен флагът --reasoning-parser (раздел за настройката).
Списъкът на всички адреси на API е на страницата http://localhost:8000/docs, там има 24 операции:
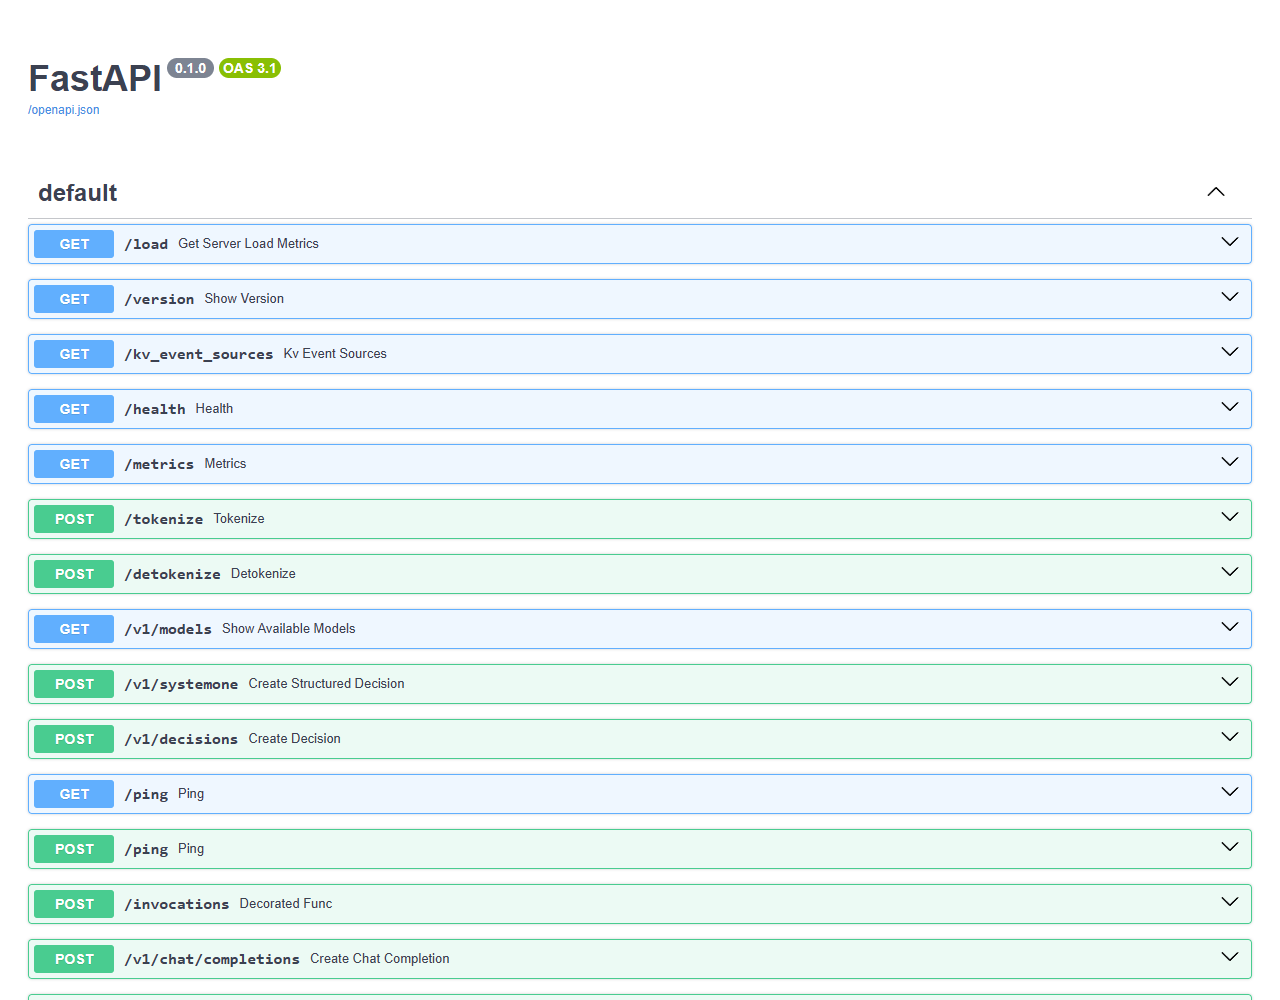
SGLang: първо стартиране
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --host 0.0.0.0 --port 30000 \ --context-length 16384 --mem-fraction-static 0.8--host 0.0.0.0е задължителен в контейнер. По подразбиране сървърът слуша127.0.0.1: логът пише „готов“, а заявките отвън не минават.- Готовност: редът
The server is fired up and ready to roll!. На стенда – след 85–100 секунди.
Какво пише сървърът за паметта:
Load weight end. elapsed=2.19 s, quant=compressed-tensors, avail mem=4.44 GB, mem usage=6.28 GB.Mamba Cache is allocated. max_mamba_cache_size: 20, conv_state size: 0.02GB, ssm_state size: 0.98GBKV Cache is allocated. #tokens: 38949, K size: 0.59 GB, V size: 0.59 GBmax_total_num_tokens=38949, max_running_requests=4, context_len=16384, available_gpu_mem=0.37 GBПаметта за диалози е 38 949 токена, едновременно не повече от четири заявки.
Заявката и отговорът са същите като при vLLM, сменя се само портът. Разсъжденията също попадат в content, докато не е зададен --reasoning-parser.
На страницата /docs при SGLang има 108 операции:
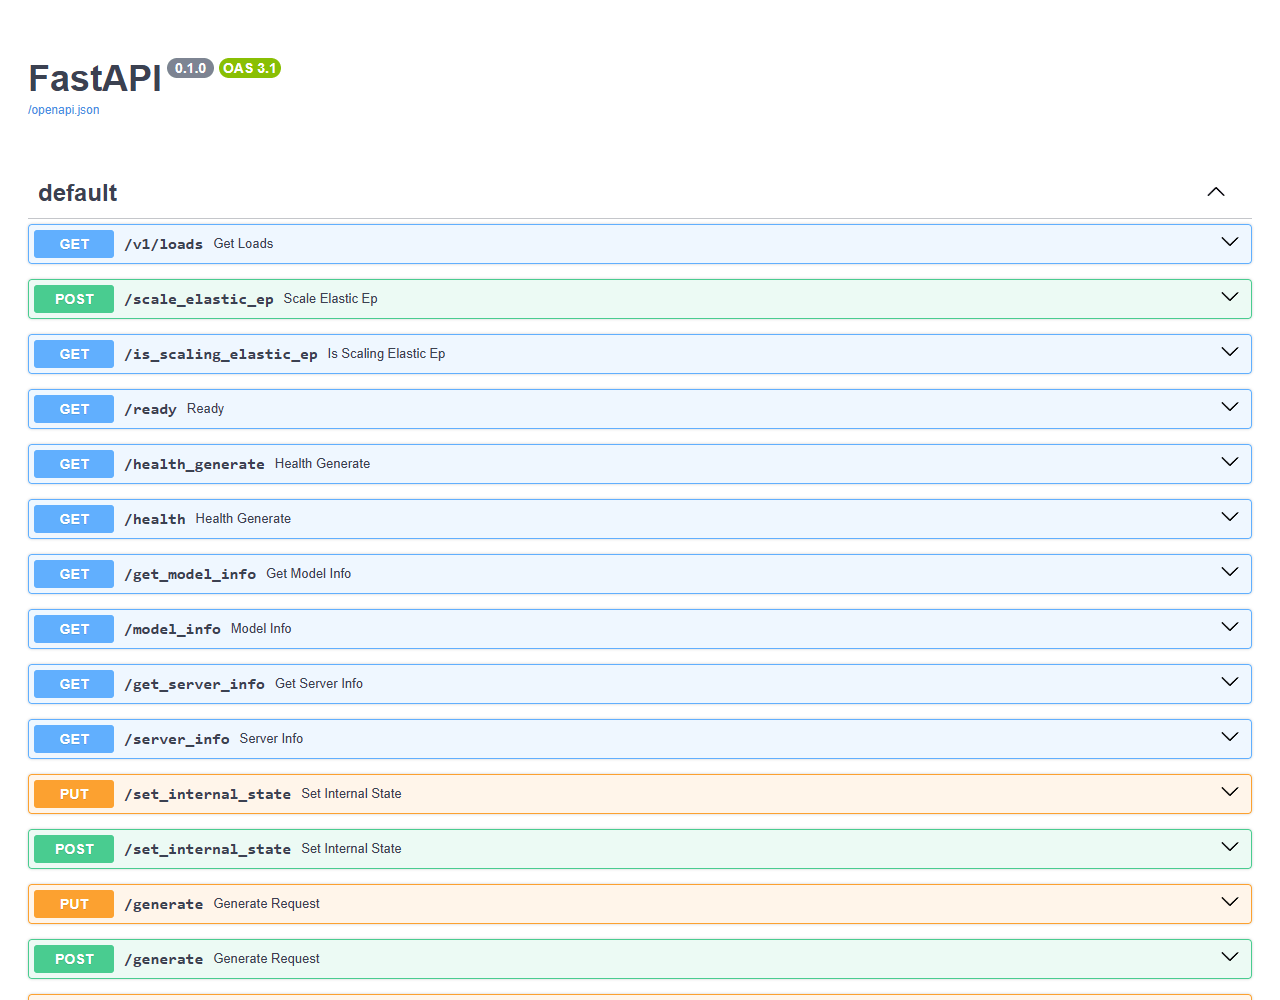
Освен API за клиентите тук има управление на сървъра: изчистване на кеша, обновяване на теглата, зареждане на адаптери, профилиране. Всичко това трябва да се затвори за външни хора (раздел за мрежата).
Видеопамет
От видеопаметта зависи дали моделът ще се стартира, колко диалога ще се поберат едновременно и каква дължина могат да имат. Паметта се дели така:
- Теглата на модела. Размерът е равен на размера на файловете на модела и не се променя.
- Памет за диалози (KV кеш). При Qwen3.5-4B – 32 KiB на токен: диалог от 16 хиляди токена заема 512 MiB. Расте с броя на потребителите.
- Състояние на хибридните модели. При Qwen3.5 обикновено внимание има само в 8 слоя от 32. Останалите 24 пазят за диалога компресирано състояние с постоянен размер. В логовете то се нарича Mamba cache.
- Работни буфери за изчисленията на една стъпка. На стенда – около 1,6 GiB.
- Записани графи на изчисленията (CUDA графи): 0,1–0,5 GiB.
- Други програми. На лаптоп работният плот и браузърът заемат 1,2 GiB, на отделен сървър – нищо.
Един и същ модел в двата сървъра:
Редът, в който сървърите разделят паметта при старт, е различен:
Какво следва от това:
- Освен теглата са нужни още 3–4 GiB. Модел, който по размер на файловете е почти равен на видеопаметта, няма да се стартира.
- Паметта за диалози е остатък след теглата, буферите и графите.
- Лостовете са три: дължина на диалога, брой едновременни заявки, дял на паметта за сървъра.
vLLM: видеопамет
До версия 0.34 сървърът заделяше предварително 92% от видеопаметта. От 0.34 той зарежда теглата, прекарва пробни заявки, измерва буферите и графите и отдава на паметта за диалози всичко останало. Флагът --gpu-memory-utilization вече е по-добре да не се задава: всяка стойност само ще намали паметта за диалози. Старият съвет „не се стартира – намалете --gpu-memory-utilization“ е остарял.
Actual usage is 6.33 GiB for consumed memory (weights + non-torch), 1.59 GiB for peak activation, and 0.14 GiB for CUDAGraph memory.Memory after warmup: 4.17 GiB free, 1.59 GiB kept for transient activations; 80 KV cache blocks (1.41 GiB) fit within the requested 11.91 GiB.| Флаг | Какво прави |
|---|---|
--max-model-len | максимална дължина на диалога в токени. По подразбиране от модела: при Qwen3.5 това е 262 144 |
--max-num-seqs | брой едновременни заявки. По подразбиране 256, на големите сървърни карти 1024 |
--gpu-memory-utilization | дял от видеопаметта за сървъра. Нужен е, когато картата се дели между няколко програми |
--kv-cache-memory-bytes | точен размер на паметта за диалози |
--kv-cache-dtype fp8 | компресирана памет за диалози: два пъти повече диалози |
Когато паметта за диалози свърши, новите заявки чакат на опашка. Ако не достига на вече започналите, сървърът измества последно приетата заявка и по-късно чете промпта ѝ отново. Потребителят вижда забавяне, а не грешка.
Две копия на сървъра на една видеокарта: на всяко --gpu-memory-utilization 0.4, иначе първото ще заеме всичко.
SGLang: видеопамет
Флагът --mem-fraction-static задава дела от видеопаметта за теглата и паметта за диалози заедно. Остатъкът отива за буферите и графите. Без флага сървърът изчислява дела сам; на карта с 12 GB се получи 0,63.
Как се подбира, по документацията:
- при старт сървърът пише остатъка от свободната памет –
available_gpu_mem; - на големите карти нормата е 5–8 GB остатък;
- остатъкът е много по-голям – делът може да се повиши;
- сървърът пада от липса на памет при натоварване – делът трябва да се намали.
На 12 GB стойността по подразбиране е твърде предпазлива. Qwen3.5-4B във FP8 с нея не се стартира:
RuntimeError: Hybrid (mamba/linear-attention) state cache is too small to serve any requests. max_mamba_cache_size=3, mamba_ratio=5, resulting max_num_reqs=0. Try: (1) reduce --max-running-requests, (2) increase --mem-fraction-static, or (3) use GPUs with more memory.С --mem-fraction-static 0.8 се стартира: четири едновременни заявки.
| Флаг | Какво прави |
|---|---|
--mem-fraction-static | дял от видеопаметта за теглата и паметта за диалози |
--context-length | максимална дължина на диалога в токени |
--max-running-requests | брой едновременни заявки |
--max-total-tokens | точен размер на паметта за диалози в токени |
--chunked-prefill-size | размер на парчетата, с които се чете дълъг промпт. По-малко – по-малки буфери |
--kv-cache-dtype fp8_e4m3 | компресирана памет за диалози. За точност е нужен файл с мащаби: --quantization-param-path |
--mamba-full-memory-ratio, --max-mamba-cache-size | памет за състоянието на хибридните модели |
Когато паметта за диалози свърши, SGLang сваля една от изпълняваните заявки и я връща на опашката. В лога: KV cache pool is full. Retract requests. Ако това се случва често, повишете --schedule-conservativeness.
Какво не се побира в 12 GB
| Модел | Тегла в паметта | vLLM | SGLang |
|---|---|---|---|
| Qwen3.5-4B без компресия | 8,6 GiB | няма място за паметта за диалози | не достигнаха 2,57 GB за състоянието |
| Qwen3.5-9B, 4 бита | 8,4–9,5 GiB | същото | същото |
Компресията до 4 бита намалява само основните слоеве. Блокът за разпознаване на картинки и таблиците с токени остават същите, затова моделът с 9,7 млрд. параметри заема повече от 8 GiB.
Отказът на vLLM:
Memory after warmup: 0.91 GiB free, 1.59 GiB kept for transient activations; 0 KV cache blocks (0.0 GiB) fit within the requested 11.91 GiB.ValueError: No available memory for the cache blocks. [...] decrease `max_model_len` or `max_num_seqs`, or the model needs a device with more memory.Отказът на SGLang:
Load weight end. avail mem=1.37 GB, mem usage=9.35 GB.RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache. Computed max_mamba_cache_size=-27 (total_rest_memory=-2.57 GB, mamba_cache_per_req=49.12 MB).vLLM съобщава за липса на памет след 2–4 минути, в края на загряването. SGLang – след 20–30 секунди, веднага след зареждането на теглата.
При vLLM с хибриден модел има и още една грешка при старт: стойността на --max-num-seqs по подразбиране е твърде голяма.
ValueError: max_num_seqs (256) exceeds available Mamba cache blocks (42). Please lower max_num_seqs to at most 42 or increase gpu_memory_utilization.Формати на моделите и квантуване
И двата сървъра работят с формата safetensors от Hugging Face. GGUF, познат от llama.cpp и Ollama, не е техният формат. Какво е квантуване – в раздела за него.
Предварително компресиран модел и двата сървъра разпознават сами, без флагове.
vLLM: формати и квантуване
- Източници: Hugging Face, папка на диска, ModelScope (
VLLM_USE_MODELSCOPE=True), обектно хранилище (vllm serve s3://bucket/model --load-format runai_streamer). - Готови компресирани модели: FP8, AWQ, GPTQ, INT8, INT4, NVFP4, MXFP4, compressed-tensors, NVIDIA ModelOpt, AMD Quark.
- Компресия при зареждане:
--quantization fp8_per_tensor. - GGUF: отделен плъгин
vllm-gguf-plugin, експериментален. - bitsandbytes: отделен плъгин
vllm-bnb-plugin. - Компресиране на собствен модел: LLM Compressor.
- LoRA адаптери:
--enable-lora --lora-modules sql=път. Клиентът избира адаптера с полетоmodel; заявките към различни адаптери вървят в един батч.
SGLang: формати и квантуване
- Източници: Hugging Face, папка на диска, ModelScope (
SGLANG_USE_MODELSCOPE=true), адресиs3://,gs://,az://. - Готови компресирани модели: същите основни формати. Флагът
--quantizationне може да се добавя към вече компресиран модел. - Компресия при зареждане:
--quantization fp8. Компресията през torchao е премахната от версия 0.5.23. - GGUF: форматът за зареждане
ggufима, списък на поддържаните архитектури документацията не дава. - LoRA адаптери:
--enable-lora --lora-paths sql=път. Зареждат се и се разтоварват в движение:/load_lora_adapter,/unload_lora_adapter. В заявката:"model": "базов-модел:адаптер".
Скорост на стенда, един потребител:
| Модел | vLLM | SGLang |
|---|---|---|
| Qwen3.5-4B, FP8 | 84 ток/с | 56–60 ток/с |
| Qwen3.5-2B без компресия | 110 ток/с | 109 ток/с |
Изчисленията във FP8 за този модел са по-бързи при vLLM. При некомпресиран модел разлика няма.
Настройка
Настройките се задават с флагове, с YAML файл или с променливи на средата. Ако стойността има и във флага, и във файла, печели флагът.
За разсъждаващите модели и за извикване на функции са нужни два разборчика, свои за всяко семейство модели:
- reasoning parser отделя разсъжденията от отговора;
- tool call parser превръща текста на модела в извикване на функция с аргументи.
vLLM: настройка
# vLLM 0.34 — всички настройки на сървъра в един файлmodel: RedHatAI/Qwen3.5-4B-FP8-dynamic# Под това име моделът се вижда от клиентитеserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 8000
# Памет: най-дълъг диалог и брой едновременни заявкиmax-model-len: 16384max-num-seqs: 16
# Отделяй разсъжденията на модела от отговораreasoning-parser: qwen3# Превръщай текста на модела в извиквания на функцииenable-auto-tool-choice: truetool-call-parser: qwen3_xml
# Показвай в отговора колко токена от промпта са взети от кешаenable-prompt-tokens-details: true# Връщай идентификатора на заявката в хедъра X-Request-Idenable-request-id-headers: truedocker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml- Помощ:
vllm serve --help=all– всичко,--help=max-num-seqs– един флаг. - Вложени настройки – през точка:
--logging-config.formatter json. - Кратък запис на числата:
--max-model-len 16Kе 16 384. ГлавнотоKе 1024, малкотоkе 1000. - Параметри на генерирането от модела. Сървърът прилага
generation_config.jsonот папката на модела. Изключва се с флага--generation-config vllm. - Променливи на средата:
HF_TOKEN,VLLM_API_KEY,VLLM_LOGGING_LEVEL,VLLM_NO_USAGE_STATS=1(отказ от телеметрия). - Kubernetes: не наименувайте услугата
vllm. Kubernetes ще създаде променливи с префиксVLLM_, а сървърът ще ги вземе за свои настройки.
SGLang: настройка
# SGLang 0.5.23 — настройките на сървъра в един файл.# Моделът се задава в командния ред: sglang serve <модел> --config config.yaml# Под това име моделът се вижда от клиентитеserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 30000
# Памет: най-дълъг диалог и дял от видеопаметта за теглата и кеша на диалозитеcontext-length: 16384mem-fraction-static: 0.8
# Отделяй разсъжденията на модела от отговораreasoning-parser: qwen3# Превръщай текста на модела в извиквания на функцииtool-call-parser: qwen3_coder
# Давай метрики за Prometheus на адрес /metricsenable-metrics: true# Показвай в отговора колко токена от промпта са взети от кешаenable-cache-report: truedocker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123- Моделът – само в командния ред. С
model-pathвъв файла и без модел в командатаsglang serveпада:Error: --model-path is required. - Ключът за достъп – само с флага
--api-key. - Команда за стартиране:
sglang serve. Предишнатаpython -m sglang.launch_serverоще работи и се среща в повечето инструкции. - Метриките са изключени без
--enable-metrics. - Броят токени от кеша в отговора – само с
--enable-cache-report. - Имената на разборчиците са други: за същия модел във vLLM е
qwen3_xml, тук еqwen3_coder. - Помощта е по-надеждна от документацията: 91 флага в таблицата на документацията не са описани. Гледайте
sglang serve --help. - Променливи на средата:
HF_TOKEN,SGLANG_CACHE_DIR(папка с компилираните ядра, свържете я като том),SGLANG_LOGGING_CONFIG_PATH(собствен формат на лога).
API
И двата сървъра повтарят API-то на OpenAI. Библиотеката openai работи с тях без промени: сменя се адресът. Примерите по-долу са стартирани и с двата сървъра без корекции.
# vLLMexport BASE_URL=http://localhost:8000/v1 API_KEY=sk-lab-123# SGLangexport BASE_URL=http://localhost:30000/v1 API_KEY=sk-lab-123Обикновена заявка. Разсъжденията идват отделно от отговора:
import os
from openai import OpenAI
# Един и същ код работи с двата сървъра: сменя се само адресът.# vLLM: http://localhost:8000/v1, SGLang: http://localhost:30000/v1client = OpenAI(    base_url=os.environ["BASE_URL"],    api_key=os.environ["API_KEY"],)
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {"role": "system", "content": "You are a concise assistant."},        {            "role": "user",            "content": "What is a KV cache in LLM inference? Answer in two sentences.",        },    ],    max_tokens=2048,)
message = response.choices[0].message# Разсъжденията идват в отделно поле: във vLLM то се казва reasoning,# в SGLang — reasoning_contentreasoning = getattr(message, "reasoning", None) or getattr(message, "reasoning_content", None)print("REASONING:", (reasoning or "")[:200].replace("\n", " "), "...")print("ANSWER:", message.content.strip())print("USAGE:", response.usage.prompt_tokens, "+", response.usage.completion_tokens)
REASONING: Thinking Process: 1. **Analyze the Request:** * Topic: KV cache ...ANSWER: A KV cache stores the attention key-value pairs for all previous tokens, allowing the model to retrieve context without re-computing layer activations. This reuse significantly reduces the computational cost and latency of autoregressive inference, particularly when generating long sequences of text.USAGE: 36 + 1565Отговор от две изречения струва 1565 токена: почти всичко отиде за разсъждения. При малък max_tokens разсъждаващият модел не стига до отговора и content идва празен.
Поток, изключване на разсъжденията, измерване на TTFT:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
started = time.perf_counter()first_token_at = Nonetokens = 0
stream = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": "Explain in three sentences why one GPU can serve many LLM requests at once.",        }    ],    max_tokens=300,    stream=True,    # Поискай сървърът да прати в края на потока броячите на токените    stream_options={"include_usage": True},    # Изключи разсъжденията: параметърът отива в чат шаблона на модела    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
for chunk in stream:    if chunk.usage:        tokens = chunk.usage.completion_tokens    if not chunk.choices:        continue    piece = chunk.choices[0].delta.content    if piece:        if first_token_at is None:            first_token_at = time.perf_counter()        print(piece, end="", flush=True)
total = time.perf_counter() - startedttft = first_token_at - startedspeed = tokens / (total - ttft)print(f"\n\nTTFT: {ttft * 1000:.0f} ms, tokens: {tokens}, speed: {speed:.0f} tokens/s")
vLLM: TTFT: 71 ms, tokens: 93, speed: 84 tokens/sSGLang: TTFT: 82 ms, tokens: 93, speed: 56 tokens/sИзвикване на функции. Моделът назовава функцията и аргументите, а я извиква вашият код:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Описание на функцията, която на модела е позволено да извикаtools = [    {        "type": "function",        "function": {            "name": "get_gpu_memory",            "description": "Returns used and total memory of a GPU in megabytes.",            "parameters": {                "type": "object",                "properties": {                    "gpu_index": {                        "type": "integer",                        "description": "Index of the GPU, starting from 0",                    },                },                "required": ["gpu_index"],            },        },    }]
messages = [{"role": "user", "content": "How much memory is free on GPU 0?"}]
# 1. Моделът решава, че му трябва функция, и връща името и аргументите ѝfirst = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)call = first.choices[0].message.tool_calls[0]print("CALL:", call.function.name, call.function.arguments)
# 2. Функцията се изпълнява от нашия код, а не от сървъра; тук отговорът е поставен на ръкаresult = {"used_mb": 9896, "total_mb": 12227}messages.append(first.choices[0].message)messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
# 3. Моделът получава резултата и отговаря на човекаsecond = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)print("ANSWER:", second.choices[0].message.content.strip())
CALL: get_gpu_memory {"gpu_index": 0}ANSWER: GPU 0 has approximately **2.3 GB** free memory.Отговор по схема. Сървърът забранява на модела токените, които нарушават схемата, и отговорът винаги е правилен JSON:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Схема, на която отговорът е длъжен да отговаряschema = {    "type": "object",    "properties": {        "component": {"type": "string", "enum": ["memory", "network", "model", "other"]},        "severity": {"type": "string", "enum": ["low", "medium", "high"]},        "summary": {"type": "string"},    },    "required": ["component", "severity", "summary"],    "additionalProperties": False,}
log_line = "RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache."
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "system",            "content": "Classify the log line of an inference server. Keep the summary under 20 words.",        },        {"role": "user", "content": log_line},    ],    # Сървърът няма да позволи на модела да избере токен, който нарушава схемата    response_format={        "type": "json_schema",        "json_schema": {"name": "incident", "schema": schema, "strict": True},    },    max_tokens=300,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
incident = json.loads(response.choices[0].message.content)print(incident)
{'component': 'memory', 'severity': 'high', 'summary': 'GPU memory insufficient for hybrid attention cache.'}Картинка на входа:
import base64import os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Картинката тръгва в заявката като низ base64with open("dashboard.png", "rb") as file:    image = base64.b64encode(file.read()).decode()
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": [                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image}"}},                {"type": "text", "text": "What does this picture show? Answer in two sentences."},            ],        }    ],    max_tokens=200,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
print(response.choices[0].message.content.strip())print("prompt tokens:", response.usage.prompt_tokens)
Картинка 1200×630 заема 785 токена от промпта и в двата сървъра.
vLLM: какво има освен API-то на OpenAI
- Responses API:
/v1/responses. - Anthropic Messages API:
/v1/messages. Така се свързва Claude Code (инструкция). - Ембединги, пренареждане, разпознаване на реч.
- Токенизиране: адреси
/tokenizeи/detokenize. - gRPC:
vllm serve --grpc. - Поле с разсъжденията:
reasoning. - Хедър
X-Request-Id: сървърът приема идентификатора на заявката от клиента и го връща в отговора. - Ключът – само в
Authorization: Bearer. Хедърътx-api-key, който пращат клиентите на Anthropic, не се приема: отговор 401.
SGLang: какво има освен API-то на OpenAI
- Responses API и Anthropic Messages API – на същите адреси.
x-api-keyсъщо не се приема. - API на Ollama:
/api/chat,/api/generate,/api/tags. - Ембединги, пренареждане, разпознаване на реч, токенизатор.
- Стартиране без HTTP:
sgl.Engine(model_path=...)в код на Python. При vLLM за това има класътLLM. - Поле с разсъжденията:
reasoning_content. Това е единственото място, където клиентът трябва да знае с кой сървър разговаря. - Собствено API
/generate– суров текст без чат шаблон:
curl http://localhost:30000/generate \ -H "Authorization: Bearer sk-lab-123" -H "Content-Type: application/json" \ -d '{"text": "The capital of Bulgaria is", "sampling_params": {"max_new_tokens": 8, "temperature": 0}}'{ "text": " Sofia. Sofia is the largest city in", "meta_info": { "finish_reason": {"type": "length", "length": 8}, "prompt_tokens": 5, "completion_tokens": 8, "cached_tokens": 0 }}Отговорът е съкратен: в истинския има още два десетка служебни полета.
Сесии и състояние
И двата сървъра не пазят диалози. Клиентът във всяка заявка изпраща цялата история.
За да не се чете историята отново на всеки ход, работи кешът на префиксите: сървърът запазва паметта на диалога след отговора и взема от нея съвпадналото начало на следващата заявка. Кешът е включен по подразбиране и не е вързан за потребител: съвпадението се търси по текста.
Диалог от четири хода със системен промпт от 2000 токена:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Дълъг системен промпт: около 2000 токена правила, еднакви за всички заявкиrules = "\n".join(    f"Rule {n}: when the user asks about topic {n}, answer politely and mention the number {n * 7}."    for n in range(1, 81))messages = [{"role": "system", "content": "You are a support assistant.\n" + rules}]
questions = [    "What does rule 5 say?",    "And rule 12?",    "Which rule mentions the number 140?",    "Thanks. Summarize our conversation in one sentence.",]
for turn, question in enumerate(questions, start=1):    messages.append({"role": "user", "content": question})
    started = time.perf_counter()    first_token_at = None    answer = ""    usage = None    stream = client.chat.completions.create(        model="qwen3.5-4b",        messages=messages,        max_tokens=120,        stream=True,        stream_options={"include_usage": True},        extra_body={"chat_template_kwargs": {"enable_thinking": False}},    )    for chunk in stream:        if chunk.usage:            usage = chunk.usage        if chunk.choices and chunk.choices[0].delta.content:            if first_token_at is None:                first_token_at = time.perf_counter()            answer += chunk.choices[0].delta.content
    # Сървърът не помни диалога: историята всеки път я праща клиентът    messages.append({"role": "assistant", "content": answer})
    details = usage.prompt_tokens_details    cached = details.cached_tokens if details else 0    ttft = (first_token_at - started) * 1000    prompt = usage.prompt_tokens    print(f"turn {turn}: prompt {prompt} tokens, from cache {cached}, TTFT {ttft:.0f} ms")
vLLM:
turn 1: prompt 2157 tokens, from cache 0, TTFT 339 msturn 2: prompt 2202 tokens, from cache 1728, TTFT 84 msturn 3: prompt 2253 tokens, from cache 1728, TTFT 155 msturn 4: prompt 2320 tokens, from cache 1728, TTFT 103 msSGLang:
turn 1: prompt 2157 tokens, from cache 0, TTFT 341 msturn 2: prompt 2210 tokens, from cache 2112, TTFT 61 msturn 3: prompt 2266 tokens, from cache 2176, TTFT 55 msturn 4: prompt 2323 tokens, from cache 2240, TTFT 48 msОт втория ход и двата отговарят пъти по-бързо:
SGLang взема от кеша почти всичко, vLLM – 1728 токена на всеки ход:
vLLM: кеш и състояние
Устройство. Паметта за диалози е нарязана на блокове. Сървърът смята хеш на всеки запълнен блок заедно с всичко, което е било преди него, и сравнява новата заявка с кеша блок по блок. Незапълненият блок в кеша не влиза.
Размер на блока – 64 токена (до версия 0.34 – 16). При хибридните модели е по-голям: при Qwen3.5 – 576 токена. Оттам идват 1728 в примера: това са три блока, а до четвъртия диалогът не е стигнал.
Следствие. Общо начало, по-късо от блока, не се кешира. При общ системен промпт от 450 токена vLLM с Qwen3.5 показа попадение в кеша 4%, SGLang при същото натоварване – 87%. При обикновените модели блокът е девет пъти по-малък и такава разлика няма.
Как се вижда работата на кеша:
- в отговора:
usage.prompt_tokens_details.cached_tokens(флагът--enable-prompt-tokens-details); - в метриките:
vllm:prefix_cache_hits_total,vllm:prefix_cache_queries_total; - в лога:
Prefix cache hit rate, на всеки десет секунди.
Изолация на клиентите. По времето за отговор може да се разбере дали някой е изпращал същото начало на заявка. Ако клиентите не бива да знаят нищо един за друг, добавяйте в заявките поле cache_salt, собствено за всеки клиент. Заявките с различна сол не делят блокове.
Съхраняване на отговорите на сървъра (параметърът previous_response_id в Responses API) е изключено:
404 invalid_request_error, param: response_idResponse with id 'resp_123' not found.Включва се с променливата VLLM_ENABLE_RESPONSES_API_STORE=1. Отговорите стоят в паметта на процеса, никога не се изтриват и изчезват при рестартиране. За продукция не става: историята я пази клиентът или слоят пред сървъра.
SGLang: кеш и състояние
Устройство. Кешът е дърво на общите начала (radix дърво). За новата заявка се търси най-дългото съвпадение. Съвпадението е по-точно, отколкото по блокове: в примера 2112 токена от 2210, а числото расте с всеки ход. Когато паметта свърши, се изтриват клоновете, до които най-отдавна не е имало достъп (--radix-eviction-policy).
Как се вижда работата на кеша:
- в отговора: същото поле
cached_tokens(флагът--enable-cache-report); - в метриките:
sglang:cache_hit_rate,sglang:cached_tokens_total; - в лога, в реда за всеки прочетен промпт:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80, #running-req: 3, #queue-req: 1От 517 токена на промпта 448 са взети от кеша.
Защита на кеша на диалога: флагът --enable-session-radix-cache и полето session_id в заявката. Клоновете на този диалог се изтриват последни. Историята пак я изпраща клиентът.
Сесии на сървъра. През собственото API може да се отвори сесия (/open_session) и да се изпраща само новият текст: сървърът ще го допише към съхранявания контекст. Направено е за обучение с подкрепление и за агенти, работи само през /generate. На стенда не е стартирано.
Съхраняването на отговорите на сървъра също е изключено:
400 invalid_request_error, param: previous_response_idResponse store is disabled. Stateful Responses require --enable-response-store on a standalone server; response storage is unavailable in PD mode.С --enable-response-store се включва. Ограниченията са същите като при vLLM: памет на процеса, без срок на съхранение, след рестартиране е празно.
Мрежа и сигурност
Нито един от двата сървъра не е предназначен да стои в интернет без защита. Ключ за достъп има и при двата, но той не затваря всичко. Пред сървъра се поставя обратен прокси и навън се пускат само нужните адреси.
- Прокси: TLS, ключове, ограничаване на броя заявки, списък на разрешените адреси.
- Маршрутизатор: избира копие на сървъра (следващият раздел).
- Сървърите на модели и мониторингът – във вътрешната мрежа.
Настройка на nginx за един сървър:
upstream llm {    server vllm:8000;    # Дръж връзките със сървъра на модела отворени    keepalive 32;}
server {    listen 80;    # Заявките с картинки понякога са големи    client_max_body_size 20m;
    # Навън е отворено само API-то за клиентите    location /v1/ {        proxy_pass http://llm;        proxy_http_version 1.1;        proxy_set_header Connection "";        proxy_set_header Host $host;        # Един идентификатор на заявката в логовете на прокси и на сървъра на модела        proxy_set_header X-Request-Id $request_id;        # Без това проксито трупа отговора и го връща на един път        proxy_buffering off;        # Дългият отговор може да върви минути        proxy_read_timeout 600s;    }
    # Проверка за жизненост за балансировчика    location = /health {        proxy_pass http://llm;        access_log off;    }
    # Всичко останало, включително /metrics, /invocations и /docs, отвън е недостъпно    location / {        return 404;    }}
proxy_buffering off– иначе вместо текст дума по дума потребителят ще получи пауза и целия отговор наведнъж.proxy_read_timeout 600s– по подразбиране nginx къса връзката след 60 секунди мълчание.location / { return 404; }– навън излиза само изрично изброеното.- За продукция добавете
listen 443 sslи сертификати. За SGLang сменете адреса сsglang:30000.
Какво отговаря сървърът на заявка без ключ, когато ключът е зададен:
| Адрес | vLLM | SGLang |
|---|---|---|
/health | 200 | 200 |
/metrics | 200 | 200 |
/docs, /openapi.json | 200 | 401 |
/version | 200 | — |
/v1/models, /v1/chat/completions | 401 | 401 |
POST /invocations (генериране) | 200 | — |
POST /tokenize | 200 | 401 |
| сведения за сървъра, изчистване на кеша | — | 401 |
vLLM: мрежа и сигурност
- Адрес и порт:
--host,--port(по подразбиране всички интерфейси, 8000),--udsза сокет на Unix,--root-pathза прокси, което не е в корена на сайта. - Ключ:
--api-keyилиVLLM_API_KEY. Може няколко:--api-key k1 k2. - Ключът затваря само
/v1и няколко служебни префикса. /invocationsгенерира без ключ. Адресът е направен за AWS SageMaker и приема същите заявки като/v1/chat/completions:
curl -X POST http://localhost:8000/invocations \ -H "Content-Type: application/json" \ -d '{"model": "qwen3.5-4b", "messages": [{"role": "user", "content": "Say OK"}], "max_tokens": 5, "chat_template_kwargs": {"enable_thinking": false}}'{ "id": "chatcmpl-ab039d14c5d03cbf", "object": "chat.completion", "model": "qwen3.5-4b", "choices": [{"index": 0, "message": {"role": "assistant", "content": "OK"}}]}Това е документирано поведение: страницата за сигурността в документацията на vLLM изброява /invocations сред незащитените адреси. Навън – само през прокси.
- TLS:
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh(препрочитай сертификатите),--ssl-cert-reqs(проверявай сертификата на клиента). - CORS: от версия 0.32 заявките от чужди сайтове са забранени. Разрешените сайтове –
--allowed-origins. - Връзката между възлите не е криптирана. Възлите се държат в изолирана мрежа.
- Картинки по линкове: сървърът сам изтегля картинката по адреса от заявката и така може да бъде насочен към вътрешни адреси на мрежата. Ограничение –
--allowed-media-domains. - Телеметрия: сървърът изпраща на разработчиците анонимна статистика (видеокарта, архитектура на модела, версия, част от настройките; текстове на заявки няма). Изключва се с
VLLM_NO_USAGE_STATS=1илиDO_NOT_TRACK=1.
SGLang: мрежа и сигурност
- Адрес и порт:
--host,--port. По подразбиране127.0.0.1:30000– само от същата машина. - Два ключа:
--api-keyза клиентите,--admin-api-keyза управлението (обновяване на теглата, изчистване на кеша, сведения за сървъра). - Без ключ са отворени само проверките на състоянието и метриките.
/get_server_infoиздава ключа. В отговора са всички настройки на сървъра, включителноapi_keyв явен вид. Заявката изисква ключ, но всеки клиент с ключ вижда всички настройки. С--admin-api-keyадресът се затваря за клиентите.- Без
--api-keyвсичко е отворено: всичките 108 операции, включително зареждането на адаптери и обновяването на теглата. - CORS е отворен за всички сайтове. Това е записано в кода, флаг за ограничаване няма.
- TLS: същите
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh. HTTP/2 –--enable-http2. - Връзката между възлите не е криптирана.
- Картинки по линкове:
--allowed-media-domains. Без него сървърът тегли от всеки адрес. - Телеметрия: няма.
Няколко копия и маршрутизация
Когато една видеокарта не стига, се стартират няколко копия на сървъра и заявките се разпределят между тях. Кешът на префиксите на всяко копие е свой. Ако следващият ход на диалога попадне на друго копие, то ще прочете цялата история отново. Затова за сървърите на модели има маршрутизатори, които пращат заявката там, където началото ѝ вече е в кеша.
Измерване на стенда: две копия на Qwen3.5-0.8B на една видеокарта, шест диалога по пет хода с дълъг системен промпт.
| Сървър | Разпределяне на заявките | Токени от промпта от кеша |
|---|---|---|
| vLLM | едно копие | 59% |
| vLLM | nginx, към по-малко заетия | 34% |
| vLLM | vLLM Router, с отчитане на кеша | 52% |
| SGLang | маршрутизатор, на кръг | 53% |
| SGLang | маршрутизатор, с отчитане на кеша | 73% |
Разпределянето без отчитане на кеша отнема на vLLM почти половината от попаденията. Тестът е малък (30 заявки), дяловете се променят леко от пускане до пускане.
vLLM: копия и маршрутизация
nginx е вариантът от документацията на vLLM. Променя се началото на настройката от раздела за мрежата:
upstream llm { # Новата заявка отива при сървъра с по-малко отворени връзки least_conn; server vllm-a:8000 max_fails=3 fail_timeout=30s; server vllm-b:8000 max_fails=3 fail_timeout=30s; keepalive 32;}vLLM Router е маршрутизатор на Rust от екипа на vLLM. Израснал е от маршрутизатора на SGLang (анонс).
pip install vllm-router==0.1.17vllm-router \ --worker-urls http://vllm-a:8000 http://vllm-b:8000 \ --policy cache_aware \ --host 0.0.0.0 --port 8090Правила за разпределяне (--policy):
| Стойност | Как разпределя |
|---|---|
round_robin | на кръг |
random | на случаен принцип |
power_of_two | към по-малко заетия от две случайни |
consistent_hash | по хеша на заявката |
sticky_least_loaded | към по-малко заетия, със закрепване на диалога |
cache_aware | там, където началото на заявката е в кеша |
kv_aware | по сведения за кеша от самите сървъри |
Още може: повтаряне на неуспелите заявки, изключване на сбойното копие, търсене на копия в Kubernetes.
Production Stack е комплект за Kubernetes от същия екип: маршрутизатор, сървъри, мониторинг, инсталира се през Helm. На стенда не е стартиран.
Слоеве за клъстери: llm-d, AIBrix, NVIDIA Dynamo, KServe – за всеки има страница в документацията на vLLM.
SGLang: копия и маршрутизация
Маршрутизаторът е в образа на сървъра:
docker run -d --name sglang-router --network lab -p 30010:30000 \ --entrypoint python lmsysorg/sglang:v0.5.23-runtime \ -m sglang_router.launch_router \ --worker-urls http://sglang-a:30000 http://sglang-b:30000 \ --policy cache_aware \ --host 0.0.0.0 --port 30000 --prometheus-port 29000Правила за разпределяне: round_robin, random, power_of_two, cache_aware, consistent_hashing, prefix_hash, bucket, manual. Още може: повтаряне на заявки, изключване на сбойни копия, ограничаване на броя едновременни заявки, търсене на копия в Kubernetes. Собствените си метрики дава на отделен порт.
Маршрутизаторите на SGLang сега са три:
| Проект | Пакет | Състояние |
|---|---|---|
| SGLang Model Gateway | sglang-router | в образа и в документацията; пакетът не е обновяван от януари 2026 г. |
| SMG | smg | продължение на първия в отделно хранилище; работи и с vLLM |
| sgl-router | sgl-router | нов олекотен, първа версия на 18 ноември 2026 г. |
Преди да изберете, проверете кой от тях се развива.
Копия в рамките на един сървър: --dp-size N. Документацията за този случай сама съветва маршрутизатор.
Слоеве за клъстери: llm-d, AIBrix, Dynamo и собствен оператор за Kubernetes – OME.
Наблюдаемост
- Метрики – броячи и времена във формат Prometheus на адрес
/metricsна основния порт. - Логове – какво прави сървърът, по желание всяка заявка.
- Трасиране – пътят на една заявка по стъпки, по стандарта OpenTelemetry.
Времената, които показват метриките и трасетата:
Prometheus, Grafana и Jaeger до сървърите:
# Prometheus, Grafana и Jaeger до сървърите на модели.# Мрежата lab е създадена предварително: docker network create labservices:  prometheus:    image: prom/prometheus:latest    container_name: prometheus    volumes:      - ./prometheus.yaml:/etc/prometheus/prometheus.yml:ro    ports:      - "9090:9090"    networks: [lab]
  grafana:    image: grafana/grafana:latest    container_name: grafana    environment:      # Вход без парола — само за стенд на собствен компютър      - GF_AUTH_ANONYMOUS_ENABLED=true      - GF_AUTH_ANONYMOUS_ORG_ROLE=Admin    volumes:      # Източникът на данни и дашбордовете се свързват сами при старт      - ./provisioning:/etc/grafana/provisioning:ro      - ./dashboards:/var/lib/grafana/dashboards:ro    ports:      - "3000:3000"    networks: [lab]    depends_on: [prometheus]
  jaeger:    image: jaegertracing/jaeger:latest    container_name: jaeger    ports:      - "16686:16686" # уеб интерфейс      - "4317:4317"   # приемане на трасета по OTLP gRPC      - "4318:4318"   # приемане на трасета по OTLP HTTP    networks: [lab]
networks: lab: external: trueglobal: scrape_interval: 5s
scrape_configs: # И двата сървъра дават метрики на адрес /metrics на основния си порт - job_name: vllm static_configs: - targets: ["vllm:8000"]
- job_name: sglang static_configs: - targets: ["sglang:30000"]Два файла, за да свърже Grafana сама Prometheus и дашбордовете от папката:
apiVersion: 1datasources: - name: Prometheus uid: prometheus type: prometheus access: proxy url: http://prometheus:9090 isDefault: trueapiVersion: 1providers: - name: lab type: file options: path: /var/lib/grafana/dashboardsГрафиките по-долу са снети при еднакво натоварване: осем клиента без паузи, общ системен промпт, Qwen3.5-4B във FP8, четири минути.
vLLM: метрики, логове, трасиране
Метриките са винаги включени.
| Метрика | Какво показва |
|---|---|
vllm:num_requests_running | заявки в изпълнение |
vllm:num_requests_waiting | заявки на опашка. Главният сигнал за добавяне на копия |
vllm:kv_cache_usage_perc | запълненост на паметта за диалози, 0–1 |
vllm:time_to_first_token_seconds | време до първия токен |
vllm:inter_token_latency_seconds | пауза между токените |
vllm:e2e_request_latency_seconds | време на цялата заявка |
vllm:prompt_tokens_total, vllm:generation_tokens_total | прочетени и написани токени |
vllm:prefix_cache_hits_total, vllm:prefix_cache_queries_total | попадения в кеша на префиксите |
vllm:num_preemptions_total | измествания на заявки поради липса на памет |
vllm:request_success_total | завършени заявки с причина за завършване |
Дашбордът е в хранилището: examples/observability/prometheus_grafana/grafana.json. Предвиден е за ръчен импорт; за автоматично свързване сменете променливата на източника на данни:
sed -i 's/${DS_PROMETHEUS}/prometheus/g' monitoring/dashboards/vllm.json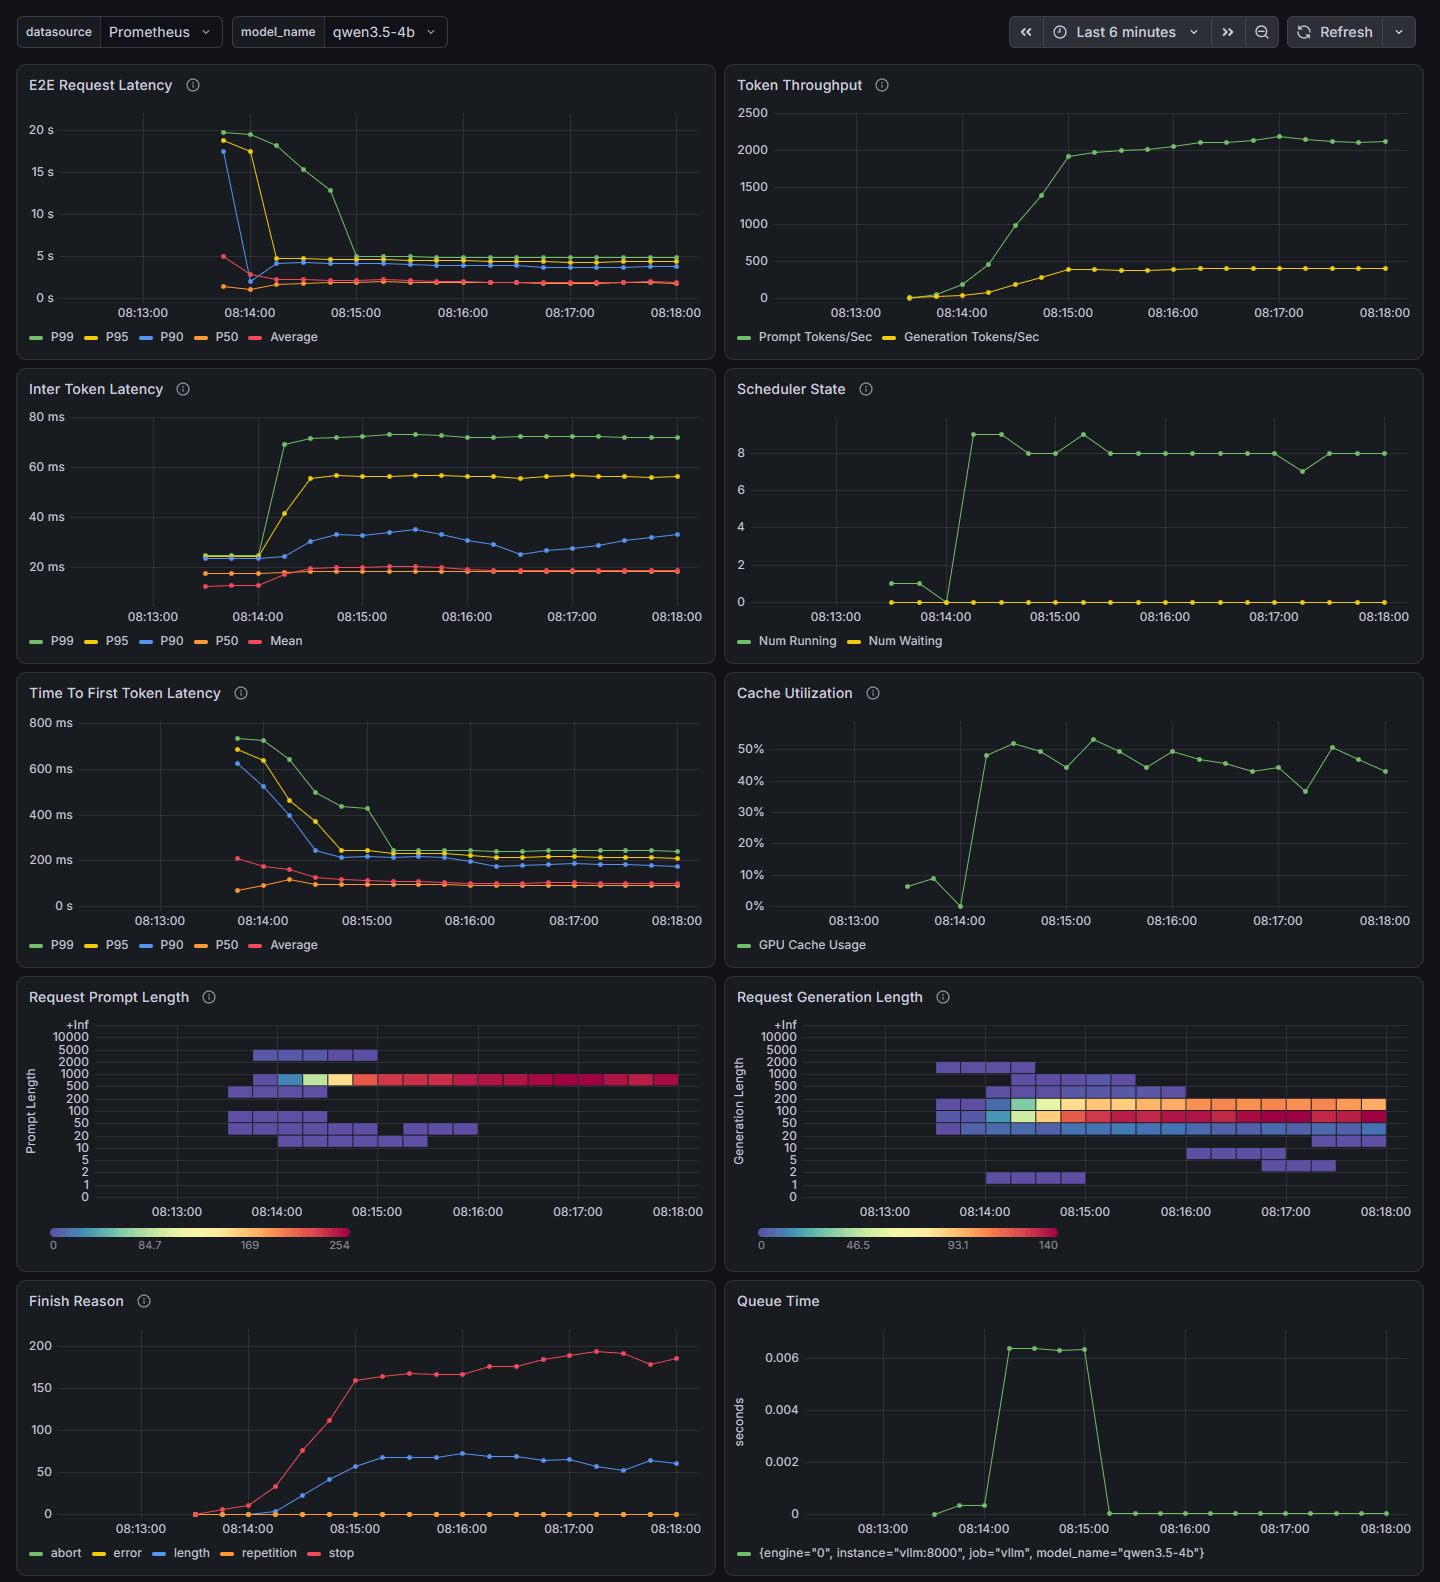
На графиките: осем заявки се изпълняват, опашка няма; около 400 токена в секунда на изхода; първият токен средно след 0,1 секунди; паметта за диалози е запълнена наполовина.
Лог. На всеки десет секунди – ред с резултатите:
Engine 000: Avg prompt throughput: 1913.3 tokens/s, Avg generation throughput: 371.4 tokens/s, Running: 9 reqs, Waiting: 0 reqs, GPU KV cache usage: 49.4%, Prefix cache hit rate: 3.6%| Флаг | Какво прави |
|---|---|
--enable-log-requests | ред за всяка заявка: идентификатор и параметри. Текстовете – само на ниво DEBUG |
--enable-log-outputs | записвай и отговорите |
--max-log-len | отрязвай дългите текстове |
--disable-access-log-for-endpoints /health,/metrics | не записвай проверките на състоянието |
--logging-config.formatter json | лог в JSON |
Ред от лога в JSON:
{ "asctime": "2026-11-21 06:22:43,840", "levelname": "INFO", "name": "vllm.v1.core.kv_cache_utils", "processName": "EngineCore", "process": 99, "message": "GPU KV cache size: 171,008 tokens, ..."}Трасиране. Библиотеките вече са в образа. Нужни са адресът на приемника и две променливи:
docker run --gpus all --ipc=host -p 8000:8000 --network lab --name vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ -e OTEL_SERVICE_NAME=vllm \ -e OTEL_EXPORTER_OTLP_TRACES_INSECURE=true \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml \ --otlp-traces-endpoint grpc://jaeger:4317 --enable-log-requestsЗа всяка заявка vLLM записва по един запис с готови числа:
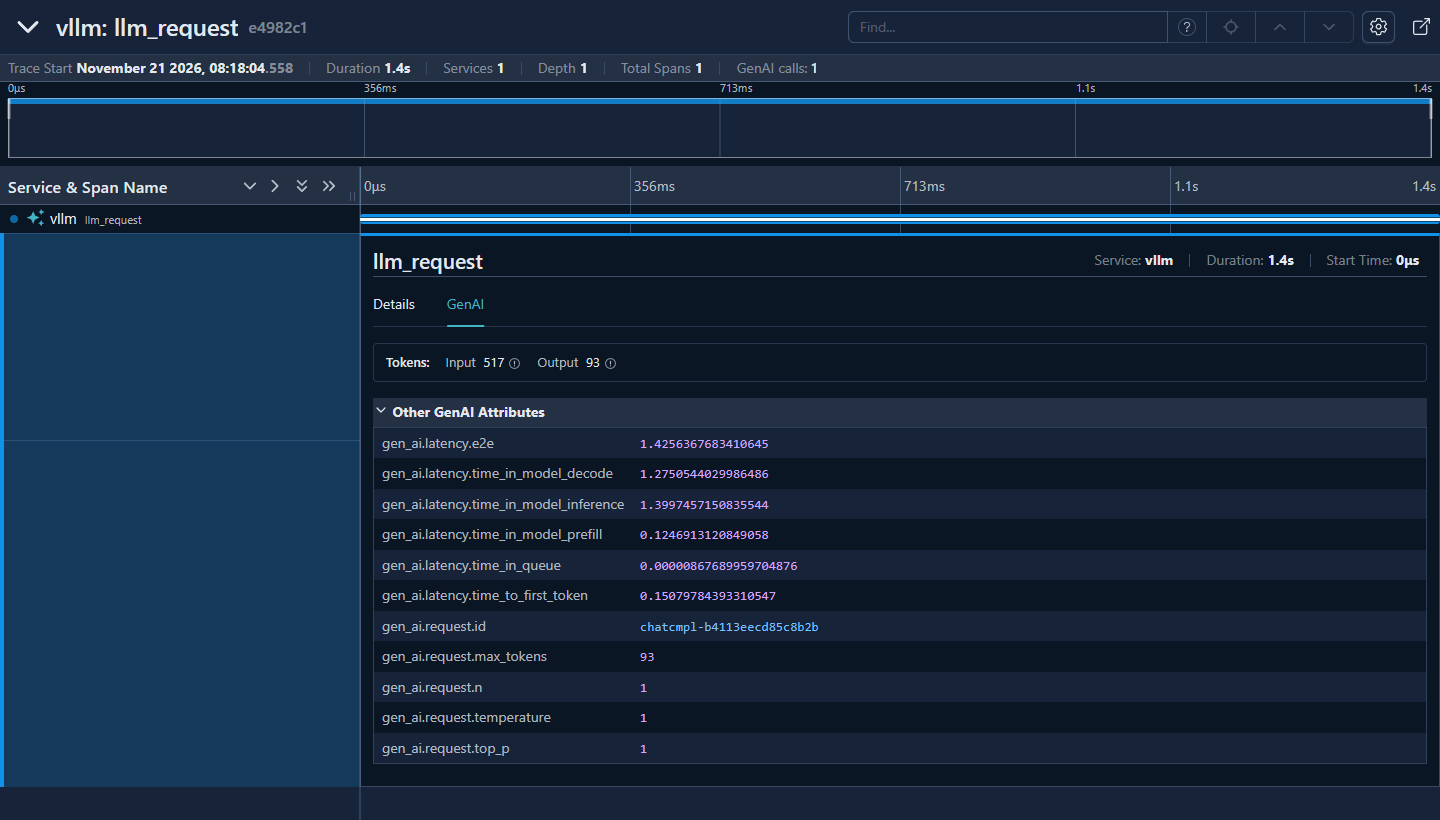
Промптът от 517 токена се е четял 0,12 секунди, отговорът от 93 токена се е писал 1,28 секунди, първият токен е дошъл след 0,15 секунди. Имената на полетата са от конвенцията на OpenTelemetry за генеративния ИИ.
SGLang: метрики, логове, трасиране
Метриките се включват с флага --enable-metrics.
| Метрика | Какво показва |
|---|---|
sglang:num_running_reqs | заявки в изпълнение |
sglang:num_queue_reqs | заявки на опашка |
sglang:token_usage | запълненост на паметта за диалози |
sglang:mamba_usage | запълненост на паметта за състоянието при хибридните модели |
sglang:time_to_first_token_seconds | време до първия токен |
sglang:inter_token_latency_seconds | пауза между токените |
sglang:e2e_request_latency_seconds | време на цялата заявка |
sglang:gen_throughput | скорост на генериране, токени в секунда |
sglang:cache_hit_rate | дял на токените от промпта от кеша |
sglang:num_retracted_requests_total | свалени заявки поради липса на памет |
Дашбордът е в хранилището: examples/monitoring/grafana/dashboards/json/sglang-dashboard.json. Във версия 0.5.23 той не показва данни:
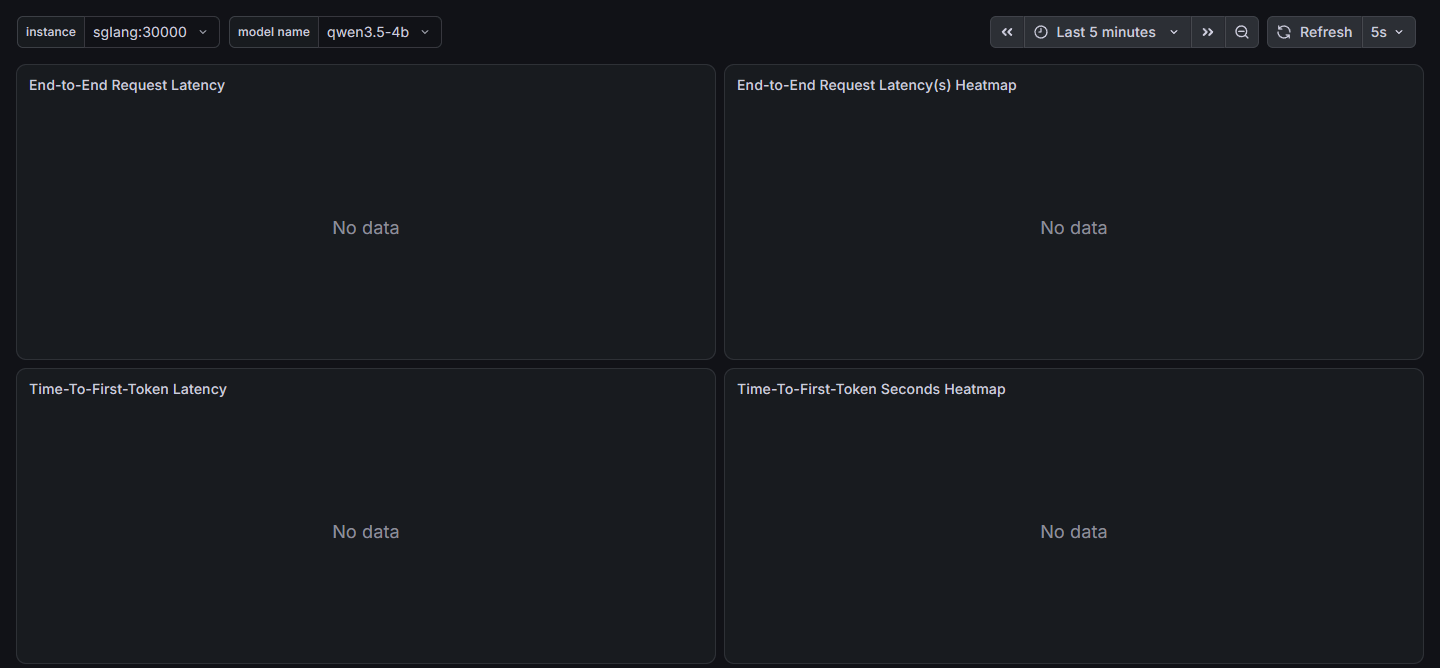
Сървърът публикува метриките с двоеточие (sglang:num_running_reqs), а заявките в дашборда са написани с долна черта (sglang_num_running_reqs). Поправка:
sed -i 's/sglang_/sglang:/g' monitoring/dashboards/sglang.json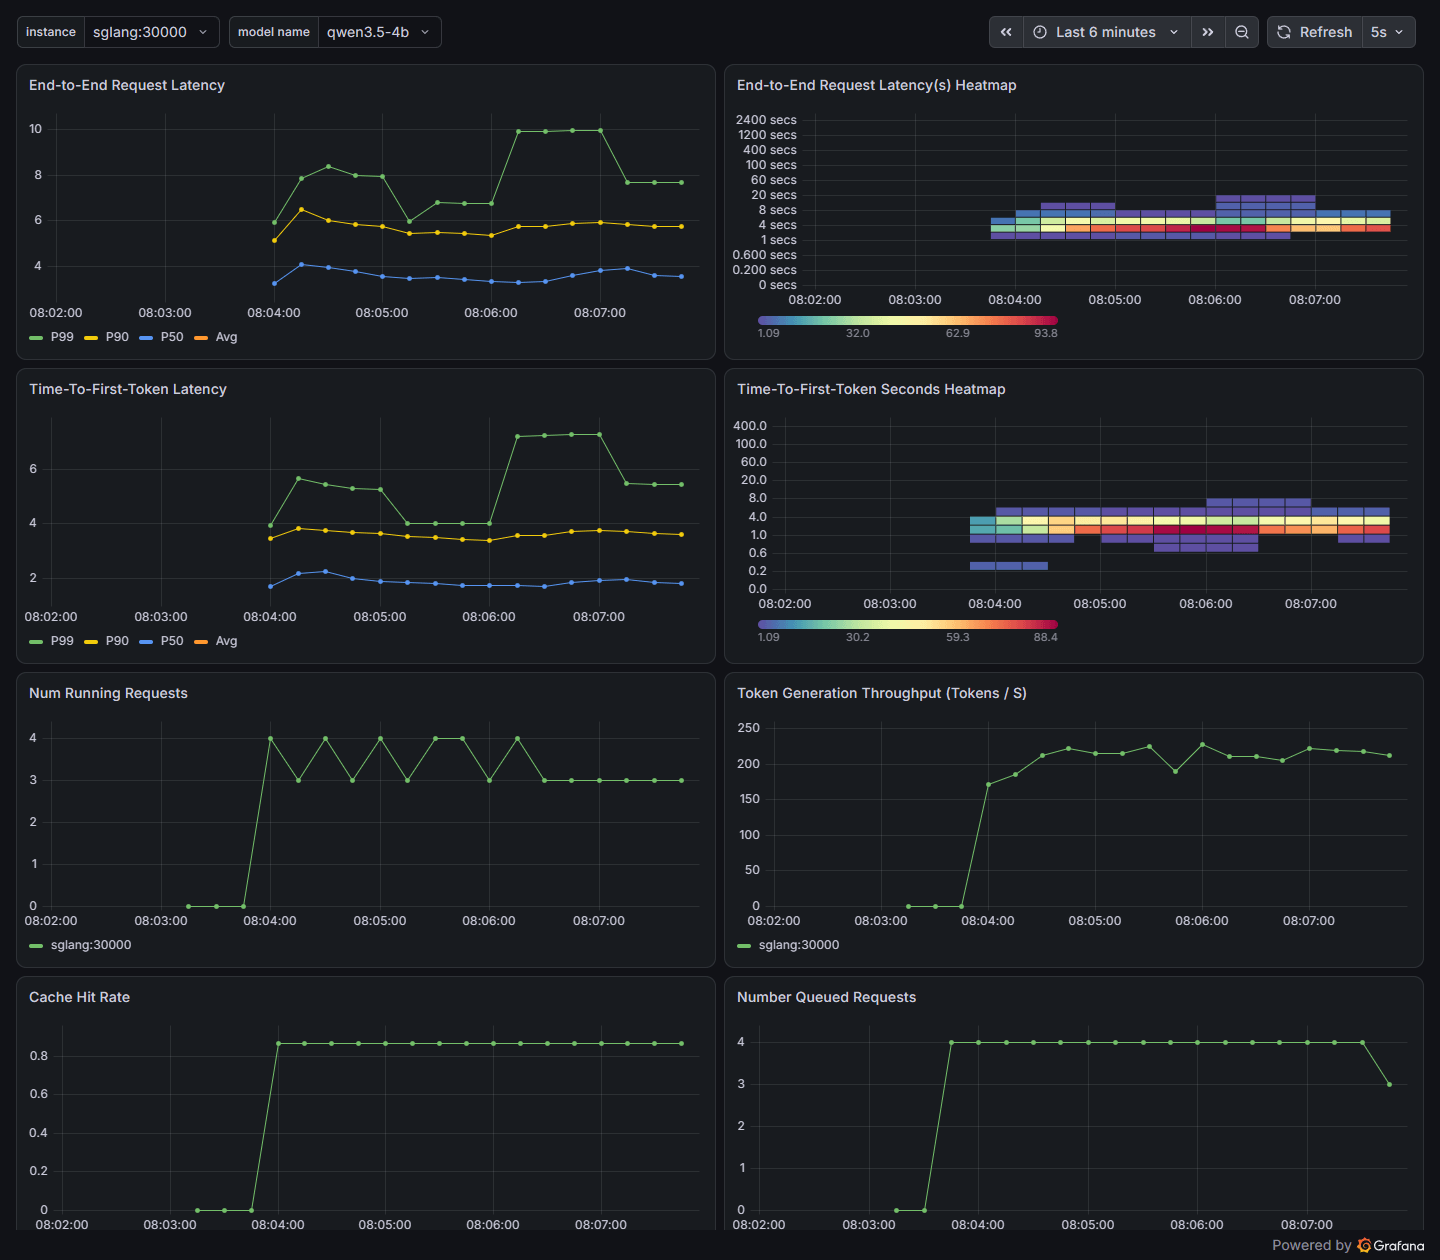
На графиките: четири заявки се изпълняват, четири са на опашка – повече на тази видеокарта с този модел не се побират; около 215 токена в секунда; първият токен след 2–4 секунди заради опашката; попадение в кеша 0,87.
Лог. Ред за всяко четене на промпт и веднъж на 40 стъпки на генерирането:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80,Decode batch, #running-req: 4, #full token: 1011, full token usage: 0.03, mamba num: 16, mamba usage: 0.80, gen throughput (token/s): 217.87, #queue-req: 4Паметта за диалози е почти празна (full token usage: 0.03), паметта за състоянието е запълнена на 80% (mamba usage: 0.80). Тясното място е тя.
| Флаг | Какво прави |
|---|---|
--log-requests | записвай за всяка заявка |
--log-requests-level | подробност от 0 (метаданни) до 3 (пълни текстове) |
--log-requests-format json | записите за заявките в JSON |
--log-requests-target | къде да се пише: конзола, папка или и двете |
--log-level, --log-level-http | подробност на лога на сървъра и на HTTP |
Запис за заявка в JSON, съкратен:
{ "timestamp": "2026-11-21T06:09:40.003283", "event": "request.finished", "rid": "369fb465a2ce4d5294e441b2e8fdba7f", "obj": { "sampling_params": {"temperature": 1.0, "max_new_tokens": 120, "top_p": 1.0}, "stream": true }}В JSON се записват само записите за заявките. Останалият лог е текст; за JSON е нужен собствен конфигурационен файл на лога (SGLANG_LOGGING_CONFIG_PATH).
Трасиране:
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 --network lab --name sglang \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123 \ --enable-trace --otlp-traces-endpoint jaeger:4317 \ --log-requests --log-requests-level 1 --log-requests-format jsonSGLang записва дърво от стъпки:
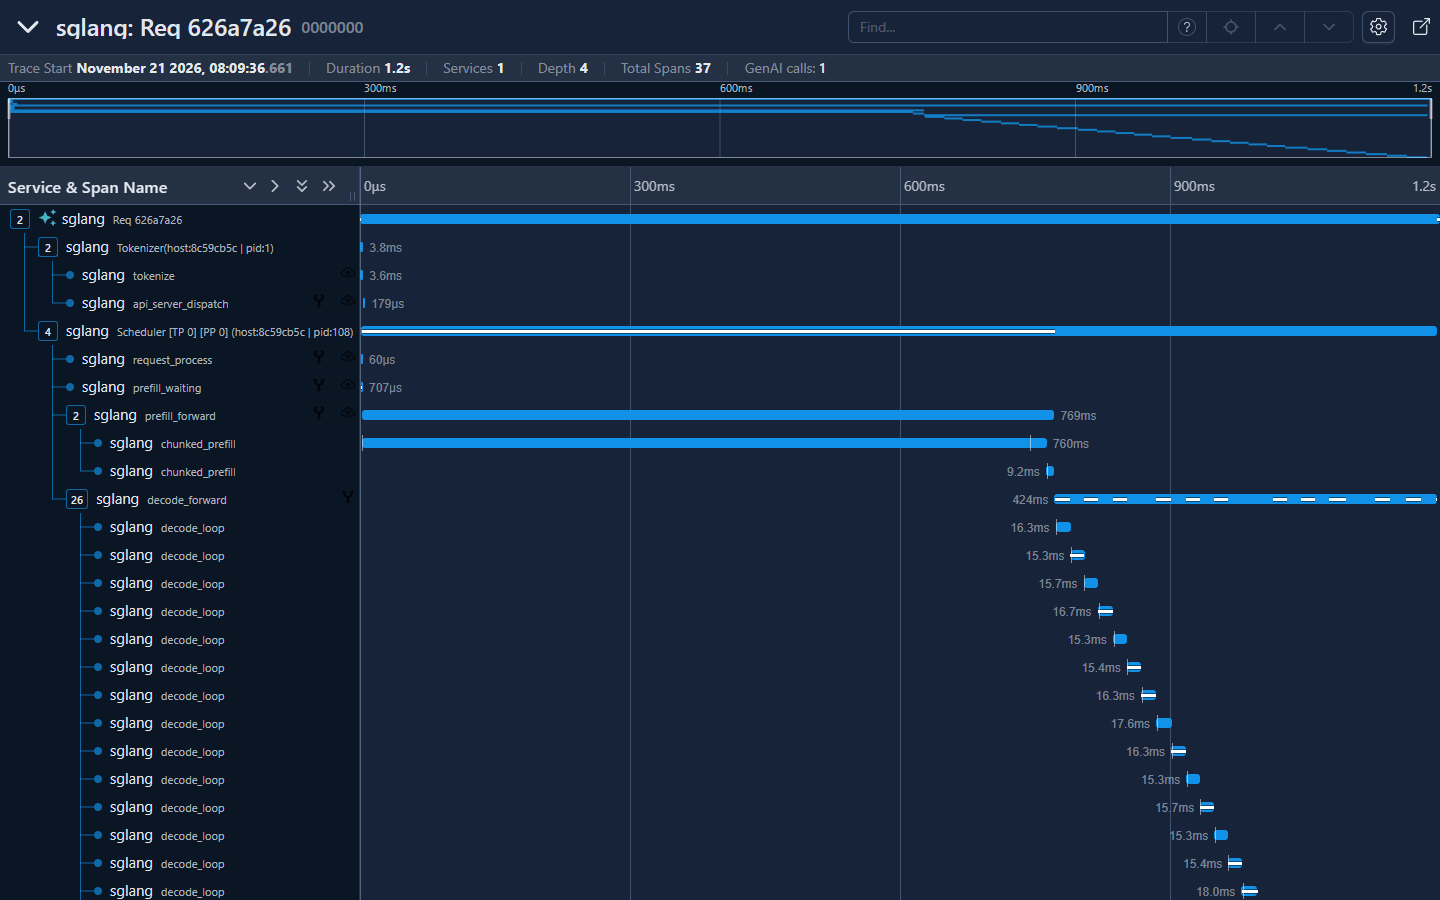
Токенизирането е 3,6 ms, четенето на промпт от 2157 токена – 769 ms, след това генериране на порции по 16 ms.
Записът на vLLM е по-лек: едно събитие на заявка. Дървото на SGLang е по-подробно, но това са десетки записи на заявка; подробността се намалява с променливата SGLANG_TRACE_LEVEL.
Проверки на състоянието
| vLLM | SGLang | |
|---|---|---|
| Процесът е жив | /health: 200 или 503 | /health |
| Сървърът реално генерира | — | /health_generate: генерира един токен |
| Готов за приемане на заявки | — | /ready: 503 по време на стартиране, пауза и спиране |
Докато моделът се зарежда, портът на vLLM е затворен. В Kubernetes е нужна стартова проверка (startupProbe) със запас от няколко минути, иначе подът ще се рестартира безкрайно.
Производителност
Общ отговор на въпроса „кой е по-бърз“ няма. Независимите измервания от 2026 г. се разминават:
- Winder.AI, септември, H100, Qwen3.8-27B: SGLang е напред с 7%.
- Jarvislabs, май, H100, модели Qwen от предишни поколения: напред е vLLM.
- На кои публични тестове да се вярва – в раздела за бенчмарковете.
Измерване на стенда:
- Модел: Qwen3.5-2B без компресия.
- Клиент:
vllm bench serveи за двата сървъра. Промптът е 512 случайни токена, отговорът е 256 токена. На всяко ниво нови промптове. - vLLM:
--max-model-len 8192 --max-num-seqs 64. - SGLang: с настройки по подразбиране и настроен.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name random --random-input-len 512 --random-output-len 256 \ --num-prompts 96 --max-concurrency 16 --ignore-eos --seed 42185Скорост на генериране, токени в секунда:
| Едновременни заявки | vLLM | SGLang по подразбиране | SGLang настроен |
|---|---|---|---|
| 1 | 110 | 109 | 107 |
| 4 | 468 | 454 | 416 |
| 16 | 1382 | 753 | 1150 |
| 32 | 1756 | 783 | 1427 |
| 64 | 2415 | 756 | 1518 |
Медианно време до първия токен, милисекунди:
| Едновременни заявки | vLLM | SGLang по подразбиране | SGLang настроен |
|---|---|---|---|
| 1 | 43 | 45 | 46 |
| 4 | 134 | 154 | 157 |
| 16 | 293 | 400 | 361 |
| 32 | 306 | 7796 | 698 |
| 64 | 330 | 16 667 | 5529 |
Изводи:
- За един потребител сървърите са равни.
- Батчингът работи и в двата. 64 едновременни заявки дават при vLLM 22 пъти повече текст, отколкото една.
- SGLang по подразбиране се е ограничил до 12 заявки: малко памет за състоянието на хибридния модел. Останалите заявки са чакали на опашка.
- След настройката SGLang е два пъти по-бърз (29 едновременни заявки), но vLLM не е настигнат.
Настроеният SGLang:
sglang serve Qwen/Qwen3.5-2B --host 0.0.0.0 \ --served-model-name qwen3.5-2b --context-length 8192 --enable-metrics \ --max-running-requests 64 --mamba-full-memory-ratio 4 \ --cuda-graph-max-bs-decode 64 --mem-fraction-static 0.72Заявки с общо начало: четири начала по 3000 токена, по 24 заявки на всяко, осем едновременно.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name prefix_repetition \ --prefix-repetition-num-prefixes 4 --prefix-repetition-prefix-len 3000 \ --prefix-repetition-suffix-len 200 --prefix-repetition-output-len 100 \ --num-prompts 96 --max-concurrency 8 --ignore-eos --seed 43995| vLLM | SGLang | |
|---|---|---|
| Скорост на генериране, токени в секунда | 689 | 653 |
| Медианно време до първия токен | 141 ms | 172 ms |
| Токени от промпта от кеша | 86% | 92% |
При дълго общо начало сървърите са равни. Разликата си личи при къси съвпадения и в диалог, който расте постепенно (раздел за сесиите).
Ограничения на измерването:
- Лаптоп. На сървърна карта с 80 GB паметта за състоянието няма да е тясно място.
- Хибриден модел. Изоставането на SGLang е свързано с това как той разполага състоянието му. При обикновените модели понякога е обратното.
- Памет на предела. Настроеният SGLang е заел 11,3 от 12 GB.
- Случайните промптове са най-лошият случай за кеша.
Измерете и двата сървъра със своя модел, своята видеокарта и своето натоварване.
vLLM: какво да се настройва за скорост
| Настройка | Действие |
|---|---|
--max-num-seqs | таван на едновременните заявки. Повече – по-висока обща скорост, по-дълга пауза между токените при всеки |
--max-num-batched-tokens | токени за стъпка. По-малко – по-равни паузи, повече – по-бърз първи токен |
--performance-mode | готови набори: balanced, interactivity, throughput |
-O0 … -O3 | ниво на оптимизация. -O0 – бърз старт и бавна работа |
--spec-method, --spec-model, --spec-tokens | спекулативно декодиране |
том /root/.cache/vllm | кеш на компилацията; без него всеки нов контейнер компилира отново |
VLLM_WSL2_ENABLE_PIN_MEMORY=1 | под WSL2 около 12% скорост на генериране, по измерване от обсъжданията на проекта. На стенда не е проверявано |
SGLang: какво да се настройва за скорост
| Настройка | Действие |
|---|---|
--max-running-requests | таван на едновременните заявки |
--cuda-graph-max-bs-decode | най-големият батч, за който е записан граф. На карти под 20 GB – 8; над това сървърът работи без граф и по-бавно |
--schedule-policy | ред на опашката. fcfs – по време на пристигане, lpm – първо с най-дългото съвпадение в кеша |
--schedule-conservativeness | предпазливост при приемане на заявки. Под 1 – по-смело |
--chunked-prefill-size | размер на парчетата за четене на промпта |
--mamba-full-memory-ratio, --max-mamba-cache-size | памет за състоянието на хибридните модели |
--speculative-algorithm | спекулативно декодиране |
SGLANG_CACHE_DIR и том | кеш на компилираните ядра |
Правило от документацията: паметта за диалози е запълнена под 90%, а опашката не е празна – намалете --schedule-conservativeness.
Няколко видеокарти
Разделът е написан по документацията, без стартиране. Начините да се разпредели моделът по картите са описани в раздела за мащабирането; тук са флаговете.
| Начин | vLLM | SGLang |
|---|---|---|
| Слоевете се делят между картите (TP) | --tensor-parallel-size | --tp-size |
| Слоеве последователно на различни карти (PP) | --pipeline-parallel-size | --pp-size |
| Копия на модела (DP) | --data-parallel-size | --dp-size |
| Експерти на MoE по картите (EP) | --enable-expert-parallel | --ep-size |
vLLM: няколко видеокарти
Четири карти на един сървър:
vllm serve <модел> --tensor-parallel-size 4Два сървъра по осем карти, главен възел и втори:
vllm serve <модел> --tensor-parallel-size 8 --pipeline-parallel-size 2 \  --nnodes 2 --node-rank 0 --master-addr <адрес на главния възел>
vllm serve <модел> --tensor-parallel-size 8 --pipeline-parallel-size 2 \ --nnodes 2 --node-rank 1 --master-addr <адрес на главния възел> --headless- Разделянето на prefill и decode по различни сървъри има, но е отбелязано като експериментално. То изравнява забавянията, а не увеличава общата скорост. В продукция се прави през llm-d, Dynamo или AIBrix.
- Изнасяне на паметта за диалози в оперативната памет:
--kv-offloading-size. - Автоматично мащабиране в Kubernetes – по метриката
vllm:num_requests_waiting. Натоварването на процесора тук нищо не казва.
SGLang: няколко видеокарти
Четири карти на един сървър:
sglang serve <модел> --tp-size 4Два сървъра по четири карти:
sglang serve <модел> --tp-size 4 --nnodes 2 --node-rank 0 \  --dist-init-addr <адрес на първия възел>:50000
sglang serve <модел> --tp-size 4 --nnodes 2 --node-rank 1 \ --dist-init-addr <адрес на първия възел>:50000- Разделянето на prefill и decode е силната страна на SGLang: сървъри с
--disaggregation-mode prefillи--disaggregation-mode decode, пред тях маршрутизатор с--pd-disaggregation. - Многостепенен кеш HiCache: паметта за диалози се изнася в оперативната памет и на диск.
- Големи модели с експерти:
--attn-dp-size.
Обновявания
И двете програми излизат на всеки две седмици и във всяка версия нещо е преименувано или премахнато.
- Фиксирайте версията на образа.
- Четете раздела за несъвместимите промени в бележките към изданието.
- Проверявайте обновяването на копие със същия модел.
vLLM: обновявания
| Версия | Какво се счупи |
|---|---|
| 0.34 | паметта за диалози се изчислява по нов начин; блок на кеша от 64 токена вместо 16 |
| 0.33 | премахнати са билдовете за CUDA 12 и два начина на спекулативно декодиране |
| 0.32 | премахнат е Python 3.10; заявките от браузър от чужди сайтове са забранени |
| 0.31 | компресията fp8 е преименувана на fp8_per_tensor |
- Документацията изостава. В 0.34 страницата за инсталиране посочва като билд по подразбиране CUDA 12.9, макар че пакетите са събрани за 13.0. Вярвайте на
vllm serve --help=all. - Извикванията на функции проверявайте с вашите данни. При хостинга Ubicloud те отговаряха на схемата в 92% от случаите, докато не включиха строга проверка на сървъра (разбор).
SGLang: обновявания
| Версия | Какво се счупи |
|---|---|
| 0.5.23 | маршрутизаторът се премести, флаговете му са преименувани |
| 0.5.22 | нужен е Python 3.11; --enable-dp-attention е заменен с --attn-dp-size |
| 0.5.21 | премахнати са няколко адреса на API; чат шаблонът от заявката се отхвърля |
| 0.5.20 | премахнати са билдовете за CUDA 12 и 17 флага; хранилището на Responses API е изключено |
- Остарялото се премахва след две издания, тоест след един месец.
- Инсталирайте обновленията за сигурност. От 27 август до 9 септември 2026 г. услугата на Cloudflare върху SGLang върна в 155 отговора данни на други клиенти: грешка на SGLang в режима на разделяне на фазите плюс неправилна настройка на паметта у Cloudflare (разбор). Поправено е в 0.5.20–0.5.22.
- Версия 1.0 е обявена през ноември 2026 г., но още не е излязла.
Чести грешки
| Какво се случва | Причина | Какво да се прави |
|---|---|---|
| Сървърът не се стартира, макар че моделът е по-малък от видеопаметта | освен теглата са нужни 3–4 GiB | по-малък или компресиран модел; раздел за видеопаметта |
| Вместо отговор идват разсъждения | не е зададен разборчик на разсъжденията | --reasoning-parser |
| Извикването на функция идва като текст | не е зададен разборчик на извикванията | --tool-call-parser |
| SGLang в контейнер не отговаря отвън | слуша 127.0.0.1 | --host 0.0.0.0 |
SGLang: --model-path is required | моделът е указан само в конфигурационния файл | моделът в командния ред |
SGLang: state cache is too small | малък дял памет по подразбиране | --mem-fraction-static 0.8 |
vLLM: max_num_seqs exceeds available Mamba cache blocks | твърде много едновременни заявки за хибриден модел | намалете --max-num-seqs |
| Дашбордът на SGLang е празен | в заявките е sglang_ вместо sglang: | заменете имената на метриките |
| vLLM отговаря без ключ | /invocations не е защитен с ключ | прокси със списък на адресите |
| Клиент на SGLang вижда ключа на сървъра | /get_server_info издава настройките | --admin-api-key |
| Общият системен промпт не се кешира във vLLM | по-къс е от блока на кеша | за хибридни модели – промпт по-дълъг от 576 токена |
| Отговорът през nginx идва на един път | проксито буферира | proxy_buffering off |
Какво да изберем
| vLLM 0.34 | SGLang 0.5.23 | |
|---|---|---|
| Кой го разработва | PyTorch Foundation, Inferact | LMSYS, RadixArk |
| Лиценз | Apache 2.0 | Apache 2.0 |
| Модели и хардуер | най-широк избор | малко по-тесен |
| Стартиране на стенда | 155 секунди | 85–100 секунди |
| Отказ при липса на памет | след 2–4 минути | след 20–30 секунди |
| Памет | сам измерва и разпределя | делът се задава от вас |
| Конфигурационен файл | всичко, включително моделът | всичко, освен модела |
| API | OpenAI, Anthropic | OpenAI, Anthropic, Ollama, собствено |
| Кеш на префиксите | по блокове | с дърво, по-точен при къси съвпадения |
| Състояние на сървъра | няма | сесии в собственото API |
| Отворено без ключ | проверки, метрики, документация, /invocations | проверки и метрики |
| Метрики | винаги включени | включват се с флаг |
| Готов дашборд | работи | нужна е корекция на имената на метриките |
| Трасиране | един запис на заявка | дърво от стъпки |
| Телеметрия към разработчиците | има, изключва се | няма |
| Маршрутизатор | отделен пакет | в образа; проектите са три |
| Скорост, една заявка | еднаква | еднаква |
| Скорост, 64 заявки | 2415 ток/с | 1518 ток/с след настройка |
- vLLM е изборът по подразбиране: по-често работи без настройка, повече модели и хардуер, цялата обвивка го поддържа пръв.
- SGLang е за агенти и дълги диалози с общи начала, за сесии на сървъра и разделяне на фазите на голям клъстер. Изисква настройка на паметта.
- И двата си струва да се измерят, ако услугата е голяма. Клиентският код не зависи от избора; сменят се командата за стартиране, конфигурационният файл и дашбордът.
- Нито един, ако потребителят е един: по-просто е llama.cpp. При малко или неравномерно натоварване облачното API е по-евтино.