vLLM и SGLang: практическое сравнение двух серверов для языковых моделей
Привет!
vLLM и SGLang — два главных открытых сервера для запуска языковых моделей на своих видеокартах. Задача у них одна, API одинаковый, скорость близкая. Различаются они в работе с памятью, настройке, безопасности и мониторинге.
В каждом разделе статьи сначала общая часть, потом подраздел про vLLM и подраздел про SGLang. Версии: vLLM 0.34.0 от 16 ноября 2026 и SGLang 0.5.23 от 2 ноября 2026. Команды, файлы настроек и вывод взяты с рабочего стенда; что пересказано по документации без запуска, помечено.
Главное:
- Один запрос оба обрабатывают с одинаковой скоростью. Разница появляется под нагрузкой и зависит от модели.
- Память: vLLM распределяет её сам, в SGLang долю задаёте вы.
- Кэш диалогов у SGLang точнее: он экономит больше на длинных диалогах и агентах.
- Безопасность: ни один нельзя выставлять в интернет без прокси.
- vLLM — выбор по умолчанию, SGLang — под агентов и большие кластеры. Схема выбора — в конце.
Как движки инференса устроены внутри, разобрано в отдельной статье. Здесь нужны четыре понятия оттуда: токены, фазы prefill и decode, KV-кэш и батчинг. TTFT — время до первого токена ответа.
Что такое vLLM и SGLang
Сервер инференса держит модель в видеопамяти, принимает запросы по HTTP в формате OpenAI и обрабатывает много запросов одновременно. Путь запроса:
vLLM: кто его делает
- Репозиторий: около 97 тысяч звёзд, лицензия Apache 2.0, новая версия каждые две недели.
- Появился в 2023 году в Беркли. С 2025 года — проект PyTorch Foundation. С января 2026-го за ним стоит компания Inferact (150 млн долларов инвестиций).
- Кто использует: LinkedIn (больше 50 продуктов), Red Hat (основа её продуктов для OpenShift), AWS (SageMaker и Bedrock), NVIDIA (контейнеры NIM 2 содержат vLLM или SGLang).
SGLang: кто его делает
- Репозиторий: около 39 тысяч звёзд, лицензия Apache 2.0, новая версия каждые две недели.
- Появился в 2024 году. Ведёт его некоммерческая LMSYS, авторы рейтинга Chatbot Arena. С 2026 года за ним стоит компания RadixArk (100 млн долларов инвестиций).
- Кто использует: xAI (карточка Grok-2 велит запускать модель через SGLang), Meta (по её докладу в ноябре 2026-го), Cloudflare (Workers AI), LinkedIn (ранжирование в поиске; LinkedIn использует оба сервера).
Чем они отличаются от других способов запустить модель
vLLM и SGLang рассчитаны на много одновременных запросов на своих видеокартах. Для одного пользователя они не быстрее простых программ.
| Способ | Для чего | Отличие от vLLM и SGLang |
|---|---|---|
| llama.cpp, Ollama, LM Studio | модель на своём компьютере | работает даже без видеокарты, сжатые модели GGUF, старт за секунды; под нагрузкой от многих пользователей слабее |
| TensorRT-LLM | максимум скорости на NVIDIA | только NVIDIA, меньше моделей |
| NVIDIA NIM | готовый контейнер с платной поддержкой | не движок: внутри vLLM или SGLang |
| TGI от Hugging Face | бывший главный соперник | в архиве, авторы советуют vLLM и SGLang |
| Dynamo, llm-d, AIBrix | десятки видеокарт в Kubernetes | слой над движками: раздаёт запросы копиям vLLM или SGLang |
| LiteLLM | один адрес для разных моделей, ключи, бюджеты | шлюз перед серверами, модели не запускает |
| Облачный API | оплата за токены | нечего обслуживать; своя видеокарта окупается только при постоянной загрузке |
Подробнее — в карте движков.
vLLM: место среди других систем
Выбор по умолчанию. Самый широкий список моделей и железа. Слои для Kubernetes (llm-d, AIBrix, KServe), Ray Serve и продукты Red Hat в первую очередь поддерживают его. В тестах MLPerf в апреле 2026 года на нём работали 20 участников (подсчёт Red Hat).
SGLang: место среди других систем
Сильнее на запросах с общим началом: агенты, длинные диалоги, один системный промпт у многих пользователей. Часто впереди на очень больших моделях на десятках видеокарт. Те же слои для кластеров его поддерживают, но обычно позже, чем vLLM.
Стенд
- Видеокарта RTX 5070 Ti Laptop, 12 ГБ; Ryzen 9 9955HX; 64 ГБ оперативной памяти.
- Windows 11, WSL2, Docker Desktop.
- Образы
vllm/vllm-openai:v0.34.0иlmsysorg/sglang:v0.5.23-runtime. - Prometheus 3.16, Grafana 13.3, Jaeger 2.23, nginx 1.30 — в той же сети Docker.
Модели — семейство Qwen3.5: понимают картинки, рассуждают перед ответом, вызывают функции, лицензия Apache 2.0.
| Модель | Веса | На 12 ГБ |
|---|---|---|
| Qwen3.5-4B, FP8 | 7,5 ГиБ | основная модель статьи |
| Qwen3.5-2B | 4,3 ГиБ | замеры под нагрузкой |
| Qwen3.5-0.8B | 1,7 ГиБ | две копии сразу, для маршрутизации |
| Qwen3.5-4B без сжатия | 8,7 ГиБ | не запускается |
| Qwen3.5-9B, 4 бита | 8,5 ГиБ | не запускается |
Абсолютные цифры скорости на ноутбуке в разы ниже серверных. Настройки, ошибки и содержание журналов на большом железе те же.
Железо и системы
Обоим серверам нужны Linux, ускоритель с достаточной памятью и свежие драйверы.
vLLM: железо и системы
- ОС: только Linux. Windows — через WSL2 или Docker, Mac — через плагин vllm-metal.
- Python: 3.11–3.14.
- NVIDIA: от T4 и RTX 20xx. Сборки только под CUDA 13. Для старых драйверов —
VLLM_ENABLE_CUDA_COMPATIBILITY=1. - AMD: Instinct MI200, MI300, MI350, Radeon RX 7900 и RX 9000 (ROCm).
- Intel: Arc и серверные ускорители.
- Плагинами: Google TPU, AWS Trainium, Huawei Ascend, Apple Silicon.
- Без видеокарты: работает, для маленьких моделей.
SGLang: железо и системы
- ОС: Linux. Windows в документации не упоминается; в Docker поверх WSL2 работает.
- Python: 3.11 и новее. На 3.10 установка не падает, а ставит старую версию сервера.
- NVIDIA: от A100 до новейших серверных, RTX 30, 40 и 50, DGX Spark, Jetson. Только CUDA 13.
- AMD: Instinct MI300X, MI325X, MI350X, MI355X.
- Intel: Arc и Xeon.
- Прочее: Google TPU, Huawei Ascend, Apple Silicon, Moore Threads.
- RTX 50 и установка через pip: ни одна модель не запускается без ручной настройки путей к компилятору CUDA (открытая задача). В образе Docker проблемы нет.
Установка
Два способа: пакет Python или образ Docker. В продакшене берут образ с номером версии, а не latest: обе программы выходят каждые две недели и регулярно меняют флаги.
Модели скачиваются с Hugging Face при первом запуске в ~/.cache/huggingface. Эту папку подключают к контейнеру, чтобы не качать заново.
vLLM: установка
uv pip install vllm --torch-backend=autovllm download-kernelsВторая команда скачивает готовые ядра для видеокарты. Без неё сервер компилирует их при первом запуске несколько минут. Запускать после каждой установки и обновления.
docker pull vllm/vllm-openai:v0.34.0Образ: 10 ГБ при скачивании, 36 ГБ на диске.
SGLang: установка
uv pip install --prerelease=allow sglangБез --prerelease=allow старые версии uv молча ставят SGLang 0.5.9.
docker pull lmsysorg/sglang:v0.5.23-runtimeОбраз -runtime облегчённый: 14,5 ГБ при скачивании, 50 ГБ на диске. Полный, v0.5.23, содержит ещё инструменты сборки.
Первый запуск
Сервер запускается одной командой. vLLM слушает порт 8000, SGLang — 30000. Запросы к ним одинаковые.
vLLM: первый запуск
docker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ vllm/vllm-openai:v0.34.0 \ RedHatAI/Qwen3.5-4B-FP8-dynamic \ --max-model-len 16384 --max-num-seqs 16--ipc=host— процессы сервера обмениваются данными через общую память.- Том
vllm-cacheхранит скомпилированное при первом запуске. - Готовность: строка
Application startup complete. На стенде — через 155 секунд.
Что сервер пишет о памяти:
Model loading took 6.23 GiB memory and 11.814035 secondsAvailable KV cache memory: 3.99 GiBGraph capturing finished in 1 secs, took 0.14 GiBGPU KV cache size: 34,492 tokens, Maximum concurrency for 16,384 tokens per request: 2.11xПамяти диалогов хватает на 34 492 токена — два диалога максимальной длины.
Запрос:
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "RedHatAI/Qwen3.5-4B-FP8-dynamic", "messages": [{"role": "user", "content": "What is a KV cache in LLM inference? Answer in two sentences."}], "max_tokens": 400 }'В поле content придут рассуждения модели, а не ответ:
Thinking Process:
1.  **Analyze the Request:**    *   Topic: KV cache in Large Language Model (LLM) inference.    *   Constraint: Answer in exactly two sentences....
Сервер не знает, где у модели кончаются рассуждения, пока не задан флаг --reasoning-parser (раздел о настройке).
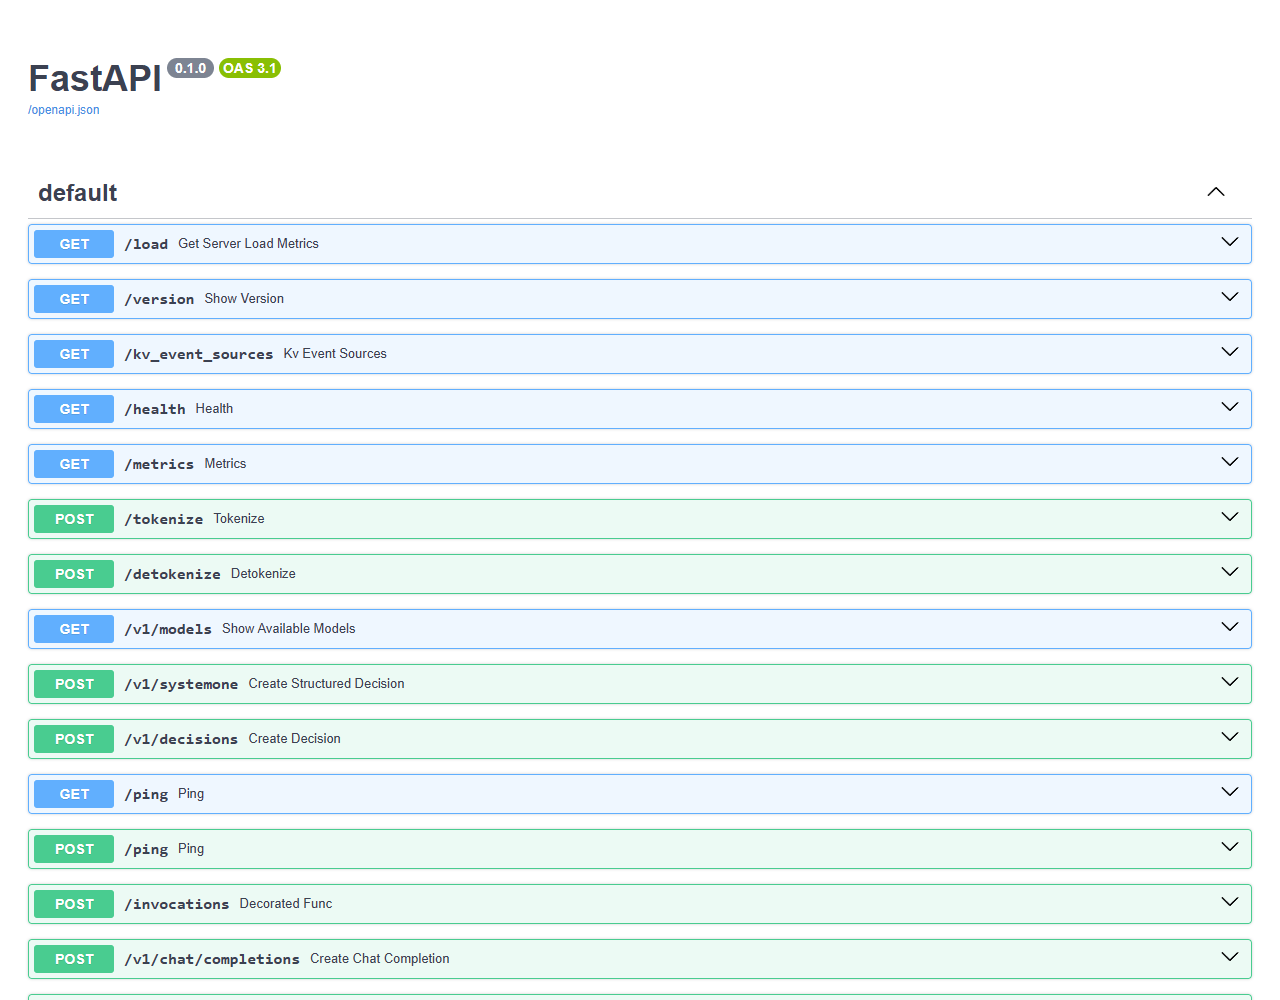
Список всех адресов API — на странице http://localhost:8000/docs, там 24 операции:
SGLang: первый запуск
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --host 0.0.0.0 --port 30000 \ --context-length 16384 --mem-fraction-static 0.8--host 0.0.0.0обязателен в контейнере. По умолчанию сервер слушает127.0.0.1: журнал пишет «готов», а запросы снаружи не проходят.- Готовность: строка
The server is fired up and ready to roll!. На стенде — через 85–100 секунд.
Что сервер пишет о памяти:
Load weight end. elapsed=2.19 s, quant=compressed-tensors, avail mem=4.44 GB, mem usage=6.28 GB.Mamba Cache is allocated. max_mamba_cache_size: 20, conv_state size: 0.02GB, ssm_state size: 0.98GBKV Cache is allocated. #tokens: 38949, K size: 0.59 GB, V size: 0.59 GBmax_total_num_tokens=38949, max_running_requests=4, context_len=16384, available_gpu_mem=0.37 GBПамять диалогов — 38 949 токенов, одновременно не больше четырёх запросов.
Запрос и ответ такие же, как у vLLM, меняется только порт. Рассуждения тоже попадают в content, пока не задан --reasoning-parser.
На странице /docs у SGLang 108 операций:
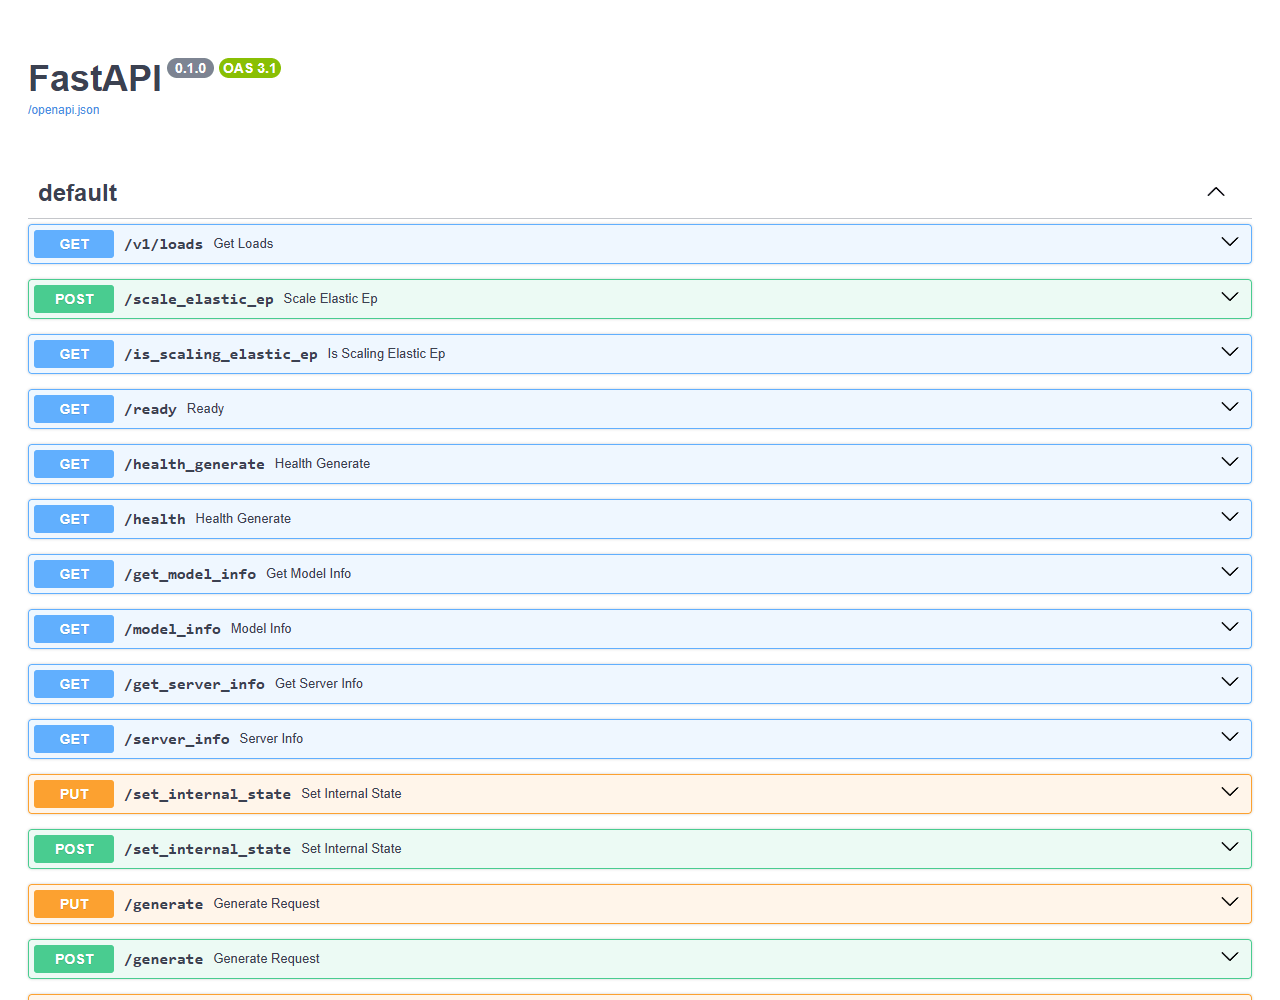
Кроме API для клиентов здесь управление сервером: сброс кэша, обновление весов, загрузка адаптеров, профилирование. Всё это нужно закрыть от посторонних (раздел о сети).
Видеопамять
От видеопамяти зависит, запустится ли модель, сколько диалогов поместится одновременно и какой они могут быть длины. Память делят:
- Веса модели. Размер равен размеру файлов модели и не меняется.
- Память диалогов (KV-кэш). У Qwen3.5-4B — 32 КиБ на токен: диалог на 16 тысяч токенов занимает 512 МиБ. Растёт с числом пользователей.
- Состояние гибридных моделей. У Qwen3.5 обычное внимание только в 8 слоях из 32. Остальные 24 хранят для диалога сжатое состояние постоянного размера. В журналах оно называется Mamba cache.
- Рабочие буферы для вычислений одного шага. На стенде — около 1,6 ГиБ.
- Записанные графы вычислений (CUDA-графы): 0,1–0,5 ГиБ.
- Другие программы. На ноутбуке рабочий стол и браузер занимают 1,2 ГиБ, на выделенном сервере — ничего.
Одна и та же модель в двух серверах:
Порядок, в котором серверы делят память при старте, разный:
Что из этого следует:
- Кроме весов нужно ещё 3–4 ГиБ. Модель, которая по размеру файлов почти равна видеопамяти, не запустится.
- Память диалогов — это остаток после весов, буферов и графов.
- Ручек три: длина диалога, число одновременных запросов, доля памяти сервера.
vLLM: видеопамять
До версии 0.34 сервер забирал 92% видеопамяти заранее. С 0.34 он загружает веса, прогоняет пробные запросы, измеряет буферы и графы и отдаёт памяти диалогов всё, что осталось. Флаг --gpu-memory-utilization теперь лучше не задавать: любое значение только уменьшит память диалогов. Старый совет «не запускается — уменьшите --gpu-memory-utilization» устарел.
Actual usage is 6.33 GiB for consumed memory (weights + non-torch), 1.59 GiB for peak activation, and 0.14 GiB for CUDAGraph memory.Memory after warmup: 4.17 GiB free, 1.59 GiB kept for transient activations; 80 KV cache blocks (1.41 GiB) fit within the requested 11.91 GiB.| Флаг | Что делает |
|---|---|
--max-model-len | максимальная длина диалога в токенах. По умолчанию из модели: у Qwen3.5 это 262 144 |
--max-num-seqs | число одновременных запросов. По умолчанию 256, на больших серверных картах 1024 |
--gpu-memory-utilization | доля видеопамяти сервера. Нужна, когда карту делят несколько программ |
--kv-cache-memory-bytes | точный размер памяти диалогов |
--kv-cache-dtype fp8 | сжатая память диалогов: вдвое больше диалогов |
Когда память диалогов кончается, новые запросы ждут в очереди. Если не хватает уже начатым, сервер вытесняет последний принятый запрос и позже читает его промпт заново. Пользователь видит задержку, а не ошибку.
Две копии сервера на одной видеокарте: каждой --gpu-memory-utilization 0.4, иначе первая займёт всё.
SGLang: видеопамять
Флаг --mem-fraction-static задаёт долю видеопамяти под веса и память диалогов вместе. Остальное достаётся буферам и графам. Без флага сервер считает долю сам; на карте с 12 ГБ получилось 0,63.
Как подбирать, по документации:
- при старте сервер пишет остаток свободной памяти —
available_gpu_mem; - на больших картах норма — 5–8 ГБ остатка;
- остаток намного больше — долю можно поднять;
- сервер падает от нехватки памяти под нагрузкой — долю нужно уменьшить.
На 12 ГБ значение по умолчанию слишком осторожное. Qwen3.5-4B в FP8 с ним не запускается:
RuntimeError: Hybrid (mamba/linear-attention) state cache is too small to serve any requests. max_mamba_cache_size=3, mamba_ratio=5, resulting max_num_reqs=0. Try: (1) reduce --max-running-requests, (2) increase --mem-fraction-static, or (3) use GPUs with more memory.С --mem-fraction-static 0.8 запускается: четыре одновременных запроса.
| Флаг | Что делает |
|---|---|
--mem-fraction-static | доля видеопамяти под веса и память диалогов |
--context-length | максимальная длина диалога в токенах |
--max-running-requests | число одновременных запросов |
--max-total-tokens | точный размер памяти диалогов в токенах |
--chunked-prefill-size | размер кусков, которыми читается длинный промпт. Меньше — меньше буферы |
--kv-cache-dtype fp8_e4m3 | сжатая память диалогов. Для точности нужен файл масштабов: --quantization-param-path |
--mamba-full-memory-ratio, --max-mamba-cache-size | память под состояние гибридных моделей |
Когда память диалогов кончается, SGLang снимает один из выполняющихся запросов и возвращает его в очередь. В журнале: KV cache pool is full. Retract requests. Если это происходит часто, поднимите --schedule-conservativeness.
Что не помещается в 12 ГБ
| Модель | Веса в памяти | vLLM | SGLang |
|---|---|---|---|
| Qwen3.5-4B без сжатия | 8,6 ГиБ | нет места под память диалогов | не хватило 2,57 ГБ под состояние |
| Qwen3.5-9B, 4 бита | 8,4–9,5 ГиБ | то же | то же |
Сжатие до 4 бит уменьшает только основные слои. Блок разбора картинок и таблицы токенов остаются прежними, поэтому модель на 9,7 млрд параметров занимает больше 8 ГиБ.
Отказ vLLM:
Memory after warmup: 0.91 GiB free, 1.59 GiB kept for transient activations; 0 KV cache blocks (0.0 GiB) fit within the requested 11.91 GiB.ValueError: No available memory for the cache blocks. [...] decrease `max_model_len` or `max_num_seqs`, or the model needs a device with more memory.Отказ SGLang:
Load weight end. avail mem=1.37 GB, mem usage=9.35 GB.RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache. Computed max_mamba_cache_size=-27 (total_rest_memory=-2.57 GB, mamba_cache_per_req=49.12 MB).vLLM сообщает о нехватке памяти через 2–4 минуты, в конце прогрева. SGLang — через 20–30 секунд, сразу после загрузки весов.
У vLLM с гибридной моделью бывает ещё одна ошибка при старте: значение --max-num-seqs по умолчанию слишком велико.
ValueError: max_num_seqs (256) exceeds available Mamba cache blocks (42). Please lower max_num_seqs to at most 42 or increase gpu_memory_utilization.Форматы моделей и квантование
Оба сервера работают с форматом safetensors с Hugging Face. GGUF, привычный по llama.cpp и Ollama, — не их формат. Что такое квантование — в разделе о нём.
Сжатую заранее модель оба сервера распознают сами, без флагов.
vLLM: форматы и квантование
- Источники: Hugging Face, папка на диске, ModelScope (
VLLM_USE_MODELSCOPE=True), объектное хранилище (vllm serve s3://bucket/model --load-format runai_streamer). - Готовые сжатые модели: FP8, AWQ, GPTQ, INT8, INT4, NVFP4, MXFP4, compressed-tensors, NVIDIA ModelOpt, AMD Quark.
- Сжатие при загрузке:
--quantization fp8_per_tensor. - GGUF: отдельный плагин
vllm-gguf-plugin, экспериментальный. - bitsandbytes: отдельный плагин
vllm-bnb-plugin. - Сжать свою модель: LLM Compressor.
- LoRA-адаптеры:
--enable-lora --lora-modules sql=путь. Клиент выбирает адаптер полемmodel; запросы к разным адаптерам идут в одном батче.
SGLang: форматы и квантование
- Источники: Hugging Face, папка на диске, ModelScope (
SGLANG_USE_MODELSCOPE=true), адресаs3://,gs://,az://. - Готовые сжатые модели: те же основные форматы. Флаг
--quantizationк уже сжатой модели добавлять нельзя. - Сжатие при загрузке:
--quantization fp8. Сжатие через torchao из версии 0.5.23 убрано. - GGUF: формат загрузки
ggufесть, список поддерживаемых архитектур документация не приводит. - LoRA-адаптеры:
--enable-lora --lora-paths sql=путь. Загружаются и выгружаются на ходу:/load_lora_adapter,/unload_lora_adapter. В запросе:"model": "базовая-модель:адаптер".
Скорость на стенде, один пользователь:
| Модель | vLLM | SGLang |
|---|---|---|
| Qwen3.5-4B, FP8 | 84 токена/с | 56–60 токенов/с |
| Qwen3.5-2B без сжатия | 110 токенов/с | 109 токенов/с |
Вычисления в FP8 для этой модели у vLLM быстрее. На несжатой модели разницы нет.
Настройка
Настройки задаются флагами, файлом YAML или переменными окружения. Если значение есть и во флаге, и в файле, побеждает флаг.
Для рассуждающих моделей и вызова функций нужны два разборщика, свои для каждого семейства моделей:
- reasoning parser отделяет рассуждения от ответа;
- tool call parser превращает текст модели в вызов функции с аргументами.
vLLM: настройка
# vLLM 0.34 — все настройки сервера в одном файлеmodel: RedHatAI/Qwen3.5-4B-FP8-dynamic# Под этим именем модель видят клиентыserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 8000
# Память: самый длинный диалог и число одновременных запросовmax-model-len: 16384max-num-seqs: 16
# Отделять рассуждения модели от ответаreasoning-parser: qwen3# Превращать текст модели в вызовы функцийenable-auto-tool-choice: truetool-call-parser: qwen3_xml
# Показывать в ответе, сколько токенов промпта взято из кэшаenable-prompt-tokens-details: true# Возвращать идентификатор запроса в заголовке X-Request-Idenable-request-id-headers: truedocker run --gpus all --ipc=host -p 8000:8000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v vllm-cache:/root/.cache/vllm \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml- Справка:
vllm serve --help=all— всё,--help=max-num-seqs— один флаг. - Вложенные настройки — через точку:
--logging-config.formatter json. - Короткая запись чисел:
--max-model-len 16K— это 16 384. ЗаглавнаяK— 1024, строчнаяk— 1000. - Параметры генерации из модели. Сервер применяет
generation_config.jsonиз папки модели. Отключается флагом--generation-config vllm. - Переменные окружения:
HF_TOKEN,VLLM_API_KEY,VLLM_LOGGING_LEVEL,VLLM_NO_USAGE_STATS=1(отказ от телеметрии). - Kubernetes: не называйте сервис
vllm. Kubernetes создаст переменные с префиксомVLLM_, и сервер примет их за свои настройки.
SGLang: настройка
# SGLang 0.5.23 — настройки сервера в одном файле.# Модель задаётся в командной строке: sglang serve <модель> --config config.yaml# Под этим именем модель видят клиентыserved-model-name: qwen3.5-4bhost: 0.0.0.0port: 30000
# Память: самый длинный диалог и доля видеопамяти под веса и кэш диалоговcontext-length: 16384mem-fraction-static: 0.8
# Отделять рассуждения модели от ответаreasoning-parser: qwen3# Превращать текст модели в вызовы функцийtool-call-parser: qwen3_coder
# Отдавать метрики для Prometheus по адресу /metricsenable-metrics: true# Показывать в ответе, сколько токенов промпта взято из кэшаenable-cache-report: truedocker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123- Модель — только в командной строке. С
model-pathв файле и без модели в командеsglang serveпадает:Error: --model-path is required. - Ключ доступа — только флагом
--api-key. - Команда запуска:
sglang serve. Прежняяpython -m sglang.launch_serverещё работает и встречается в большинстве инструкций. - Метрики выключены без
--enable-metrics. - Число токенов из кэша в ответе — только с
--enable-cache-report. - Имена разборщиков другие: для той же модели в vLLM
qwen3_xml, здесьqwen3_coder. - Справка надёжнее документации: 91 флаг в таблице документации не описан. Смотрите
sglang serve --help. - Переменные окружения:
HF_TOKEN,SGLANG_CACHE_DIR(папка скомпилированных ядер, подключите её томом),SGLANG_LOGGING_CONFIG_PATH(свой формат журнала).
API
Оба сервера повторяют API OpenAI. Библиотека openai работает с ними без изменений: меняется адрес. Примеры ниже запускались с обоими серверами без правок.
# vLLMexport BASE_URL=http://localhost:8000/v1 API_KEY=sk-lab-123# SGLangexport BASE_URL=http://localhost:30000/v1 API_KEY=sk-lab-123Обычный запрос. Рассуждения приходят отдельно от ответа:
import os
from openai import OpenAI
# Один и тот же код работает с обоими серверами: меняется только адрес.# vLLM: http://localhost:8000/v1, SGLang: http://localhost:30000/v1client = OpenAI(    base_url=os.environ["BASE_URL"],    api_key=os.environ["API_KEY"],)
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {"role": "system", "content": "You are a concise assistant."},        {            "role": "user",            "content": "What is a KV cache in LLM inference? Answer in two sentences.",        },    ],    max_tokens=2048,)
message = response.choices[0].message# Рассуждения приходят отдельным полем: в vLLM оно называется reasoning,# в SGLang — reasoning_contentreasoning = getattr(message, "reasoning", None) or getattr(message, "reasoning_content", None)print("REASONING:", (reasoning or "")[:200].replace("\n", " "), "...")print("ANSWER:", message.content.strip())print("USAGE:", response.usage.prompt_tokens, "+", response.usage.completion_tokens)
REASONING: Thinking Process: 1. **Analyze the Request:** * Topic: KV cache ...ANSWER: A KV cache stores the attention key-value pairs for all previous tokens, allowing the model to retrieve context without re-computing layer activations. This reuse significantly reduces the computational cost and latency of autoregressive inference, particularly when generating long sequences of text.USAGE: 36 + 1565Ответ из двух предложений стоил 1565 токенов: почти всё ушло на рассуждения. С маленьким max_tokens рассуждающая модель не доходит до ответа, и content приходит пустым.
Поток, отключение рассуждений, замер TTFT:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
started = time.perf_counter()first_token_at = Nonetokens = 0
stream = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": "Explain in three sentences why one GPU can serve many LLM requests at once.",        }    ],    max_tokens=300,    stream=True,    # Попросить сервер прислать в конце потока счётчики токенов    stream_options={"include_usage": True},    # Выключить рассуждения: параметр уходит в шаблон чата модели    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
for chunk in stream:    if chunk.usage:        tokens = chunk.usage.completion_tokens    if not chunk.choices:        continue    piece = chunk.choices[0].delta.content    if piece:        if first_token_at is None:            first_token_at = time.perf_counter()        print(piece, end="", flush=True)
total = time.perf_counter() - startedttft = first_token_at - startedspeed = tokens / (total - ttft)print(f"\n\nTTFT: {ttft * 1000:.0f} ms, tokens: {tokens}, speed: {speed:.0f} tokens/s")
vLLM: TTFT: 71 ms, tokens: 93, speed: 84 tokens/sSGLang: TTFT: 82 ms, tokens: 93, speed: 56 tokens/sВызов функций. Модель называет функцию и аргументы, вызывает её ваш код:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Описание функции, которую модели разрешено вызватьtools = [    {        "type": "function",        "function": {            "name": "get_gpu_memory",            "description": "Returns used and total memory of a GPU in megabytes.",            "parameters": {                "type": "object",                "properties": {                    "gpu_index": {                        "type": "integer",                        "description": "Index of the GPU, starting from 0",                    },                },                "required": ["gpu_index"],            },        },    }]
messages = [{"role": "user", "content": "How much memory is free on GPU 0?"}]
# 1. Модель решает, что нужна функция, и возвращает её имя и аргументыfirst = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)call = first.choices[0].message.tool_calls[0]print("CALL:", call.function.name, call.function.arguments)
# 2. Функцию выполняет наш код, а не сервер; здесь ответ подставлен вручнуюresult = {"used_mb": 9896, "total_mb": 12227}messages.append(first.choices[0].message)messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
# 3. Модель получает результат и отвечает человекуsecond = client.chat.completions.create(    model="qwen3.5-4b",    messages=messages,    tools=tools,    max_tokens=1024,)print("ANSWER:", second.choices[0].message.content.strip())
CALL: get_gpu_memory {"gpu_index": 0}ANSWER: GPU 0 has approximately **2.3 GB** free memory.Ответ по схеме. Сервер запрещает модели токены, нарушающие схему, и ответ всегда получается правильным JSON:
import jsonimport os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Схема, которой обязан соответствовать ответschema = {    "type": "object",    "properties": {        "component": {"type": "string", "enum": ["memory", "network", "model", "other"]},        "severity": {"type": "string", "enum": ["low", "medium", "high"]},        "summary": {"type": "string"},    },    "required": ["component", "severity", "summary"],    "additionalProperties": False,}
log_line = "RuntimeError: Not enough GPU memory for hybrid (mamba/linear-attention) state cache."
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "system",            "content": "Classify the log line of an inference server. Keep the summary under 20 words.",        },        {"role": "user", "content": log_line},    ],    # Сервер не даст модели выбрать токен, который нарушает схему    response_format={        "type": "json_schema",        "json_schema": {"name": "incident", "schema": schema, "strict": True},    },    max_tokens=300,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
incident = json.loads(response.choices[0].message.content)print(incident)
{'component': 'memory', 'severity': 'high', 'summary': 'GPU memory insufficient for hybrid attention cache.'}Картинка на входе:
import base64import os
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Картинка уходит в запросе в виде строки base64with open("dashboard.png", "rb") as file:    image = base64.b64encode(file.read()).decode()
response = client.chat.completions.create(    model="qwen3.5-4b",    messages=[        {            "role": "user",            "content": [                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image}"}},                {"type": "text", "text": "What does this picture show? Answer in two sentences."},            ],        }    ],    max_tokens=200,    extra_body={"chat_template_kwargs": {"enable_thinking": False}},)
print(response.choices[0].message.content.strip())print("prompt tokens:", response.usage.prompt_tokens)
Картинка 1200×630 занимает 785 токенов промпта в обоих серверах.
vLLM: что есть кроме API OpenAI
- Responses API:
/v1/responses. - Anthropic Messages API:
/v1/messages. Так подключается Claude Code (инструкция). - Эмбеддинги, переранжирование, распознавание речи.
- Токенизатор:
/tokenize,/detokenize. - gRPC:
vllm serve --grpc. - Поле с рассуждениями:
reasoning. - Заголовок
X-Request-Id: сервер принимает идентификатор запроса от клиента и возвращает его в ответе. - Ключ — только в
Authorization: Bearer. Заголовокx-api-key, который шлют клиенты Anthropic, не принимается: ответ 401.
SGLang: что есть кроме API OpenAI
- Responses API и Anthropic Messages API — на тех же адресах.
x-api-keyтоже не принимается. - API Ollama:
/api/chat,/api/generate,/api/tags. - Эмбеддинги, переранжирование, распознавание речи, токенизатор.
- Запуск без HTTP:
sgl.Engine(model_path=...)в коде на Python. У vLLM для этого классLLM. - Поле с рассуждениями:
reasoning_content. Это единственное место, где клиенту нужно знать, с каким сервером он говорит. - Собственный API
/generate— сырой текст без шаблона чата:
curl http://localhost:30000/generate \ -H "Authorization: Bearer sk-lab-123" -H "Content-Type: application/json" \ -d '{"text": "The capital of Bulgaria is", "sampling_params": {"max_new_tokens": 8, "temperature": 0}}'{ "text": " Sofia. Sofia is the largest city in", "meta_info": { "finish_reason": {"type": "length", "length": 8}, "prompt_tokens": 5, "completion_tokens": 8, "cached_tokens": 0 }}Ответ сокращён: в настоящем ещё два десятка служебных полей.
Сессии и состояние
Оба сервера не хранят диалоги. Клиент в каждом запросе присылает всю историю.
Чтобы не читать историю заново на каждом ходе, работает кэш префиксов: сервер сохраняет память диалога после ответа и берёт из неё совпавшее начало следующего запроса. Кэш включён по умолчанию и не привязан к пользователю: совпадение ищется по тексту.
Диалог из четырёх ходов с системным промптом на 2000 токенов:
import osimport time
from openai import OpenAI
client = OpenAI(base_url=os.environ["BASE_URL"], api_key=os.environ["API_KEY"])
# Длинный системный промпт: около 2000 токенов правил, одинаковых для всех запросовrules = "\n".join(    f"Rule {n}: when the user asks about topic {n}, answer politely and mention the number {n * 7}."    for n in range(1, 81))messages = [{"role": "system", "content": "You are a support assistant.\n" + rules}]
questions = [    "What does rule 5 say?",    "And rule 12?",    "Which rule mentions the number 140?",    "Thanks. Summarize our conversation in one sentence.",]
for turn, question in enumerate(questions, start=1):    messages.append({"role": "user", "content": question})
    started = time.perf_counter()    first_token_at = None    answer = ""    usage = None    stream = client.chat.completions.create(        model="qwen3.5-4b",        messages=messages,        max_tokens=120,        stream=True,        stream_options={"include_usage": True},        extra_body={"chat_template_kwargs": {"enable_thinking": False}},    )    for chunk in stream:        if chunk.usage:            usage = chunk.usage        if chunk.choices and chunk.choices[0].delta.content:            if first_token_at is None:                first_token_at = time.perf_counter()            answer += chunk.choices[0].delta.content
    # Сервер не помнит диалог: историю каждый раз присылает клиент    messages.append({"role": "assistant", "content": answer})
    details = usage.prompt_tokens_details    cached = details.cached_tokens if details else 0    ttft = (first_token_at - started) * 1000    prompt = usage.prompt_tokens    print(f"turn {turn}: prompt {prompt} tokens, from cache {cached}, TTFT {ttft:.0f} ms")
vLLM:
turn 1: prompt 2157 tokens, from cache 0, TTFT 339 msturn 2: prompt 2202 tokens, from cache 1728, TTFT 84 msturn 3: prompt 2253 tokens, from cache 1728, TTFT 155 msturn 4: prompt 2320 tokens, from cache 1728, TTFT 103 msSGLang:
turn 1: prompt 2157 tokens, from cache 0, TTFT 341 msturn 2: prompt 2210 tokens, from cache 2112, TTFT 61 msturn 3: prompt 2266 tokens, from cache 2176, TTFT 55 msturn 4: prompt 2323 tokens, from cache 2240, TTFT 48 msСо второго хода оба отвечают в несколько раз быстрее:
SGLang берёт из кэша почти всё, vLLM — 1728 токенов на каждом ходе:
vLLM: кэш и состояние
Устройство. Память диалогов нарезана на блоки. Сервер считает хэш каждого заполненного блока вместе со всем, что было до него, и сравнивает новый запрос с кэшем блок за блоком. Незаполненный блок в кэш не попадает.
Размер блока — 64 токена (до версии 0.34 — 16). У гибридных моделей больше: у Qwen3.5 — 576 токенов. Отсюда 1728 в примере: это три блока, а до четвёртого диалог не дорос.
Следствие. Общее начало короче блока не кэшируется. При общем системном промпте на 450 токенов vLLM с Qwen3.5 показал попадание в кэш 4%, SGLang на той же нагрузке — 87%. У обычных моделей блок в девять раз меньше, и такого разрыва нет.
Как увидеть работу кэша:
- в ответе:
usage.prompt_tokens_details.cached_tokens(флаг--enable-prompt-tokens-details); - в метриках:
vllm:prefix_cache_hits_total,vllm:prefix_cache_queries_total; - в журнале:
Prefix cache hit rate, каждые десять секунд.
Изоляция клиентов. По времени ответа можно понять, присылал ли кто-то такое же начало запроса. Если клиенты не должны ничего знать друг о друге, добавьте в запросы поле cache_salt, своё для каждого клиента. Запросы с разной солью не делят блоки.
Хранение ответов на сервере (параметр previous_response_id в Responses API) выключено:
404 invalid_request_error, param: response_idResponse with id 'resp_123' not found.Включается переменной VLLM_ENABLE_RESPONSES_API_STORE=1. Ответы лежат в памяти процесса, никогда не удаляются и пропадают при перезапуске. Для продакшена не годится: историю хранит клиент или слой перед сервером.
SGLang: кэш и состояние
Устройство. Кэш — дерево общих начал (radix-дерево). Для нового запроса ищется самое длинное совпадение. Совпадение точнее, чем блоками: в примере 2112 токенов из 2210, и число растёт с каждым ходом. Когда память кончается, удаляются ветки, к которым дольше всего не обращались (--radix-eviction-policy).
Как увидеть работу кэша:
- в ответе: то же поле
cached_tokens(флаг--enable-cache-report); - в метриках:
sglang:cache_hit_rate,sglang:cached_tokens_total; - в журнале, в строке каждого прочитанного промпта:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80, #running-req: 3, #queue-req: 1Из 517 токенов промпта 448 взяты из кэша.
Защита кэша диалога: флаг --enable-session-radix-cache и поле session_id в запросе. Ветки этого диалога удаляются в последнюю очередь. Историю по-прежнему присылает клиент.
Сессии на сервере. Через собственный API можно открыть сессию (/open_session) и присылать только новый текст: сервер допишет его к хранимому контексту. Сделано для обучения с подкреплением и агентов, работает только через /generate. На стенде не запускалось.
Хранение ответов на сервере тоже выключено:
400 invalid_request_error, param: previous_response_idResponse store is disabled. Stateful Responses require --enable-response-store on a standalone server; response storage is unavailable in PD mode.С --enable-response-store включается. Ограничения те же, что у vLLM: память процесса, без срока хранения, после перезапуска пусто.
Сеть и безопасность
Ни один из двух серверов не рассчитан на то, чтобы стоять в интернете без защиты. Ключ доступа есть у обоих, но закрывает не всё. Перед сервером ставят обратный прокси и пропускают наружу только нужные адреса.
- Прокси: TLS, ключи, ограничение числа запросов, список разрешённых адресов.
- Маршрутизатор: выбирает копию сервера (следующий раздел).
- Серверы моделей и мониторинг — во внутренней сети.
Настройка nginx для одного сервера:
upstream llm {    server vllm:8000;    # Держать соединения с сервером модели открытыми    keepalive 32;}
server {    listen 80;    # Запросы с картинками бывают большими    client_max_body_size 20m;
    # Наружу открыт только API для клиентов    location /v1/ {        proxy_pass http://llm;        proxy_http_version 1.1;        proxy_set_header Connection "";        proxy_set_header Host $host;        # Один идентификатор запроса в журналах прокси и сервера модели        proxy_set_header X-Request-Id $request_id;        # Без этого прокси копит ответ и отдаёт его одним куском        proxy_buffering off;        # Длинный ответ может идти минуты        proxy_read_timeout 600s;    }
    # Проверка живости для балансировщика    location = /health {        proxy_pass http://llm;        access_log off;    }
    # Всё остальное, включая /metrics, /invocations и /docs, снаружи недоступно    location / {        return 404;    }}
proxy_buffering off— иначе вместо текста по словам пользователь получит паузу и весь ответ разом.proxy_read_timeout 600s— по умолчанию nginx рвёт соединение после 60 секунд тишины.location / { return 404; }— наружу выходит только перечисленное явно.- Для продакшена добавьте
listen 443 sslи сертификаты. Для SGLang замените адрес наsglang:30000.
Что отвечает сервер на запрос без ключа, когда ключ задан:
| Адрес | vLLM | SGLang |
|---|---|---|
/health | 200 | 200 |
/metrics | 200 | 200 |
/docs, /openapi.json | 200 | 401 |
/version | 200 | — |
/v1/models, /v1/chat/completions | 401 | 401 |
POST /invocations (генерация) | 200 | — |
POST /tokenize | 200 | 401 |
| сведения о сервере, сброс кэша | — | 401 |
vLLM: сеть и безопасность
- Адрес и порт:
--host,--port(по умолчанию все интерфейсы, 8000),--udsдля сокета Unix,--root-pathдля прокси не в корне сайта. - Ключ:
--api-keyилиVLLM_API_KEY. Можно несколько:--api-key k1 k2. - Ключ закрывает только
/v1и несколько служебных префиксов. /invocationsгенерирует без ключа. Адрес сделан для AWS SageMaker и принимает те же запросы, что/v1/chat/completions:
curl -X POST http://localhost:8000/invocations \ -H "Content-Type: application/json" \ -d '{"model": "qwen3.5-4b", "messages": [{"role": "user", "content": "Say OK"}], "max_tokens": 5, "chat_template_kwargs": {"enable_thinking": false}}'{ "id": "chatcmpl-ab039d14c5d03cbf", "object": "chat.completion", "model": "qwen3.5-4b", "choices": [{"index": 0, "message": {"role": "assistant", "content": "OK"}}]}Это задокументированное поведение: страница о безопасности в документации vLLM перечисляет /invocations среди незащищённых адресов. Наружу — только через прокси.
- TLS:
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh(перечитывать сертификаты),--ssl-cert-reqs(проверять сертификат клиента). - CORS: с версии 0.32 запросы с чужих сайтов запрещены. Разрешённые сайты —
--allowed-origins. - Связь между узлами не шифруется. Узлы держат в изолированной сети.
- Картинки по ссылкам: сервер сам скачивает картинку по адресу из запроса, и так его можно направить на внутренние адреса сети. Ограничение —
--allowed-media-domains. - Телеметрия: сервер отправляет разработчикам анонимную статистику (видеокарта, архитектура модели, версия, часть настроек; текстов запросов нет). Отключается
VLLM_NO_USAGE_STATS=1илиDO_NOT_TRACK=1.
SGLang: сеть и безопасность
- Адрес и порт:
--host,--port. По умолчанию127.0.0.1:30000— только с той же машины. - Два ключа:
--api-keyдля клиентов,--admin-api-keyдля управления (обновление весов, сброс кэша, сведения о сервере). - Без ключа открыты только проверки состояния и метрики.
/get_server_infoотдаёт ключ. В ответе все настройки сервера, включаяapi_keyоткрытым текстом. Запрос требует ключа, но каждый клиент с ключом видит все настройки. С--admin-api-keyадрес закрывается для клиентов.- Без
--api-keyоткрыто всё: все 108 операций, включая загрузку адаптеров и обновление весов. - CORS открыт для всех сайтов. Это прописано в коде, флага для ограничения нет.
- TLS: те же
--ssl-keyfile,--ssl-certfile,--enable-ssl-refresh. HTTP/2 —--enable-http2. - Связь между узлами не шифруется.
- Картинки по ссылкам:
--allowed-media-domains. Без него сервер скачивает с любого адреса. - Телеметрия: нет.
Несколько копий и маршрутизация
Когда одной видеокарты мало, запускают несколько копий сервера и раздают запросы между ними. Кэш префиксов у каждой копии свой. Если следующий ход диалога попадёт на другую копию, она прочитает всю историю заново. Поэтому для серверов моделей есть маршрутизаторы, которые отправляют запрос туда, где его начало уже в кэше.
Замер на стенде: две копии Qwen3.5-0.8B на одной видеокарте, шесть диалогов по пять ходов с длинным системным промптом.
| Сервер | Раздача запросов | Токенов промпта из кэша |
|---|---|---|
| vLLM | одна копия | 59% |
| vLLM | nginx, менее занятому | 34% |
| vLLM | vLLM Router, с учётом кэша | 52% |
| SGLang | маршрутизатор, по кругу | 53% |
| SGLang | маршрутизатор, с учётом кэша | 73% |
Раздача без учёта кэша отнимает у vLLM почти половину попаданий. Тест маленький (30 запросов), доли от прогона к прогону немного меняются.
vLLM: копии и маршрутизация
nginx — вариант из документации vLLM. Меняется начало настройки из раздела о сети:
upstream llm { # Новый запрос уходит тому серверу, у которого меньше открытых соединений least_conn; server vllm-a:8000 max_fails=3 fail_timeout=30s; server vllm-b:8000 max_fails=3 fail_timeout=30s; keepalive 32;}vLLM Router — маршрутизатор на Rust от команды vLLM. Вырос из маршрутизатора SGLang (анонс).
pip install vllm-router==0.1.17vllm-router \ --worker-urls http://vllm-a:8000 http://vllm-b:8000 \ --policy cache_aware \ --host 0.0.0.0 --port 8090Правила раздачи (--policy):
| Значение | Как раздаёт |
|---|---|
round_robin | по кругу |
random | случайно |
power_of_two | менее занятому из двух случайных |
consistent_hash | по хэшу запроса |
sticky_least_loaded | менее занятому, с закреплением диалога |
cache_aware | туда, где начало запроса в кэше |
kv_aware | по сведениям о кэше от самих серверов |
Ещё умеет: повтор неудавшихся запросов, исключение сбоящей копии, поиск копий в Kubernetes.
Production Stack — набор для Kubernetes от той же команды: маршрутизатор, серверы, мониторинг, ставится через Helm. На стенде не запускался.
Слои для кластеров: llm-d, AIBrix, NVIDIA Dynamo, KServe — для каждого есть страница в документации vLLM.
SGLang: копии и маршрутизация
Маршрутизатор лежит в образе сервера:
docker run -d --name sglang-router --network lab -p 30010:30000 \ --entrypoint python lmsysorg/sglang:v0.5.23-runtime \ -m sglang_router.launch_router \ --worker-urls http://sglang-a:30000 http://sglang-b:30000 \ --policy cache_aware \ --host 0.0.0.0 --port 30000 --prometheus-port 29000Правила раздачи: round_robin, random, power_of_two, cache_aware, consistent_hashing, prefix_hash, bucket, manual. Ещё умеет: повтор запросов, исключение сбоящих копий, ограничение числа одновременных запросов, поиск копий в Kubernetes. Свои метрики отдаёт на отдельном порту.
Маршрутизаторов у SGLang сейчас три:
| Проект | Пакет | Состояние |
|---|---|---|
| SGLang Model Gateway | sglang-router | в образе и в документации; пакет не обновлялся с января 2026 |
| SMG | smg | продолжение первого в отдельном репозитории; работает и с vLLM |
| sgl-router | sgl-router | новый облегчённый, первая версия 18 ноября 2026 |
Перед выбором проверьте, какой из них развивается.
Копии внутри одного сервера: --dp-size N. Документация для этого случая сама советует маршрутизатор.
Слои для кластеров: llm-d, AIBrix, Dynamo и собственный оператор для Kubernetes — OME.
Наблюдаемость
- Метрики — счётчики и времена в формате Prometheus по адресу
/metricsна основном порту. - Журналы — что сервер делает, по желанию каждый запрос.
- Трассировка — путь одного запроса по шагам, по стандарту OpenTelemetry.
Времена, которые показывают метрики и трассы:
Prometheus, Grafana и Jaeger рядом с серверами:
# Prometheus, Grafana и Jaeger рядом с серверами моделей.# Сеть lab создана заранее: docker network create labservices:  prometheus:    image: prom/prometheus:latest    container_name: prometheus    volumes:      - ./prometheus.yaml:/etc/prometheus/prometheus.yml:ro    ports:      - "9090:9090"    networks: [lab]
  grafana:    image: grafana/grafana:latest    container_name: grafana    environment:      # Вход без пароля — только для стенда на своём компьютере      - GF_AUTH_ANONYMOUS_ENABLED=true      - GF_AUTH_ANONYMOUS_ORG_ROLE=Admin    volumes:      # Источник данных и дашборды подключаются сами при старте      - ./provisioning:/etc/grafana/provisioning:ro      - ./dashboards:/var/lib/grafana/dashboards:ro    ports:      - "3000:3000"    networks: [lab]    depends_on: [prometheus]
  jaeger:    image: jaegertracing/jaeger:latest    container_name: jaeger    ports:      - "16686:16686" # веб-интерфейс      - "4317:4317"   # приём трасс по OTLP gRPC      - "4318:4318"   # приём трасс по OTLP HTTP    networks: [lab]
networks: lab: external: trueglobal: scrape_interval: 5s
scrape_configs: # Оба сервера отдают метрики по адресу /metrics на своём основном порту - job_name: vllm static_configs: - targets: ["vllm:8000"]
- job_name: sglang static_configs: - targets: ["sglang:30000"]Два файла, чтобы Grafana сама подключила Prometheus и дашборды из папки:
apiVersion: 1datasources: - name: Prometheus uid: prometheus type: prometheus access: proxy url: http://prometheus:9090 isDefault: trueapiVersion: 1providers: - name: lab type: file options: path: /var/lib/grafana/dashboardsГрафики ниже сняты под одинаковой нагрузкой: восемь клиентов без пауз, общий системный промпт, Qwen3.5-4B в FP8, четыре минуты.
vLLM: метрики, журналы, трассировка
Метрики включены всегда.
| Метрика | Что показывает |
|---|---|
vllm:num_requests_running | запросов выполняется |
vllm:num_requests_waiting | запросов в очереди. Главный сигнал для добавления копий |
vllm:kv_cache_usage_perc | заполненность памяти диалогов, 0–1 |
vllm:time_to_first_token_seconds | время до первого токена |
vllm:inter_token_latency_seconds | пауза между токенами |
vllm:e2e_request_latency_seconds | время запроса целиком |
vllm:prompt_tokens_total, vllm:generation_tokens_total | прочитано и написано токенов |
vllm:prefix_cache_hits_total, vllm:prefix_cache_queries_total | попадания в кэш префиксов |
vllm:num_preemptions_total | вытеснения запросов из-за нехватки памяти |
vllm:request_success_total | законченные запросы с причиной окончания |
Дашборд — в репозитории: examples/observability/prometheus_grafana/grafana.json. Он рассчитан на ручной импорт; для автоматического подключения замените переменную источника данных:
sed -i 's/${DS_PROMETHEUS}/prometheus/g' monitoring/dashboards/vllm.json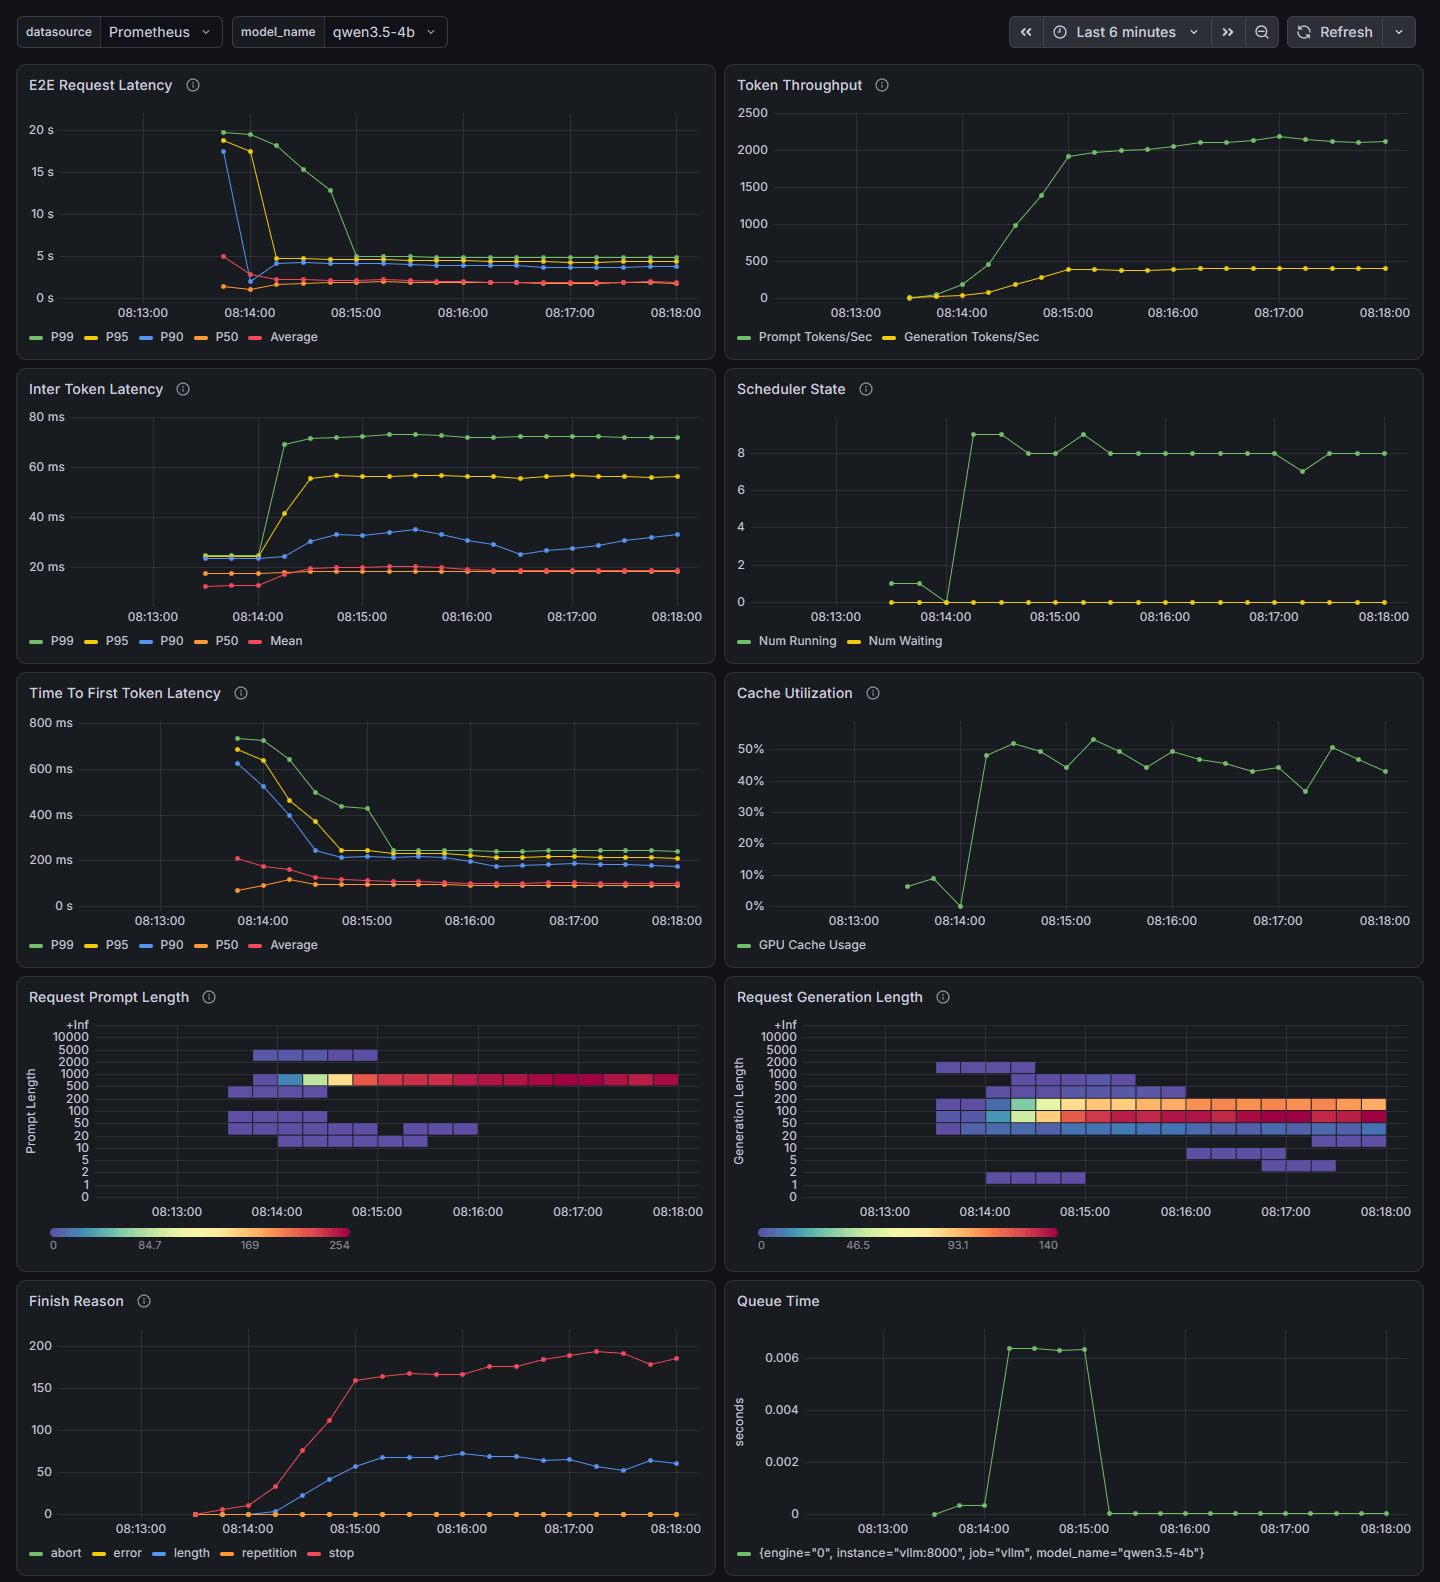
На графиках: восемь запросов выполняются, очереди нет; около 400 токенов в секунду на выходе; первый токен в среднем через 0,1 секунды; память диалогов заполнена наполовину.
Журнал. Каждые десять секунд — строка с итогами:
Engine 000: Avg prompt throughput: 1913.3 tokens/s, Avg generation throughput: 371.4 tokens/s, Running: 9 reqs, Waiting: 0 reqs, GPU KV cache usage: 49.4%, Prefix cache hit rate: 3.6%| Флаг | Что делает |
|---|---|
--enable-log-requests | строка о каждом запросе: идентификатор и параметры. Тексты — только на уровне DEBUG |
--enable-log-outputs | писать и ответы |
--max-log-len | обрезать длинные тексты |
--disable-access-log-for-endpoints /health,/metrics | не писать о проверках состояния |
--logging-config.formatter json | журнал в JSON |
Строка журнала в JSON:
{ "asctime": "2026-11-21 06:22:43,840", "levelname": "INFO", "name": "vllm.v1.core.kv_cache_utils", "processName": "EngineCore", "process": 99, "message": "GPU KV cache size: 171,008 tokens, ..."}Трассировка. Библиотеки уже в образе. Нужны адрес приёмника и две переменные:
docker run --gpus all --ipc=host -p 8000:8000 --network lab --name vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./vllm:/lab/vllm \ -e VLLM_API_KEY=sk-lab-123 \ -e OTEL_SERVICE_NAME=vllm \ -e OTEL_EXPORTER_OTLP_TRACES_INSECURE=true \ vllm/vllm-openai:v0.34.0 \ --config /lab/vllm/config.yaml \ --otlp-traces-endpoint grpc://jaeger:4317 --enable-log-requestsНа каждый запрос vLLM пишет одну запись с готовыми числами:
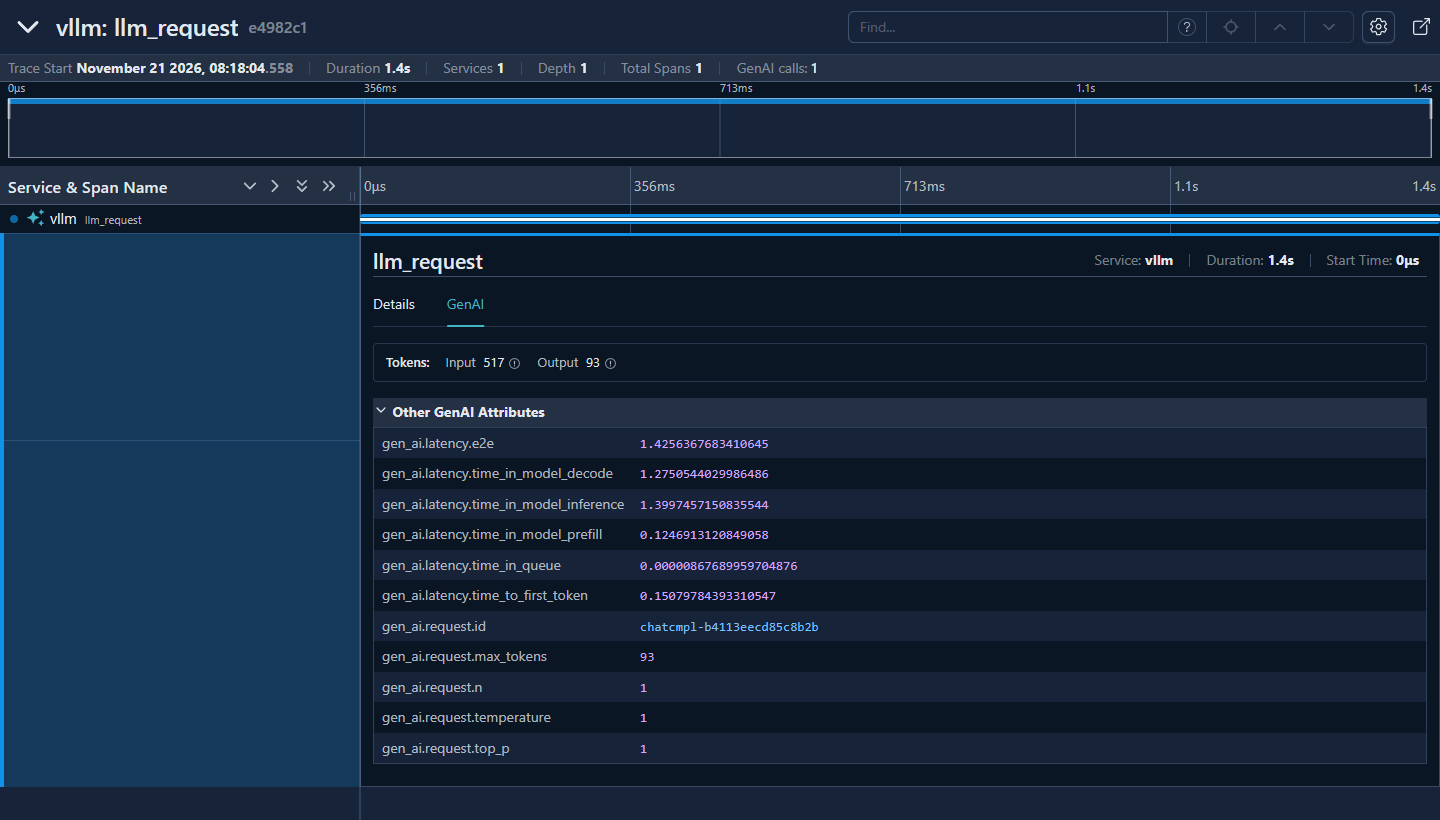
Промпт из 517 токенов читался 0,12 секунды, ответ из 93 токенов писался 1,28 секунды, первый токен пришёл через 0,15 секунды. Имена полей — из соглашения OpenTelemetry для генеративного ИИ.
SGLang: метрики, журналы, трассировка
Метрики включаются флагом --enable-metrics.
| Метрика | Что показывает |
|---|---|
sglang:num_running_reqs | запросов выполняется |
sglang:num_queue_reqs | запросов в очереди |
sglang:token_usage | заполненность памяти диалогов |
sglang:mamba_usage | заполненность памяти состояния у гибридных моделей |
sglang:time_to_first_token_seconds | время до первого токена |
sglang:inter_token_latency_seconds | пауза между токенами |
sglang:e2e_request_latency_seconds | время запроса целиком |
sglang:gen_throughput | скорость генерации, токенов в секунду |
sglang:cache_hit_rate | доля токенов промпта из кэша |
sglang:num_retracted_requests_total | снятые запросы из-за нехватки памяти |
Дашборд — в репозитории: examples/monitoring/grafana/dashboards/json/sglang-dashboard.json. В версии 0.5.23 он не показывает данные:
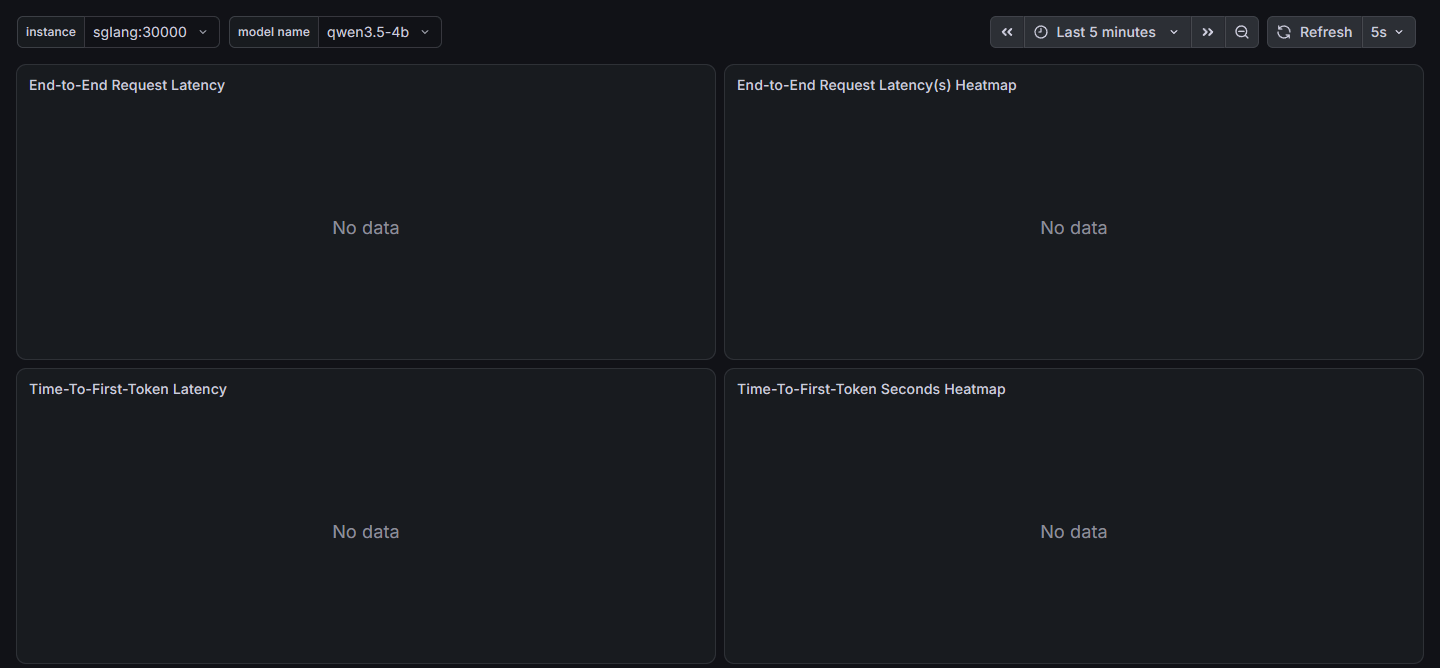
Сервер публикует метрики с двоеточием (sglang:num_running_reqs), а запросы в дашборде написаны с подчёркиванием (sglang_num_running_reqs). Исправление:
sed -i 's/sglang_/sglang:/g' monitoring/dashboards/sglang.json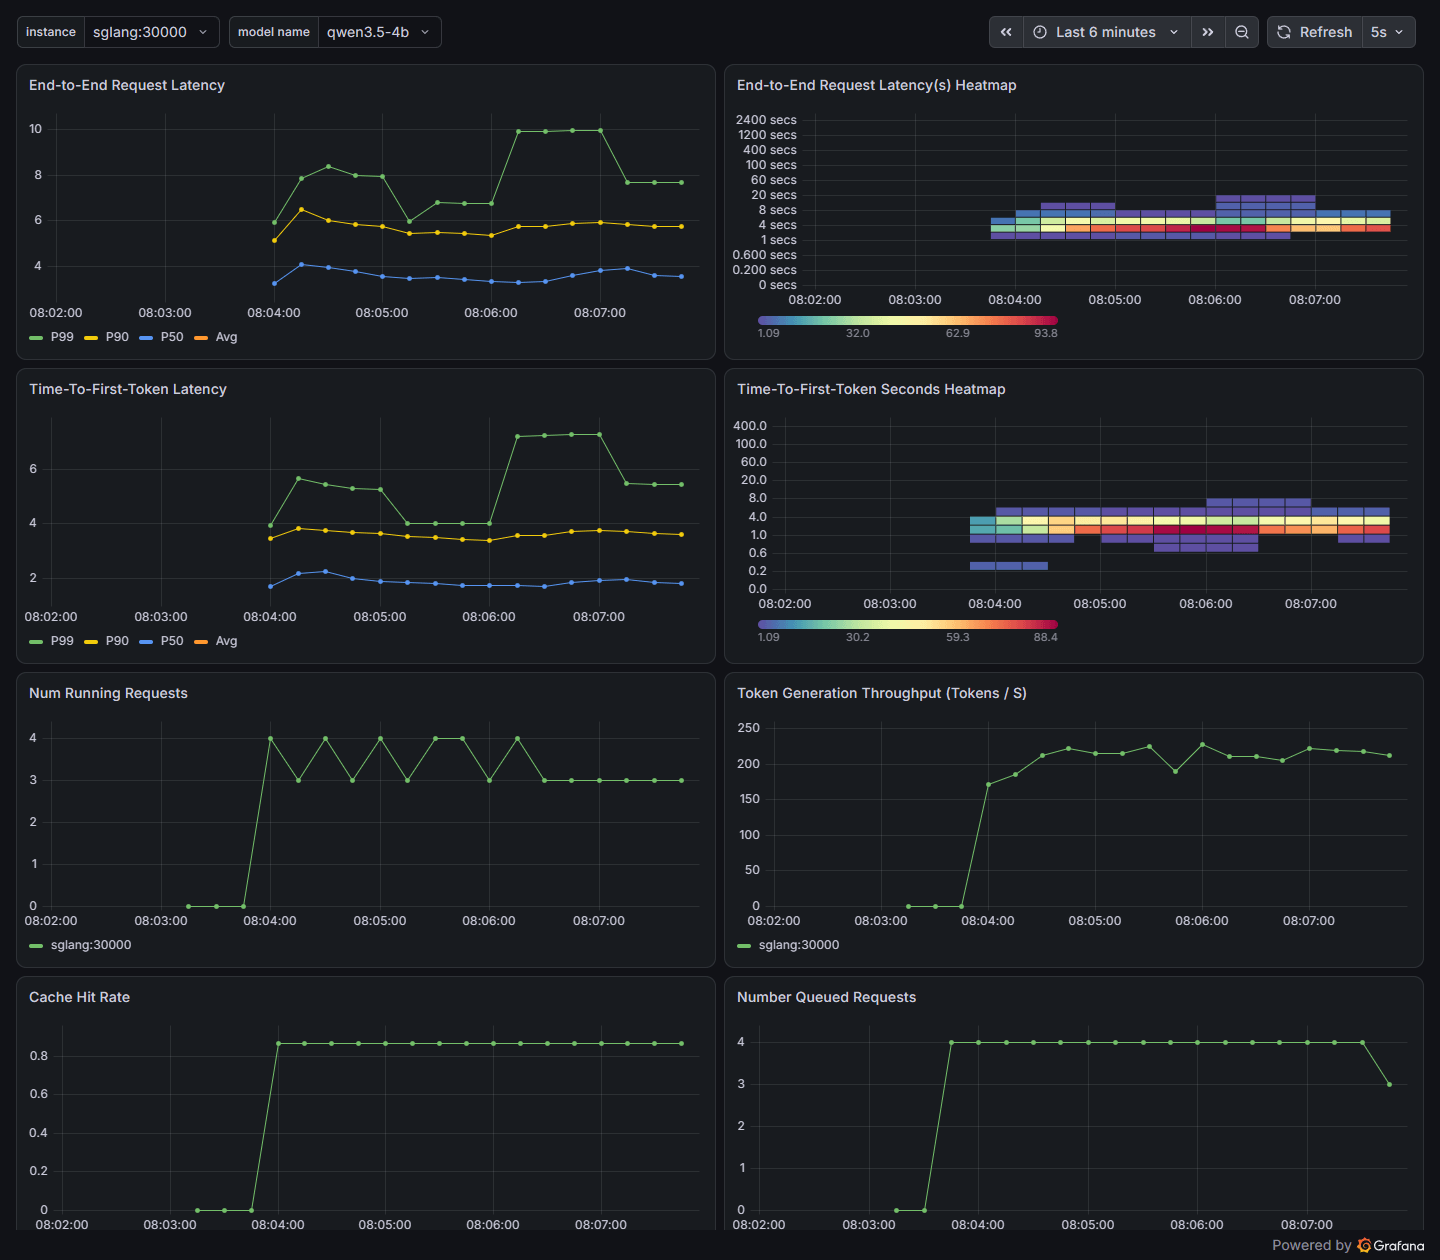
На графиках: четыре запроса выполняются, четыре в очереди — больше на этой видеокарте с этой моделью не помещается; около 215 токенов в секунду; первый токен через 2–4 секунды из-за очереди; попадание в кэш 0,87.
Журнал. Строка на каждое чтение промпта и раз в 40 шагов генерации:
Prefill batch, #new-seq: 1, #new-token: 69, #cached-token: 448, full token usage: 0.02, mamba usage: 0.80,Decode batch, #running-req: 4, #full token: 1011, full token usage: 0.03, mamba num: 16, mamba usage: 0.80, gen throughput (token/s): 217.87, #queue-req: 4Память диалогов почти пуста (full token usage: 0.03), память состояния заполнена на 80% (mamba usage: 0.80). Узкое место — она.
| Флаг | Что делает |
|---|---|
--log-requests | писать о каждом запросе |
--log-requests-level | подробность от 0 (метаданные) до 3 (полные тексты) |
--log-requests-format json | записи о запросах в JSON |
--log-requests-target | куда писать: консоль, папка или оба |
--log-level, --log-level-http | подробность журнала сервера и HTTP |
Запись о запросе в JSON, сокращённая:
{ "timestamp": "2026-11-21T06:09:40.003283", "event": "request.finished", "rid": "369fb465a2ce4d5294e441b2e8fdba7f", "obj": { "sampling_params": {"temperature": 1.0, "max_new_tokens": 120, "top_p": 1.0}, "stream": true }}В JSON пишутся только записи о запросах. Остальной журнал — текст; для JSON нужен свой файл настройки журнала (SGLANG_LOGGING_CONFIG_PATH).
Трассировка:
docker run --gpus all --ipc=host --shm-size 16g -p 30000:30000 --network lab --name sglang \ -v ~/.cache/huggingface:/root/.cache/huggingface \ -v ./sglang:/lab/sglang \ lmsysorg/sglang:v0.5.23-runtime \ sglang serve RedHatAI/Qwen3.5-4B-FP8-dynamic \ --config /lab/sglang/config.yaml --api-key sk-lab-123 \ --enable-trace --otlp-traces-endpoint jaeger:4317 \ --log-requests --log-requests-level 1 --log-requests-format jsonSGLang пишет дерево шагов:
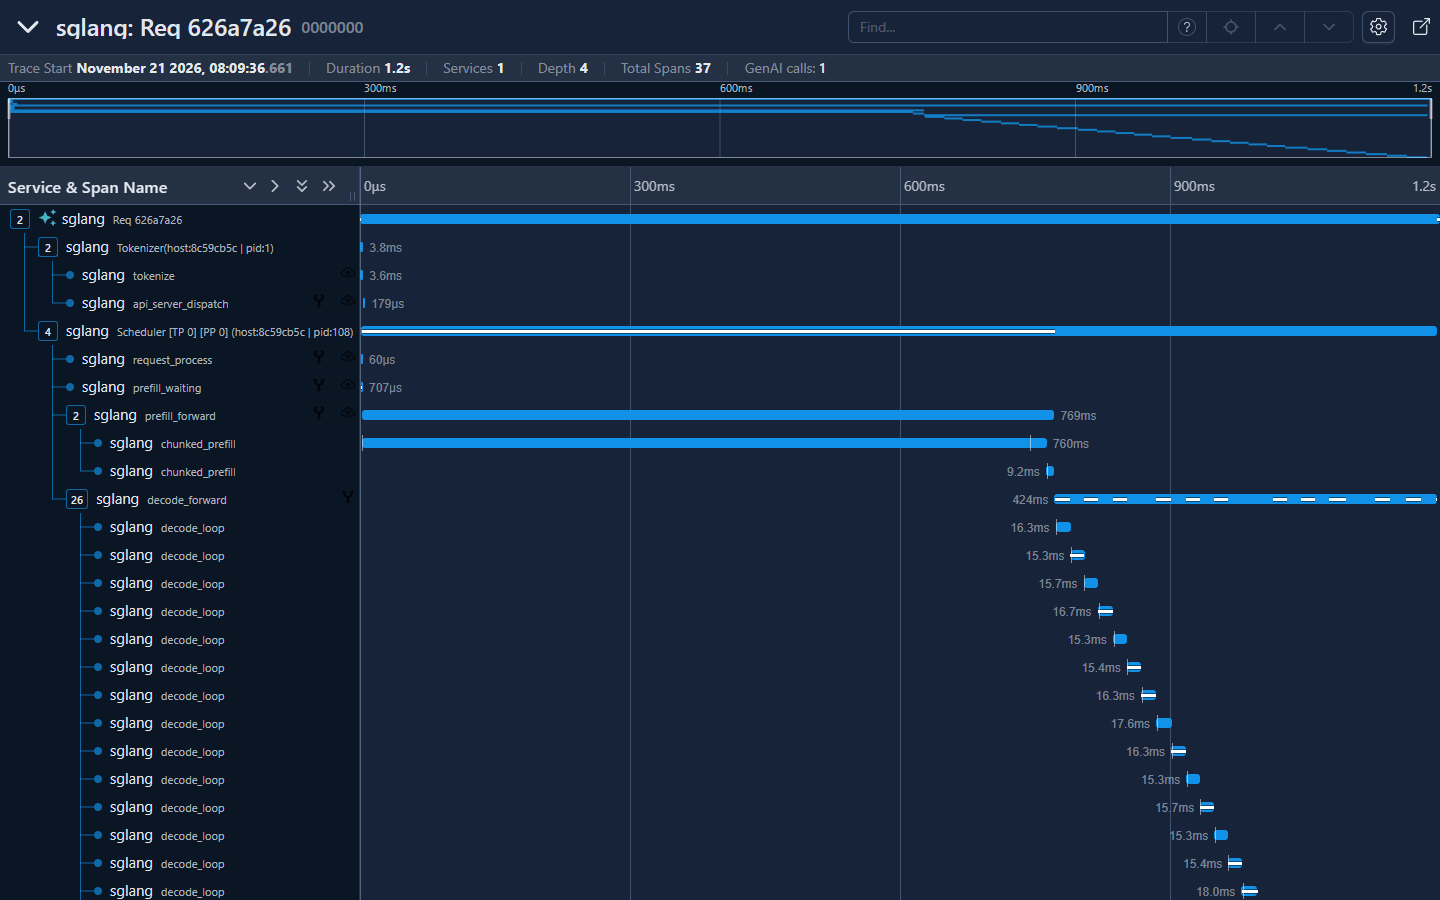
Токенизация — 3,6 мс, чтение промпта из 2157 токенов — 769 мс, дальше генерация порциями по 16 мс.
Запись vLLM легче: одно событие на запрос. Дерево SGLang подробнее, но это десятки записей на запрос; подробность снижается переменной SGLANG_TRACE_LEVEL.
Проверки состояния
| vLLM | SGLang | |
|---|---|---|
| Процесс жив | /health: 200 или 503 | /health |
| Сервер реально генерирует | — | /health_generate: генерирует один токен |
| Готов принимать запросы | — | /ready: 503 во время запуска, паузы и остановки |
Пока модель загружается, порт vLLM закрыт. В Kubernetes нужна стартовая проверка (startupProbe) с запасом в несколько минут, иначе под будет перезапускаться бесконечно.
Производительность
Общего ответа «кто быстрее» нет. Независимые замеры 2026 года расходятся:
- Winder.AI, сентябрь, H100, Qwen3.8-27B: SGLang впереди на 7%.
- Jarvislabs, май, H100, модели Qwen прошлых поколений: впереди vLLM.
- Каким публичным тестам верить — в разделе о бенчмарках.
Замер на стенде:
- Модель: Qwen3.5-2B без сжатия.
- Клиент:
vllm bench serveдля обоих серверов. Промпт — 512 случайных токенов, ответ — 256 токенов. На каждом уровне новые промпты. - vLLM:
--max-model-len 8192 --max-num-seqs 64. - SGLang: с настройками по умолчанию и настроенный.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name random --random-input-len 512 --random-output-len 256 \ --num-prompts 96 --max-concurrency 16 --ignore-eos --seed 42185Скорость генерации, токенов в секунду:
| Одновременных запросов | vLLM | SGLang по умолчанию | SGLang настроенный |
|---|---|---|---|
| 1 | 110 | 109 | 107 |
| 4 | 468 | 454 | 416 |
| 16 | 1382 | 753 | 1150 |
| 32 | 1756 | 783 | 1427 |
| 64 | 2415 | 756 | 1518 |
Медианное время до первого токена, миллисекунды:
| Одновременных запросов | vLLM | SGLang по умолчанию | SGLang настроенный |
|---|---|---|---|
| 1 | 43 | 45 | 46 |
| 4 | 134 | 154 | 157 |
| 16 | 293 | 400 | 361 |
| 32 | 306 | 7796 | 698 |
| 64 | 330 | 16 667 | 5529 |
Выводы:
- Для одного пользователя серверы равны.
- Батчинг работает в обоих. 64 одновременных запроса дают у vLLM в 22 раза больше текста, чем один.
- SGLang по умолчанию ограничил себя 12 запросами: мало памяти под состояние гибридной модели. Остальные запросы ждали в очереди.
- После настройки SGLang вдвое быстрее (29 одновременных запросов), но vLLM не догнал.
Настроенный SGLang:
sglang serve Qwen/Qwen3.5-2B --host 0.0.0.0 \ --served-model-name qwen3.5-2b --context-length 8192 --enable-metrics \ --max-running-requests 64 --mamba-full-memory-ratio 4 \ --cuda-graph-max-bs-decode 64 --mem-fraction-static 0.72Запросы с общим началом: четыре начала по 3000 токенов, по 24 запроса на каждое, восемь одновременно.
docker run --rm --network lab --gpus all --entrypoint vllm \ -v ~/.cache/huggingface:/root/.cache/huggingface \ vllm/vllm-openai:v0.34.0 bench serve \ --backend openai --base-url http://vllm:8000 --endpoint /v1/completions \ --model qwen3.5-2b --tokenizer Qwen/Qwen3.5-2B \ --dataset-name prefix_repetition \ --prefix-repetition-num-prefixes 4 --prefix-repetition-prefix-len 3000 \ --prefix-repetition-suffix-len 200 --prefix-repetition-output-len 100 \ --num-prompts 96 --max-concurrency 8 --ignore-eos --seed 43995| vLLM | SGLang | |
|---|---|---|
| Скорость генерации, токенов в секунду | 689 | 653 |
| Медианное время до первого токена | 141 мс | 172 мс |
| Токенов промпта из кэша | 86% | 92% |
На длинном общем начале серверы равны. Разница видна на коротких совпадениях и в диалоге, который растёт понемногу (раздел о сессиях).
Ограничения замера:
- Ноутбук. На серверной карте с 80 ГБ память под состояние не будет узким местом.
- Гибридная модель. Отставание SGLang связано с тем, как он размещает её состояние. На обычных моделях бывает наоборот.
- Память на пределе. Настроенный SGLang занял 11,3 из 12 ГБ.
- Случайные промпты — худший случай для кэша.
Замерьте оба сервера на своей модели, своей видеокарте и своей нагрузке.
vLLM: что настраивать для скорости
| Настройка | Действие |
|---|---|
--max-num-seqs | потолок одновременных запросов. Больше — выше общая скорость, длиннее пауза между токенами у каждого |
--max-num-batched-tokens | токенов за шаг. Меньше — ровнее паузы, больше — быстрее первый токен |
--performance-mode | готовые наборы: balanced, interactivity, throughput |
-O0 … -O3 | уровень оптимизации. -O0 — быстрый старт и медленная работа |
--spec-method, --spec-model, --spec-tokens | спекулятивное декодирование |
том /root/.cache/vllm | кэш компиляции; без него каждый новый контейнер компилирует заново |
VLLM_WSL2_ENABLE_PIN_MEMORY=1 | под WSL2 около 12% скорости генерации, по замеру из обсуждений проекта. На стенде не проверялось |
SGLang: что настраивать для скорости
| Настройка | Действие |
|---|---|
--max-running-requests | потолок одновременных запросов |
--cuda-graph-max-bs-decode | самый большой батч, для которого записан граф. На картах меньше 20 ГБ — 8; сверх этого сервер работает без графа и медленнее |
--schedule-policy | порядок очереди. fcfs — по времени прихода, lpm — сначала с самым длинным совпадением в кэше |
--schedule-conservativeness | осторожность приёма запросов. Меньше 1 — смелее |
--chunked-prefill-size | размер кусков чтения промпта |
--mamba-full-memory-ratio, --max-mamba-cache-size | память под состояние гибридных моделей |
--speculative-algorithm | спекулятивное декодирование |
SGLANG_CACHE_DIR и том | кэш скомпилированных ядер |
Правило из документации: память диалогов заполнена меньше чем на 90%, а очередь не пуста — уменьшите --schedule-conservativeness.
Несколько видеокарт
Раздел написан по документации, без запуска. Способы разложить модель по картам описаны в разделе о масштабировании; здесь — флаги.
| Способ | vLLM | SGLang |
|---|---|---|
| Слои делятся между картами (TP) | --tensor-parallel-size | --tp-size |
| Слои по очереди на разных картах (PP) | --pipeline-parallel-size | --pp-size |
| Копии модели (DP) | --data-parallel-size | --dp-size |
| Эксперты MoE по картам (EP) | --enable-expert-parallel | --ep-size |
vLLM: несколько видеокарт
Четыре карты одного сервера:
vllm serve <модель> --tensor-parallel-size 4Два сервера по восемь карт, главный узел и второй:
vllm serve <модель> --tensor-parallel-size 8 --pipeline-parallel-size 2 \  --nnodes 2 --node-rank 0 --master-addr <адрес главного узла>
vllm serve <модель> --tensor-parallel-size 8 --pipeline-parallel-size 2 \ --nnodes 2 --node-rank 1 --master-addr <адрес главного узла> --headless- Разделение prefill и decode по разным серверам есть, но помечено экспериментальным. Оно выравнивает задержки, а не увеличивает общую скорость. В продакшене его делают через llm-d, Dynamo или AIBrix.
- Выгрузка памяти диалогов в оперативную память:
--kv-offloading-size. - Автомасштабирование в Kubernetes — по метрике
vllm:num_requests_waiting. Загрузка процессора здесь ничего не говорит.
SGLang: несколько видеокарт
Четыре карты одного сервера:
sglang serve <модель> --tp-size 4Два сервера по четыре карты:
sglang serve <модель> --tp-size 4 --nnodes 2 --node-rank 0 \  --dist-init-addr <адрес первого узла>:50000
sglang serve <модель> --tp-size 4 --nnodes 2 --node-rank 1 \ --dist-init-addr <адрес первого узла>:50000- Разделение prefill и decode — сильная сторона SGLang: серверы с
--disaggregation-mode prefillи--disaggregation-mode decode, перед ними маршрутизатор с--pd-disaggregation. - Многоуровневый кэш HiCache: память диалогов выгружается в оперативную память и на диск.
- Большие модели с экспертами:
--attn-dp-size.
Обновления
Обе программы выходят каждые две недели, и в каждой версии что-то переименовано или убрано.
- Фиксируйте версию образа.
- Читайте раздел о несовместимых изменениях в примечаниях к выпуску.
- Проверяйте обновление на копии с той же моделью.
vLLM: обновления
| Версия | Что сломалось |
|---|---|
| 0.34 | память диалогов считается по-новому; блок кэша 64 токена вместо 16 |
| 0.33 | убраны сборки под CUDA 12 и два способа спекулятивного декодирования |
| 0.32 | убран Python 3.10; запросы из браузера с чужих сайтов запрещены |
| 0.31 | сжатие fp8 переименовано в fp8_per_tensor |
- Документация отстаёт. В 0.34 страница установки называет сборкой по умолчанию CUDA 12.9, хотя пакеты собраны под 13.0. Верьте
vllm serve --help=all. - Вызовы функций проверяйте на своих данных. У хостинга Ubicloud они соответствовали схеме в 92% случаев, пока не включили строгую проверку на сервере (разбор).
SGLang: обновления
| Версия | Что сломалось |
|---|---|
| 0.5.23 | маршрутизатор переехал, его флаги переименованы |
| 0.5.22 | нужен Python 3.11; --enable-dp-attention заменён на --attn-dp-size |
| 0.5.21 | убраны несколько адресов API; шаблон чата из запроса отклоняется |
| 0.5.20 | убраны сборки под CUDA 12 и 17 флагов; хранилище Responses API выключено |
- Устаревшее убирают через два выпуска, то есть через месяц.
- Ставьте обновления безопасности. С 27 августа по 9 сентября 2026 года сервис Cloudflare на SGLang вернул в 155 ответах данные других клиентов: ошибка SGLang в режиме разделения фаз плюс неверная настройка памяти у Cloudflare (разбор). Исправлено в 0.5.20–0.5.22.
- Версия 1.0 объявлена в ноябре 2026 года, но ещё не вышла.
Частые ошибки
| Что происходит | Причина | Что делать |
|---|---|---|
| Сервер не запускается, хотя модель меньше видеопамяти | кроме весов нужно 3–4 ГиБ | модель меньше или сжатая; раздел о видеопамяти |
| Вместо ответа приходят рассуждения | не задан разборщик рассуждений | --reasoning-parser |
| Вызов функции приходит текстом | не задан разборщик вызовов | --tool-call-parser |
| SGLang в контейнере не отвечает снаружи | слушает 127.0.0.1 | --host 0.0.0.0 |
SGLang: --model-path is required | модель указана только в файле настроек | модель в командной строке |
SGLang: state cache is too small | мала доля памяти по умолчанию | --mem-fraction-static 0.8 |
vLLM: max_num_seqs exceeds available Mamba cache blocks | слишком много одновременных запросов для гибридной модели | уменьшить --max-num-seqs |
| Дашборд SGLang пуст | в запросах sglang_ вместо sglang: | заменить имена метрик |
| vLLM отвечает без ключа | /invocations не защищён ключом | прокси со списком адресов |
| Клиент SGLang видит ключ сервера | /get_server_info отдаёт настройки | --admin-api-key |
| Общий системный промпт не кэшируется в vLLM | он короче блока кэша | для гибридных моделей — промпт длиннее 576 токенов |
| Ответ через nginx приходит одним куском | прокси буферизует | proxy_buffering off |
Что выбрать
| vLLM 0.34 | SGLang 0.5.23 | |
|---|---|---|
| Кто делает | PyTorch Foundation, Inferact | LMSYS, RadixArk |
| Лицензия | Apache 2.0 | Apache 2.0 |
| Модели и железо | самый широкий выбор | немного уже |
| Запуск на стенде | 155 секунд | 85–100 секунд |
| Отказ при нехватке памяти | через 2–4 минуты | через 20–30 секунд |
| Память | сам измеряет и распределяет | долю задаёте вы |
| Файл настроек | всё, включая модель | всё, кроме модели |
| API | OpenAI, Anthropic | OpenAI, Anthropic, Ollama, свой |
| Кэш префиксов | блоками | деревом, точнее на коротких совпадениях |
| Состояние на сервере | нет | сессии в собственном API |
| Открыто без ключа | проверки, метрики, документация, /invocations | проверки и метрики |
| Метрики | включены всегда | включаются флагом |
| Готовый дашборд | работает | нужна правка имён метрик |
| Трассировка | одна запись на запрос | дерево шагов |
| Телеметрия разработчикам | есть, отключается | нет |
| Маршрутизатор | отдельный пакет | в образе; проектов три |
| Скорость, один запрос | одинаковая | одинаковая |
| Скорость, 64 запроса | 2415 токенов/с | 1518 токенов/с после настройки |
- vLLM — выбор по умолчанию: чаще работает без настройки, больше моделей и железа, вся обвязка поддерживает его первым.
- SGLang — для агентов и длинных диалогов с общими началами, для сессий на сервере и разделения фаз на большом кластере. Требует настройки памяти.
- Оба стоит замерить, если сервис большой. Клиентский код от выбора не зависит; меняются команда запуска, файл настроек и дашборд.
- Ни один, если пользователь один: проще llama.cpp. При малой или неровной нагрузке дешевле облачный API.