Невронните мрежи с прости думи
Здравейте!
В интернет могат да се намерят различни обяснения как работят невронните мрежи, но тези, които са ми попадали, бяха или прекалено специфични и насочени към специалисти, или прекалено опростени.
Опитах се да напиша свои обяснения, които да не са прекалено опростени, но при това да остават по възможност разбираеми.
Статията е на 10 процента компилирана от други статии, на 30 процента – от множество диалози с различни LLM, и на 60 процента „написана на ръка“ въз основа на статии и отговори.
Входни данни
На входа невронната мрежа получава входни данни във вид на заявка на потребителя. Към заявката на потребителя се добавя и обща информация, която позволява да се получи по-точен отговор. Ако невронната мрежа поддържа RAG (Retrieval-Augmented Generation), към заявката се добавят също:
-
Данни от векторната база, ако в нея предварително е добавено онова, което е нужно за генериране на по-актуален отговор
-
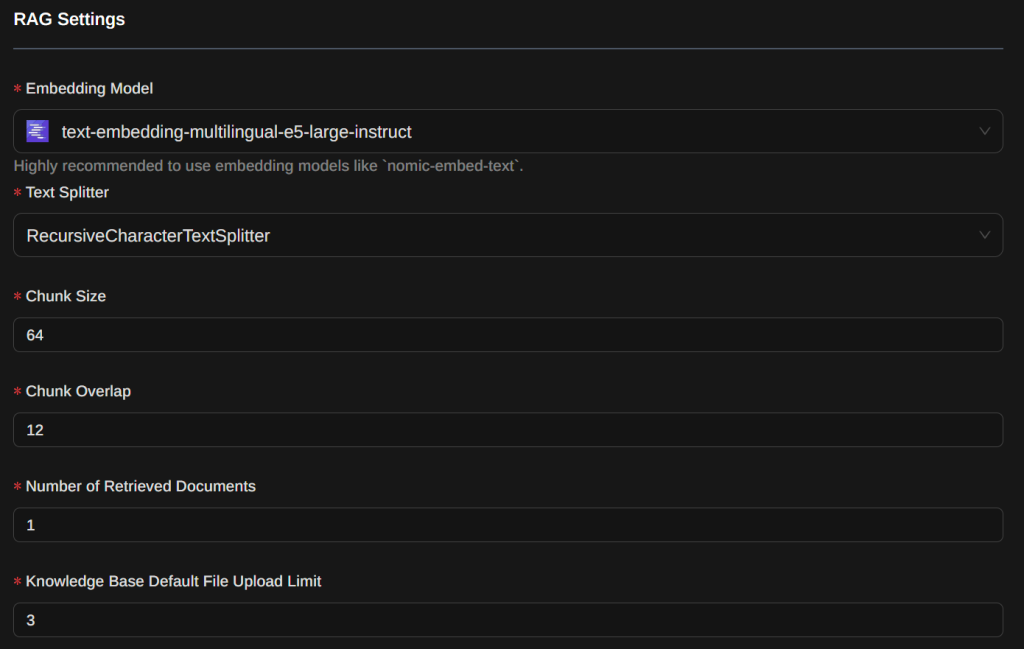
Данни, извлечени от интернет страница или документ – за да се намали размерът им, често се използва специализирана embedding невронна мрежа: тя намира всички подходящи късове текст и ги добавя към контекста на заявката
Пример за настройки на embedding невронна мрежа за Chrome разширението Page Assist
Как работи RAG
Системата се състои от два основни компонента
Retrieval (извличане):
Търси релевантна информация във външна база знания (най-често – векторна база, например FAISS, Qdrant, Weaviate). Тази база обикновено е построена предварително от текстови документи (pdf, markdown, html и др.), преобразувани в ембединги с помощта на модел (например BERT, Instructor или SentenceTransformer).
Generation (генериране):
LLM (GPT, LLaMA, Mistral и др.) получава изходната заявка + намерените документи и генерира крайния отговор.
Не бъркайте двата различни „embedding“ в тази статия: тук става дума за отделен embedding модел, който превръща цял фрагмент от текст в един вектор, за да се търсят сходни фрагменти; по-нататък, в стъпка 2, – за token embedding, векторите на отделните токени вътре в самия LLM. Механиката е сходна, но това са различни модели и различни вектори.
За RAG и function calling имам отделна статия:
И отделна – за векторните бази:
В някои невронни мрежи за отделяне на заявката на потребителя, контекста, получен с помощта на RAG, и общото съобщение се използва маркиране.
Пример:
context:
това са данни, получени от интернет с помощта на embedding невронна мрежа или от векторно хранилище и подредени по съвпадение на score в низходящ ред
{ "context": [ "Пеницилинът е първият открит антибиотик, произведен от плесенна гъба от рода Penicillium. Използва се за лечение на бактериални инфекции като ангина, сифилис и пневмония. Пеницилинът разрушава клетъчната стена на бактериите, което води до тяхната гибел.", "Някои хора имат алергия към пеницилин. Това може да предизвика сериозни реакции, включително анафилаксия, затова преди предписването на препарата е важно да се уточни дали пациентът има алергия." ], "instructions": "Отговори с прости думи, като използваш само информацията от контекста. Ако отговор няма – напиши 'Информацията не е намерена'.", "question": "Какво е пеницилин и за какво се прилага?"}От какво се състои моделът
Трансформър (Transformer)
Архитектура на невронна мрежа, която е станала основа на съвременните езикови модели като ChatGPT, BERT, LLaMA, Gemma и много други.
Тя е описана за първи път в научна статия от 2017 г. със заглавие „Attention is All You Need“.
Казано по-просто, трансформърът е „умна машина“, която умее да чете и разбира текст, като обработва всички думи едновременно, а не по една, както са правили предишните модели (например RNN, LSTM).
Слоеве на трансформъра (Transformer Layers)
това са повтарящи се блокове, през които минава всеки токен вътре в модела.
Един слой (или „трансформър блок“) включва:
Self-Attention:
токенът „гледа“ към другите токени и решава кои са важни.
Feed-Forward Network:
уточняване и преобразуване на всеки токен.
Layer Normalization или LayerNorm:
стабилизиране на изчисленията.
Residual Connections:
за да не „забрави“ моделът началната информация.
LayerNorm може да е преди или след Residual (Pre-LN vs Post-LN). Почти всички съвременни LLM (Llama, Qwen, Gemma, DeepSeek) използват Pre-LN, а вместо класическия LayerNorm – неговия опростен вариант RMSNorm. Стъпките по-нататък в статията са описани по класическата схема Post-LN, така е по-нагледно.
и други етапи.
Всеки слой на трансформъра (Transformer Block) е отделен набор от параметри, които:
се обучават независимо,
се прилагат независимо към входните данни,
дават все по-„дълбоко“ разбиране на смисъла и контекста.
Какво означава „32 слоя“:
всеки токен минава през 32 такива операции, последователно една след друга; след всеки слой токенът става все по-информиран, т.е. представянето му (векторът) отразява все по-дълбоко контекста
Брой слоеве на популярните отворени модели (transformer layers, по официалните конфигурации, средата на 2026 г.):
| Модел | Брой слоеве ||---------------------------|------------------|| Llama 3.1 (8B) | 32 || Llama 3.1 (70B) | 80 || Llama 4 Scout (109B) | 48 || Gemma 3 (12B) | 48 || Gemma 3 (27B) | 62 || Gemma 4 (31B) | 60 || Qwen 3 (8B) | 36 || Qwen 3 (32B) | 64 || Qwen 3 (235B-A22B) | 94 || Qwen 3.5 (9B) | 32 || DeepSeek V3 / R1 / V4 Pro | 61 || DeepSeek V4 Flash | 43 || GPT-OSS (20B) | 24 || GPT-OSS (120B) | 36 |При MoE-моделите (Mixture of Experts – Llama 4, Qwen 3 235B-A22B, DeepSeek V3/V4, GPT-OSS) във всеки слой вместо един FFN блок има набор от „експерти“, от които за всеки токен се активира само малка част: при Qwen 3 235B-A22B от 235 милиарда параметъра за всеки токен работят само 22 милиарда.
Активация (Activation)
това са междинните изходи на невронната мрежа след прилагането на функции и слоеве.
Може да се каже, че активациите са данни, които „живеят вътре в мрежата“ на всеки етап от преминаването на входа през модела.
Тензор (Tensor)
в невронната мрежа е многомерен масив от числа, с който работят слоевете на модела.
Входни данни:
Текст → токени → ембединги → тензор batch_size × seq_len × embedding_dim.
Тегла на модела:
Матриците с тегла в слоевете също са тензори.
Междинни представяния (активации):
Изходът на всеки слой (например LayerNorm, Attention) е тензор.
Градиенти:
При обучението моделът изчислява градиенти (тензори) за обновяване на теглата.
Стъпки в работата на невронната мрежа
Стъпка 1: Токенизация (от текст / изображение към токени)
Токенизация на текст
LLM не работи директно с думи – работи с токени (части от думи или символи), превърнати в числа.
Пример:
Текст на потребителя:"Здравей, свят"
ID на токена в речника на модела за думата:"Здравей" = 1123"," = 15"свят" = 345
Получаваме масив от ID на токени:["Здравей", ",", "свят"] = [1123, 15, 345]
Как се постига това:
Използва се алгоритъм като Byte Pair Encoding (BPE), Unigram, WordPiece или SentencePiece.
BPE токенизаторът намира най-честите двойки символи.
WordPiece строи токени въз основа на вероятността на йерархични разбивания.
Често токените не са отделни думи, а части от думи.
В речника има специални маркери за границите на думите: в BPE речниците интервалът се кодира в началото на токена, а в WordPiece с маркера „##“ се означават токените-продължения на думата. Затова нито един субтокен не пресича границата между две думи.
Самият разбор на низа зависи от алгоритъма: WordPiece върви „алчно“ – взема възможно най-дългия токен, който съвпада с началото на оставащия низ, BPE последователно прилага научените правила за сливане на двойки, а Unigram избира най-вероятното разбиване изцяло.
Пример:
Текст на потребителя:"невероятно"
ID на токена в речника на модела за части от думи:"не" = 24"вероят" = 126"но" = 36Получаваме масив от ID на токени:["не", "вероят", "но"] = [24, 126, 36]
В WordPiece речник същата дума би могла да се раздели като:("не", "##вероятно")където "##" означава продължение на думата
Различни по смисъл думи могат да имат общи токени, например „приказка“ и „пример“ могат да имат общ токен „при“:
Макар че „при“ се повтаря и в двете думи, моделът не гледа само този къс, а и съседните токени, и цялата фраза (за това – по-нататък в статията).
Първо „при“ се превръща във вектор – просто набор от числа, които описват тази част от думата.
След това трансформърът (многослойна мрежа) смесва този вектор с векторите на съседните токени („казка“ или „мер“) и добавя информация за позицията в изречението.
В резултат още в първия слой „при“ в „приказка“ вече се различава от „при“ в „пример“, защото там е „примесен“ различен контекст.
Тоест общото късче „при“ само по себе си е неутрално, а смисълът се оформя по-нататък през слоевете въз основа на обкръжението.
Защо токени, а не думи:
По-малък речник = икономия на памет.
По-добре се обработват редките и съставните думи.
Позволява на модела да „се учи“ да разбира структурата на думите.
Размерът на речника, или „vocab_size“, определя колко уникални токена може да обработва моделът.
По-голям речник = по-малко разбивания на думи на части, но по-голям обем на embedding слоя.
Думата „програмиране“ може да бъде изцяло един токен в модел с голям речник,
а може да се раздели на части („пр“, „ограм“, „иране“) в модел с по-малък речник.
Практичен нюанс за читателите на този блог: кирилицата се токенизира „по-скъпо“ от латиницата. Токенизаторите са обучени основно върху английски, затова българската, руската или украинската дума по-често се разбива на по-голям брой токени, отколкото английската със същата дължина. Един и същ текст на български заема значително повече токени: контекстът свършва по-бързо, а в платените API това буквално е по-скъпо.
Размери на речника на популярните отворени модели (по официалните конфигурации, средата на 2026 г.):
Модел | Размер на речника |--------------------------|----------------|Llama 2 (2023) | 32 000 |Llama 3.1 | 128 256 |Llama 4 | 202 048 |Gemma 2 | 256 128 |Gemma 3 / Gemma 4 | 262 144 |Qwen 3 | 151 936 |Qwen 3.5 | 248 320 |DeepSeek V3 / R1 / V4 | 129 280 |GPT-OSS (20B / 120B) | 201 088 |Добре се вижда как речникът расте от поколение на поколение. При затворените модели (GPT, Claude, Gemini) речникът и останалите детайли на архитектурата не се публикуват.
Специални токени и chat-шаблон
Освен токените на обикновения текст в речника има служебни токени: начало и край на последователността, граници на репликите, при новите модели – маркери за извикване на инструменти и блокове с разсъждения. Моделът ги е виждал при дообучаването и се опира на тях, за да разбира къде чия реплика е и кога е време да спре.
Затова диалогът преди токенизацията се обвива в chat-шаблон – възприетата за конкретния модел маркировка с роли „система“, „потребител“ и „асистент“. Опростено изглежда така:
<|system|>Ти си полезен асистент.<|end|><|user|>Какво е пеницилин?<|end|><|assistant|>Моделът просто продължава текста след маркера на асистента, а завършва генерирането със свой служебен токен за край на репликата.
Всяко семейство модели има свой шаблон и объркването му е най-честият начин да „счупите“ локално стартиране: моделът започва да отговаря вместо потребителя, не спира навреме или сипе служебни токени направо в текста. Готовите бекенди като llama.cpp и Ollama обикновено вземат правилния шаблон автоматично от метаданните на GGUF файла.
Токенизация на изображения
За разлика от текстовата токенизация (където токените са думи, субдуми, символи), при изображенията токените са фрагменти от изображението или представяния на признаци. По-долу са разгледани основните подходи.
За изображенията вместо токени се получава веднага матрица (или тензор) от пиксели.
В класическите конволюционни мрежи (CNN) малки участъци от картинката (например 3×3 или 5×5 пиксела) се плъзгат по изображението и за всеки участък конволюцията с набор от филтри дава вектор от признаци. Тези вектори се събират в карти на признаците и се предават нататък.
В съвременните трансформъри за изображения (Vision Transformer) картинката се разбива на „патчове“ (квадрати, да речем, 16×16 пиксела), всеки патч се изравнява във вектор и също се проектира през матрица на ембедингите във вектор-представяне, както токен в NLP.
Основни начини за токенизация на изображения:
Patch Embedding (разбиване на патчове) – класическият подход на ViT:
Изображението се разделя на мрежа от квадратни патчове, например 16×16 пиксела.
Всеки патч се разгъва във вектор (flatten), после линейно се проектира в ембединг с фиксирана размерност (например 768).
В резултат се получава последователност от токени: един токен на патч.
Пример:
224×224 RGB изображение с патчове 16×16 → 14×14 = 196 токена + [CLS] токен.
Всеки токен: вектор с размер 768.
CNN Feature Maps като токени:
Използват се конволюционни мрежи (ResNet, ConvNext) за извличане на признаци.
Пространствените признаци (feature map) на изхода могат да се интерпретират като токени, където всеки елемент на мрежата е вектор.
Прилага се във ResNet-вариантите на CLIP и други хибридни модели; непрекъснатите признаци на визуалния енкодер използват и мултимодални LLM като LLaVA.
VQ-VAE / VQ-GAN токенизация (дискретна):
Кодиращият модул (енкодерът) преобразува изображението в карта на признаците и след това я квантува в дискретни токени (индекси от речник).
Всеки токен е индекс в речник от визуални патчове.
Използва се в първата версия на DALL·E, Parti, Chameleon и други генеративни модели.
Плюсове: моделът работи с „думи“ на визуалния език.
Минуси: загуба на точност, нестабилна генерация.
Segment/Region-based токени (DETR, Region Attention):
Изображението се разбива на смислови региони (сегментация, обекти).
Всеки регион се преобразува в токен чрез агрегиране на признаци.
Използва се в задачи за детекция на обекти и визуални отговори на въпроси (VQA).
Patch + Positional Encoding:
Както в NLP, към всеки патч се добавя позиционна информация (абсолютна, относителна или learnable), за да се запази пространствената структура на изображението.
Максимална дължина на контекста
Контекстът е оперативната памет на модела, а размерът на контекста е максималният брой токени (думи, символи или части от тях), които езиковият модел може да обработи за една заявка.
Това е „обемът памет“, който моделът може да вижда едновременно, за да формира отговор. Всичко, което излиза извън този прозорец, моделът забравя или не вижда директно.
Размерът на контекста влияе пряко върху способността на модела да помни предишните съобщения в диалога.
Моделът няма вградена дългосрочна памет – той не „помни“ вас като човек. Той просто обработва целия предишен диалог като входен текст (токени), който се предава при всяка заявка. Това се нарича контекст.
Максимална дължина на контекста на популярните отворени модели (по официалните конфигурации, средата на 2026 г.):
| Модел | Максимален контекст ||-------------------------|------------------------------|| Llama 3.1 | 131 072 || Llama 4 Scout | 10 000 000 || Gemma 3 | 131 072 || Gemma 4 | 262 144 || Qwen 3 | 40 960 (131 072 с YaRN) || Qwen 3.5 | 262 144 || DeepSeek V3.1 / R1 | 131 072 || DeepSeek V4 | 1 048 576 || GPT-OSS | 131 072 |При затворените модели контекстът е от същия порядък: например Gemini 2.5 Pro държи около милион токена.
Защо дългият контекст е скъп
Цената на контекста е двойна. Първо, вниманието сравнява всеки токен с всеки: при удвояване на дължината на последователността обемът на изчисленията расте приблизително четири пъти. Второ, за всеки обработен токен моделът съхранява неговите K- и V-вектори във всички слоеве (KV-кеш, за него – в стъпката за итерацията на генерирането) – при дълги контексти този кеш заема гигабайти и може да изяжда повече памет от самите тегла.
Затова около дългия контекст има толкова инженерни трикове: Gemma и GPT-OSS редуват слоеве с пълно внимание със слоеве с „плъзгащ се прозорец“, които гледат само най-близката хилядарка-две токени, а DeepSeek свива ключовете и стойностите в компактен латентен вектор (MLA). Именно такива похвати правят практически възможен контекст от стотици хиляди и милиони токени.
Стъпка 2: Token embedding (от токен към вектор)
В LLM модела за всеки ID на токен се съхранява Token Embedding, или масив от числа. Тези числа описват какво означава този токен, сякаш превеждате думата в математическа форма.
Първоначално token embedding има фиксирана стойност за всеки токен, но после се уточнява, докато минава през слоевете.
Когато Token Embedding премине през няколко слоя на трансформъра, той става контекстуализиран: отчита значението на цялата фраза. На изхода получаваме вектор, който съдържа „смисъла“ на думата в контекста.
Връзките между векторите се задават от матриците с тегла между слоевете.
Първоначално тези тегла се инициализират случайно или по специално правило (например Xavier или He), а после по време на обучението за всяко тегло се изчислява градиентът на загубата (доколко грешката расте или намалява при промяната му).
Алгоритъмът за обратно разпространение („backpropagation“) изчислява как промяната на всяко тегло ще повлияе на крайната грешка, а след това чрез градиентно спускане (или негови вариации) коригира тези тегла.
Така постепенно се усилват връзките между онези компоненти на векторите, които заедно дават полезна информация, и отслабват всички ненужни – получава се набор от взаимосвързани вектори, оптимални за решаване на задачата.
Размерност на вектора (Embedding Size, d_model) на всеки слой на трансформъра
Броят измерения на token embedding е фиксиран за целия модел и зависи от неговата архитектура.
Пример:
Текст на потребителя:"Здравей"
ID на токена в речника на модела за думата:"Здравей" = 1123
Token embedding за ID на токен 1123 = масив от стойности във формат число с плаваща запетая от d_model= 4096 елемента:[0.034, 0.120, 0.905, ..., 0.028]
Размер на embedding size на популярните отворени модели (по официалните конфигурации, средата на 2026 г.):
Модел | d_model |--------------------------|---------|Llama 3.1 (8B) | 4096 |Llama 3.1 (70B) | 8192 |Llama 4 Scout (109B) | 5120 |Gemma 3 (12B) | 3840 |Gemma 3 (27B) | 5376 |Gemma 4 (31B) | 5376 |Qwen 3 (8B) | 4096 |Qwen 3 (32B) | 5120 |Qwen 3 (235B-A22B) | 4096 |Qwen 3.5 (9B) | 4096 |DeepSeek V3 / R1 / V4 Pro | 7168 |DeepSeek V4 Flash | 4096 |GPT-OSS (20B / 120B) | 2880 |Броят елементи на вектора на смисъла влияе върху:
По-голяма размерност = повече „място“ за съхранение на семантика, синтаксис, контекст.
Това позволява да се различават по-фини смисли между токените.
Цената е в паметта: квадратично с растежа на d_model растат вътрешните матрици на проекциите (размерът им е d_model × d_model), а слоят на ембедингите и активациите растат линейно.
матрицата на проекцията при d_model = 4096заема 4 пъти повече памет, отколкотоматрицата на проекцията при d_model = 2048Числата, от които се състоят тези вектори и тегла, могат да се съхраняват с различна точност – за форматите на числата и квантуването вж. раздела в края на статията.
Стъпка 3: Positional Encoding / Embeddings
Без допълнителна информация фразите:
„Котката яде рибата“
„Рибата яде котката“
биха могли да се възприемат еднакво, тъй като наборът от думи е един и същ.
За да се даде на модела усещане за ред, към всеки токен (дума или част от дума) се добавя позиционен вектор – набор от числа, който съобщава на модела на кои позиции се намират думите.
Token embedding + Positional Encoding / Embeddings = Сумарен векторТака са правели класическите трансформъри и по тази схема е най-нагледно да се обяснява. При съвременните модели позицията се внася иначе – вътре в механизма на вниманието, чрез завъртане на векторите (RoPE, за него – по-долу в тази стъпка); сумарният вектор при тях просто е равен на ембединга на токена.
Positional Encoding / Embedding е:
Вектор със същата размерност като на токена (d)
Представя позицията в последователността
Може да се зададе с формула (sin/cos) или да се обучава
Обединява се с вектора на токена на входа на модела
Какъв тип се използва в моделите:
| Метод | Модел/семейство | Описание ||-----------------------------|-----------------------------|-----------------------------------------------|| Sinusoidal Encoding | Transformer | Не се обучават, основани на синуси и || | (Vaswani et al., 2017) | косинуси с различна честота ||-----------------------------|-----------------------------|-----------------------------------------------|| Learnable Embeddings | BERT, GPT-2/GPT-3, | Обучаема таблица с позиции, подобна на || | OPT, ELECTRA | ембедингите на думите ||-----------------------------|-----------------------------|-----------------------------------------------|| Rotary Positional Embedding | почти всички съвременни LLM:| Завъртане на векторите – запазва относителните|| (RoPE) | Llama 2/3/4, Qwen, Gemma, | позиции между токените || | Mistral, DeepSeek, GPT-OSS | ||-----------------------------|-----------------------------|-----------------------------------------------|| ALiBi | BLOOM, MPT | Линеен bias, добавя се към attention score, || | | не изисква съхранение на позиции ||-----------------------------|-----------------------------|-----------------------------------------------|| Relative Position Bias | T5, DeBERTa, Transformer-XL,| Използва отмествания между токените вместо || | Pegasus, LongT5 | абсолютни позиции |Пример:
Текст на потребителя:"Здравей, свят"
ID на токена в речника на модела за думата:"Здравей" = 1123"," = 15"свят" = 345Получаваме масив от ID на токени:["Здравей", ",", "свят"] = [1123, 15, 345]
Token embedding от базата на модела за:ID на токен 1123 = [0.034, 0.120, 0.905, ..., 0.028]ID на токен 15 = [0.022, -0.010, -0.313, ..., 0.117]ID на токен 345 = [-0.102, 0.241, 0.543, ..., 0.055]
Позиция на ID на токена на думата в текста на потребителя:[1123, 15, 345] = [позиция 0, позиция 1, позиция 2]
Изчисляваме или вземаме от базата на модела вектора на позицията:Вектор на позиция 0 = [0.001, 0.087, -0.432, ..., 0.019]Вектор на позиция 1 = [0.005, -0.013, 0.021, ..., -0.012]Вектор на позиция 2 = [-0.003, 0.099, -0.082, ..., 0.003]
Сумарен вектор за ID 1123:Token embedding [0.034, 0.120, 0.905, ..., 0.028] +Вектор на позиция 0 [0.001, 0.087, -0.432, ..., 0.019] =[0.035, 0.207, 0.473, ..., 0.047]аналогично за останалите токени
Изчисляване на Sinusoidal Position Encoding
Синусоидалното позиционно кодиране се използва в Transformer-моделите, за да се предостави информация за позицията на токените във входната последователност. За разлика от рекурентните мрежи, Transformer няма вграден механизъм за отчитане на реда на токените. Затова е необходимо информацията за позицията на всеки токен да се кодира изрично.
От гледна точка на математиката:
pos - позиция на токена в последователността (започвайки от 0)i - индекс на измерението на вектора на позиционното кодиране (започвайки от 0)d_model - размерност на вектора на позиционното кодиране (размерност на ембединга)PE(pos, i) - i-ият елемент на вектора на позиционното кодиране за позиция pos.10000 - това е хиперпараметър. Използва се за мащабиране на позицията и на честотата на синусоидите. Изборът на тази стойност позволява на модела лесно да екстраполира към последователности, по-дълги от тези, върху които е обучен.
Тогава i-ият елемент на вектора на позиционното кодиране за позиция pos:PE(pos, 2i) = sin(pos / 10000^(2i/d_model))PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
Формулата използва различни честоти (дължини на вълните) на синусоидалните функции за различните измерения на вектора на позиционното кодиране.
Четните измерения използват синус, а нечетните – косинус. Това позволява на модела да различава позициите по различни фази и амплитуди.
Делението на pos на 10000^(2i/d_model) намалява честотата на синусоидата с нарастването на индекса на измерението i.
Това създава по-бавни колебания за по-високите измерения, което позволява на модела да различава позициите в различни мащаби.
Пример:
pos = 0 (първи токен)d_model = 4 (размерност на вектора на позиционното кодиране)
Тогава векторът на позиционното кодиране PE(0) ще има размерност 4.Ще изчислим всеки елемент:
i = 0:PE(0, 0) = sin(0 / 10000^(2*0/4)) = sin(0) = 0PE(0, 1) = cos(0 / 10000^(2*0/4)) = cos(0) = 1
i = 1:PE(0, 2) = sin(0 / 10000^(2*1/4)) = sin(0) = 0PE(0, 3) = cos(0 / 10000^(2*1/4)) = cos(0) = 1
PE(0) = [0, 1, 0, 1]
Сега ще изчислим вектора на позиционното кодиране за pos = 1:
i = 0:PE(1, 0) = sin(1 / 10000^(2*0/4)) = sin(1) ≈ 0.8415PE(1, 1) = cos(1 / 10000^(2*0/4)) = cos(1) ≈ 0.5403
i = 1:PE(1, 2) = sin(1 / 10000^(2*1/4)) = sin(0.01) ≈ 0.01PE(1, 3) = cos(1 / 10000^(2*1/4)) = cos(0.01) ≈ 1
PE(1) = [0.8415, 0.5403, 0.01, 1]
Важно:
В реалните Transformer-модели позиционното кодиране обикновено се изчислява предварително за всички възможни позиции в последователността и се запазва като таблица.
След това, при подаване на входната последователност, съответните вектори на позиционното кодиране се добавят към ембедингите на токените.
Изборът на хиперпараметъра 10000 е емпиричен и може да се настройва според конкретната задача.
Относителни позиционни отмествания:
Вместо да се кодира абсолютната позиция на всеки токен, някои варианти на трансформъри въвеждат относителни позиционни отмествания. Това позволява на модела директно да отчита разстоянието (и посоката) между двойки токени, а не тяхната „глобална“ позиция в последователността.
Защо са нужни относителните отмествания:
При генериране или обработка на дълги текстове е важно колко далеч една от друга се намират думите, а не само техните абсолютни индекси.
Абсолютните ембединги се обобщават зле към последователности, по-дълги от тези, върху които моделът е обучаван.
Относителните отмествания дават по-голяма гъвкавост: моделът се учи например, че „на 3 позиции надясно може да има обект на действието“, независимо къде в текста стои изречението.
Transformer-XL, относителни позиции чрез отместване на ключовете и заявките:
В класическия self-attention изчисляваме:score_{i,j} = (Q_i · K_j) / sqrt(d_k)
В Transformer-XL се въвеждат два допълнителни набора ембединги:E^R[r] – ембединг за относителното отместване r = j - iU, V – два вектора на отместване
Крайна формула:
Q_i·E^R[j-i] - зависима от съдържанието част на вниманието, отчитаща относителното отместванеV·E^R[j-i] - независима от съдържанието част, задаваща базовия bias за дадено отместване
score_{i,j} = (1/√d_k) * (Q_i·K_j + Q_i·E^R[j-i] + U·K_j + V·E^R[j-i])
Как работи RoPE
Практически всички съвременни LLM използват Rotary Positional Embedding (RoPE). Идеята: вместо да се прибавя вектор на позицията към ембединга на входа, координатите на векторите Q и K се разбиват на двойки и всяка двойка се завърта на ъгъл, пропорционален на позицията на токена. Всяка двойка има своя „честота“ на въртене – от бърза към бавна, приблизително като честотите на синусоидите по-горе.
Какво дава това:
Позицията се внася вътре във всеки слой на вниманието, а не веднъж на входа.
Скаларното произведение на два завъртени вектора зависи само от разликата в техните позиции – моделът автоматично получава относителни позиции, без отделни таблици с отмествания.
Векторите V и самите ембединги не се променят: позицията влияе точно там, където се сравняват токените.
С RoPE са свързани и техниките за разтягане на контекста. Ако моделът е обучен на 40 хиляди токена, а трябват 130 – честотите на въртене се преизчисляват така, че по-далечните позиции да „се поберат“ в обичайния за модела диапазон от ъгли. Така работят NTK-мащабирането и YaRN: същото онова „131 072 с YaRN“ от таблицата с контекстите не е отделно обучение върху дълъг контекст, а математическо разтягане на RoPE с леко дообучаване.
Стъпка 4: Attention, Self-Attention (вектор на вниманието, Q,K,V-проекции) и разбиване на глави на вниманието (Multi-Head Attention)
Сега, когато токените имат не само „значение“, но и „позиция“, те минават през механизма self-attention, благодарение на който всяка дума гледа към другите думи, за да реши на кого от тях да обърне внимание, за да разбере по-добре собствения си смисъл.
Това прилича на начина, по който човек чете изречение: той може да върне погледа си към предишните думи, за да разбере правилно контекста.
Self-Attention отговаря за разбирането на контекста – кои токени са важни един за друг, и позволява на всеки токен да гледа претеглено към всички останали в последователността и да определя към какво да обърне внимание при изграждането на смисъла.
Softmax
това е функция, която приема на входа вектор от числа и го превръща в разпределение на вероятностите, в което всички стойности са неотрицателни и сборът им е 1.
softmax(zᵢ) = exp(zᵢ) / ∑ⱼ exp(zⱼ)
Моделът създава три представяния за всеки токен:
Q (въпрос): какво търся?
K (ключ): какво мога да предложа?
V (стойност): каква информация нося?
Всяка дума сравнява своя Q с K на всички останали думи, за да разбере към кого си струва да гледа. След това събира нужната информация от V на онези думи, които са се оказали важни.
За изчисляване на представянията се използва матрица с тегла на слоя – това е обучаем параметър на невронната мрежа, тоест тя се инициализира случайно при създаването на модела и се обучава заедно с останалите тегла. Първоначално е случайна, после става „умна“ благодарение на обучението.
Как се обучават:
На етапа на обратното разпространение (backpropagation) моделът сравнява своите предсказания с правилния отговор (например следващия токен) и обновява Wq, Wk, Wv по градиента на грешката с помощта на оптимизатор (например Adam).
Параметрите Wq, Wk и Wv могат да са общи или различни за всяка от главите, в зависимост от модела.
Wq (Query Projection):
Създава „въпроса“ – какво токенът иска да намери в другите токени.
Определя посоката на вниманието.
Q токена = Сумарен вектор на токена X * Тегло на слоя WqWk (Key Projection):
Създава „ключа“ – какво всеки токен предлага на другите.
Използва се за сравнение с Q (доколко Qᵢ е „подобен“ на Kⱼ).
K токена = Сумарен вектор на токена X * Тегло на слоя WkWv (Value Projection):
Създава „информацията“, която токенът може да предаде, ако към него е обърнато внимание.
V токена = Сумарен вектор на токена X * Тегло на слоя Wv
Глава на вниманието (attention-head):
При моделите съществува и глава на вниманието (attention-head). Всяка глава на вниманието (attention-head) обработва входния вектор по свой начин, през свои Q, K, V проекции, и гледа различни аспекти на изречението.
Всяка attention-head има своя гледна точка:
една глава може да следи граматиката (например подлог и сказуемо),
друга – смисловите връзки (например кой върху какво действа),
трета – позициите, контекста и т.н.
Вместо една „гледна точка“ – веднага няколко.
Всяка глава вижда целия текст, но го анализира по свой начин, през проекция и внимание.
Пример:
В изречението
„Момчето, което държеше топката, избяга.“
Различните глави могат да виждат
Глава 1: „момчето“ ↔ „избяга“ → кой извършва действието
Глава 2: „което“ ↔ „държеше“ → вградена граматична връзка
Глава 3: „топката“ ↔ „държеше“ → обект на действието
Всяка глава дава свое представяне за всеки токен, като отчита своите „наблюдения“.
Архитектура Multi-Head Attention (MHA):
Класическата реализация на self-attention, както в оригиналната статия „Attention is All You Need“.
Какво се случва:
Има няколко глави
Всяка глава има свои Wq, Wk, Wv
Всяка глава анализира по свой начин целия контекст
Резултатите от всички глави се обединяват и минават през обща Wo
Плюсове:
Гъвкавост: всяка глава „гледа“ входа по свой начин
Отлично работи при големи изчислителни ресурси
Минуси:
Много скъпо по памет и скорост при голям брой глави
Особено при дълги последователности
Архитектура Multi-Query Attention (MQA):
Оптимизирана версия на вниманието, използвана в PaLM, Falcon, StarCoder и други, за да се намали натоварването на паметта и да се ускори инференсът.
Какво се случва:
По една Wq на глава
Само един Wk и един Wv
Всички глави използват едни и същи ключове и стойности
Плюсове:
По-малко памет: K и V се съхраняват в един екземпляр
По-бърза генерация: по-малко данни се съхраняват между стъпките
Минуси:
По-малка гъвкавост (всички глави „гледат“ едни и същи K и V)
Може леко да влоши качеството при сложни задачи
Архитектура Grouped Query Attention (GQA):
комбиниран подход от предните два. Именно GQA се използва в повечето съвременни модели: Llama 3/4, Qwen 3, Gemma 2/3/4, GPT-OSS.
Пример:
Например, в архитектурата на невронната мрежа Gemma 3 се използва Grouped Query Attention (GQA) – компромис между стандартния Multi-Head Attention (MHA) и Multi-Query Attention (MQA). В тази схема матриците Wq (за заявките) са различни за всяка глава, докато матриците Wk (за ключовете) и Wv (за стойностите) могат да са общи за групи от глави.
В тази невронна мрежа:
Wq: всяка глава има своя уникална матрица Wq, което позволява на всяка глава да се фокусира върху различни аспекти на входната последователност.
Wk и Wv: главите се делят на групи и вътре във всяка група се използва обща матрица Wk и Wv. Това намалява обема на изчисленията и паметта, нужни за съхранение на ключовете и стойностите.
В Gemma 3 27B – 32 глави за заявки (Wq) и 16 KV-глави: главите се делят на 16 групи по 2 и всяка група използва общи матрици на ключовете и стойностите (Wk и Wv).
В крайна сметка във всеки от 62 слоя на модела Gemma 3 с размер 27B ще има:
32 различни Wq (Query Projection)
16 различни Wk (Key Projection)
16 различни Wv (Value Projection)
1 обща Wo (Output Projection)
1 MLP със свои тегла (Feed-Forward Network)
свои параметри на нормализацията
– и при всеки от 62-те слоя този набор от тегла е свой.
Брой глави на вниманието (attention heads; заявки Q / KV-глави) на популярните отворени модели:
| Модел | Q-глави / KV-глави ||-------------------------|------------------------|| Llama 3.1 (8B) | 32 / 8 || Llama 3.1 (70B) | 64 / 8 || Llama 4 Scout | 40 / 8 || Gemma 3 (12B) | 16 / 8 || Gemma 3 (27B) | 32 / 16 || Gemma 4 (31B) | 32 / 16 || Qwen 3 (8B) | 32 / 8 || Qwen 3 (32B) | 64 / 8 || Qwen 3 (235B-A22B) | 64 / 4 || Qwen 3.5 (9B) | 16 / 4 || DeepSeek V3 / R1 / V4 | 128 (MLA) || GPT-OSS (20B / 120B) | 64 / 8 |При DeepSeek вместо класическия GQA се използва MLA (Multi-Head Latent Attention): ключовете и стойностите се свиват в общ латентен вектор, затова разделянето на KV-глави при него е неприложимо.
Каузално маскиране (Causal Masking):
прилага се в някои модели. Когато езиковият модел (LLM) генерира текст, той трябва да предсказва следващата дума въз основа само на предишните думи.
Това означава, че токенът не трябва да има достъп до токените, които идват след него.
За да се осигури това ограничение, се използва каузално маскиране – механизъм, който „забранява“ на вниманието да вижда бъдещите токени.
Как работи:
В обикновения self-attention всеки токен „гледа“ към всички токени в последователността, включително и към бъдещите.
При генериране това е недопустимо, защото би било „мамене“ – моделът вижда отговора предварително.
За да се предотврати това, при изчисляването на attention се прилага маска – специална матрица, наречена attention mask.
За последователност с дължина n се създава триъгълна маска, в която:
Стойностите над диагонала се заменят с -∞ или с голямо отрицателно число.
След това се прилага softmax и тези стойности се превръщат в нулево внимание.
Пример за маска (за n = 4 токена):[ [0, -∞, -∞, -∞], [0,  0, -∞, -∞], [0,  0,  0, -∞], [0,  0,  0,  0]]
Това означава:Токен 0 вижда само себе си.Токен 1 вижда себе си и токен 0.Токен 2 вижда себе си, токен 1 и токен 0.Токен 3 вижда всичко, което е преди него.
Къде се използва Causal Masking:
GPT, LLaMA, Mistral, Gemma и други генеративни модели задължително използват каузално маскиране.
BERT, обратно, използва bidirectional attention – токенът може да вижда целия контекст (вкл. бъдещето), защото задачата е друга – не генерация, а разбиране.
Защо това е важно, без causal masking:
Моделът при обучението ще „надзърта“ към правилния отговор (следващия токен).
Това ще доведе до лоша генерация при използване на модела в inference, когато бъдещето е неизвестно.
Ролята на позицията в Self-Attention:
Без Position Encoding Self-Attention вижда само смисъла на думите, но не и техния ред. С добавено Position Encoding Self-Attention започва да отчита не само какво е написано, но и къде се намира:
„Момчето“ преди „четеше“ → вероятно е субект
„Книгата“ до „четеше“ → най-вероятно е обект
Какво в крайна сметка прави трансформърът:
Всяка дума получава информация за своята позиция
Чрез self-attention всяка дума „пита“ всички останали:
„Какво означавате за мен в този контекст?“
Моделът събира тези отговори и получава дълбоко разбиране на смисъла на цялата фраза
Повтаря това на всеки слой (обикновено 12–40 пъти), като задълбочава „разбирането“
Текст на потребителя:"Здравей, свят"
ID на токена от речника на модела:"Здравей" = 1123"," = 15"свят" = 345Получаваме масив от ID на токени:["Здравей", ",", "свят"] = [1123, 15, 345]
Token embedding от базата на модела:"Здравей" = ID 1123 = [0.034, 0.120, 0.905, ..., 0.028]"," = ID 15 = [0.022, -0.010, -0.313, ..., 0.117]"свят" = ID 345 = [-0.102, 0.241, 0.543, ..., 0.055]
Изчисляваме или вземаме от базата на модела вектора на позицията:Вектор на позицията "Здравей" = [0.001, 0.087, -0.432, ..., 0.019]Вектор на позицията "," = [0.005, -0.013, 0.021, ..., -0.012]Вектор на позицията "свят" = [-0.003, 0.099, -0.082, ..., 0.003]
За "Здравей":Token embedding [0.034, 0.120, 0.905, ..., 0.028] +Вектор на позицията [0.001, 0.087, -0.432, ..., 0.019] =Сумарен вектор X [0.035, 0.207, 0.473, ..., 0.047]
Изчисляваме Q, K, V за всеки токен и за всяка глава на вниманието:Q = X * Wq на главатаK  = X * Wk на главатаV = X * Wv на главатакъдето X е сумарният вектор за токенаWq, Wk, Wv - общи и еднакви за всички токени в този слой,но различни или частично различни за всяка глава
Например:Wq на главата = [[0.1, 0.2, 0.3], [0.4, 0.5, 0.6], [0.7, 0.8, 0.9], [1.0, 1.1, 1.2]]Wk на главата = [[0.12, 0.22, 0.32], [0.42, 0.52, 0.62], [0.72, 0.82, 0.92], [1.02, 1.12, 1.22]]Wv на главата = [[0.11, 0.21, 0.31], [0.41, 0.51, 0.61], [0.71, 0.81, 0.91], [1.01, 1.11, 1.21]]
Тогава:
Q "Здравей" = x * Wq = [0.035, 0.207, 0.473, 0.047] * Wq
Q[0] = 0.035 * 0.1 + 0.207 * 0.4 + 0.473 * 0.7 + 0.047 * 1.0     ≈ 0.0035 + 0.0828 + 0.3311 + 0.047     ≈ 0.4644
Q[1] = 0.035*0.2 + 0.207*0.5 + 0.473*0.8 + 0.047*1.1     = 0.007 + 0.1035 + 0.3784 + 0.0517     ≈ 0.5406
Q[2] = 0.035*0.3 + 0.207*0.6 + 0.473*0.9 + 0.047*1.2     = 0.0105 + 0.1242 + 0.4257 + 0.0564     ≈ 0.6168
Q = [0.4644, 0.5406, 0.6168]
по аналогичен начин изчисляваме за "Здравей":K = [0.47964, 0.55684, 0.63204]V = [0.47299, 0.54822, 0.62442]и за другите токени
Изчисляване на Attention Score между токените:
На този етап получихме Q, K и V за един токен и една глава на вниманието. След това можем да преминем към изчисляване на attention score между токените, например между „Здравей“ и „свят“, по формулата:
От гледна точка на математиката:
Q - матрица на заявките (Queries)K - матрица на ключовете (Keys)V - матрица на стойностите (Values)d_k - размерност на вектора
Attention(Q, K, V) = softmax((Q * Kᵀ) / √d_k + mask) * V
Q * Kᵀ - матрично умножение на Q по транспонираната матрица K.Това изчислява „суровите“ тегла на вниманието между всяка заявка и всеки ключ.
√d_k - корен квадратен от размерността на вектора на ключа (dimension of key vectors).Използва се за мащабиране, за да се предотвратят твърде големи стойностив softmax, което може да доведе до проблеми с градиентите.Това се нарича Scaled Dot-Product Attention.
mask - това е матрица, която се използва за ограничаване на вниманието.При генеративните модели се прилага causal mask (каузално маскиране) –тя не позволява на токена да „вижда напред“ при изчисляване на вниманието.Това е критично за задачи, при които моделът предсказва следващия токен.
softmax(...) - функцията softmax се прилага към резултата от деленето на Q ⋅ Kᵀна √d_k (и добавянето на mask, ако има такава). Това нормализира теглата на вниманиетотака, че да се сумират до 1 за всяка заявка.
Умножението на резултата от softmax по V дава претеглена сума от стойностите,където теглата се определят от attention score.
Пример:
Входни данни:
| Токен    | Q-вектор                 | K-вектор                 |  V-вектор              ||----------|--------------------------|--------------------------|------------------------|| "Здравей"| [0.4644, 0.5406, 0.6168] | [0.4796, 0.5568, 0.6320] |  [0.473, 0.548, 0.624] ||----------|--------------------------|--------------------------|------------------------|| ","      |[0.2, 0.3, 0.1]           | [0.25, 0.35, 0.15]       |  [0.12, 0.09, 0.04]    ||----------|--------------------------|--------------------------|------------------------|| "свят"   | [0.55, 0.33, 0.77]       | [0.5213, 0.5967, 0.6721] |  [0.55, 0.65, 0.75]    |
За простота използваме размерност d_k за Q, K = 3 (за пример)
Изчисление:
Здравей–Здравей: 0.4644*0.4796 + 0.5406*0.5568 + 0.6168*0.6320 ≈ 0.2228 + 0.3011 + 0.3899 = 0.9138Здравей–",": 0.4644*0.25 + 0.5406*0.35 + 0.6168*0.15 ≈ 0.1161 + 0.1892 + 0.0925 = 0.3978Здравей–свят: 0.4644*0.5213 + 0.5406*0.5967 + 0.6168*0.6721 ≈ 0.2422 + 0.3225 + 0.4147 = 0.9794","–Здравей: 0.2*0.4796 + 0.3*0.5568 + 0.1*0.6320 ≈ 0.0959 + 0.1670 + 0.0632 = 0.3261","–",": 0.2*0.25 + 0.3*0.35 + 0.1*0.15 = 0.05 + 0.105 + 0.015 = 0.17","–свят: 0.2*0.5213 + 0.3*0.5967 + 0.1*0.6721 ≈ 0.1043 + 0.1790 + 0.0672 = 0.3505свят–Здравей: 0.55*0.4796 + 0.33*0.5568 + 0.77*0.6320 ≈ 0.2638 + 0.1837 + 0.4876 = 0.9351свят–",": 0.55*0.25 + 0.33*0.35 + 0.77*0.15 ≈ 0.1375 + 0.1155 + 0.1155 = 0.3685свят–свят: 0.55*0.5213 + 0.33*0.5967 + 0.77*0.6721 ≈ 0.2867 + 0.1969 + 0.5185 = 1.0021
Делим на √d_k = √3 ≈ 1.732
| From \ To | Здравей                 | ","                     | свят                    || --------- | ----------------------- | ----------------------- | ----------------------- || Здравей   | 0.9138 / 1.732 ≈ 0.5275 | 0.3978 / 1.732 ≈ 0.2296 | 0.9794 / 1.732 ≈ 0.5652 || ","       | 0.3261 / 1.732 ≈ 0.1882 | 0.17 / 1.732 ≈ 0.0982   | 0.3505 / 1.732 ≈ 0.2023 || свят      | 0.9351 / 1.732 ≈ 0.5397 | 0.3685 / 1.732 ≈ 0.2127 | 1.0021 / 1.732 ≈ 0.5786 |
Прилагаме експонентата за "Здравей":exp(0.5275) ≈ 1.694exp(0.2296) ≈ 1.258exp(0.5652) ≈ 1.759
Сума на всички експоненти за "Здравей":
1.694 + 1.258 + 1.759 ≈ 4.711
softmax = exp(x) / сума на всички exp(x)
Softmax тегло за "Здравей" спрямо другите токени:
| Токен  | Softmax тегло        || ------ | -------------------- || Здравей | 1.694 / 4.711 ≈ 0.36 || ","    | 1.258 / 4.711 ≈ 0.27 || свят   | 1.759 / 4.711 ≈ 0.37 |
Когато "Здравей" генерира своето представяне (на изхода на attention слоя), той:взема 36% информация от самия себе си,27% от ",",и 37% от думата "свят".
Претеглено сумиране:
Output= 0.36 ∗ V("Здравей") + 0.27 ∗ V(",") + 0.37 ∗ V("свят")
Координата 1 = 0.36∗0.473+0.27∗0.12+0.37∗0.55≈0.1703+0.0324+0.2035 ≈ 0.4062Координата 2 = 0.36∗0.548+0.27∗0.09+0.37∗0.65≈0.1973+0.0243+0.2405 ≈ 0.4621Координата 3 = 0.36∗0.624+0.27∗0.04+0.37∗0.75≈0.2246+0.0108+0.2775 ≈ 0.5129
Изход на вниманието за токена "Здравей": [0.4062, 0.4621, 0.5129]
Този вектор – изходът на вниманието (attention output) – е новото представяне на токена „Здравей“, в което е отчетен контекстът му: и самият той, и съседите. Именно такива вектори след това отиват или в следващия attention слой, или на изхода на модела. Важно е да не се бърка с attention score: score са скаларните тегла от softmax (0.36, 0.27, 0.37 по-горе), а тук е претеглената с тях сума на V-векторите.
Обърнете внимание: за простота примерът е изчислен без каузална маска – „Здравей“ тук „вижда“ и стоящия след него токен „свят“. В истински LLM с causal masking токенът би събирал информация само от себе си и от предишните токени.
Сравняването на токена със самия себе си е нужно, защото в self-attention всеки токен „гледа“ към всички токени, включително и към себе си.
Това е необходимо, за да:
се запази информацията за самия токен – иначе той би „се загубил“ на фона на останалите.
Да се научи да „усилва“ или „потиска“ себе си – например в някои езикови ситуации токенът е важен сам по себе си (например личното местоимение), а понякога контекстът му е по-важен.
Матрицата на вниманието е квадратна (n × n) и на нейния диагонал стои именно self-to-self attention; при каузална маска от нея остава долният триъгълник.
Формално attention са теглата, по които токенът агрегира информация от другите токени (вкл. от самия себе си), и w1 е вниманието на „Здравей“ към самия себе си. Ако то не се отчита, токенът „Здравей“ изобщо не би участвал в собствения си изход.
Пример:
Той каза, че той ще дойде.
Когато моделът обработва токена „той“, му е нужно:
да „погледне“ към другите токени – за да разбере контекста,
но и самият токен „той“ също е важен, за да не се загуби информацията за това кого се има предвид.
Материали:
Wikipedia: Attention (machine learning)
Understanding Q,K,V In Transformer( Self Attention)
What is Query, Key, and Value (QKV) in the Transformer Architecture and Why Are They Used?
Стъпка 5: Обединяване на главите на вниманието (Head Concatenation, Concatenated Multi-Head Attention)
Предишните изчисления бяха за всяка от главите на вниманието, сега е необходимо да се обединят резултатите. Напомням, че резултатите са различни поради различните Wq, Wk, Wv за различните глави.
От гледна точка на математиката:
h - брой на главите на вниманиетоd_k - размерност на изхода на вниманието на всяка главаHeadOutput_i - изход на вниманието на i-тата глава.
Concatenation (Обединяване на векторите в един вектор по координати):
concat = [HeadOutput_1, HeadOutput_2, ..., HeadOutput_h]
Пример:
Входни данни:Допустим, размерност: 6 (2 глави по 3 стойности)
Брой глави на вниманието h = 2Размерност на вектора d_k = 3"Здравей" за глава 1 HeadOutput_1 = [0.4062, 0.4621, 0.5129]"Здравей" за глава 2 HeadOutput_2 = [0.22, 0.33, 0.44]
Изчисление:
Concatenation (Обединяване на векторите в един вектор по координати):
concat[0] = HeadOutput_1[0] = 0.4062concat[1] = HeadOutput_1[1] = 0.4621concat[2] = HeadOutput_1[2] = 0.5129concat[3] = HeadOutput_2[0] = 0.22concat[4] = HeadOutput_2[1] = 0.33concat[5] = HeadOutput_2[2] = 0.44
concat = [0.4062, 0.4621, 0.5129, 0.22, 0.33, 0.44]
Стъпка 6: Output Projection (Wo)
След обединяването на attention-изходите от различните глави те обикновено се пропускат през линеен слой (Dense Layer), за да се върнат в изходното пространство на размерността на модела.
От гледна точка на математиката:
concat ∈ ℝ⁶ - входен векторWₒ ∈ ℝ⁶ˣ³ - матрица на теглата на проекциятаoutput ∈ ℝ³ - изходен вектор след проекцията
Умножение:output = concat • Wₒ
Подробна формула за всеки компонент на изходния вектор:output[0] = concat[0]*W_o[0][0] + concat[1]*W_o[1][0] + concat[2]*W_o[2][0] + concat[3]*W_o[3][0] + concat[4]*W_o[4][0] + concat[5]*W_o[5][0]
Алтернативно, във вид на сума:output_j = ∑_{i=1}^{6} concat_i ⋅ W_o[i][j]     за j = 1, 2, 3
Матрично:output = concat (1x6) ⋅ W_o (6x3) = (1x3)
Пример:
Входни данни:Размерност на модела d_model = 3
Значи, проекционната матрица W_o ще имаразмерност (6, 3), т.е. 6 входа → 3 изходаW_o = [  [0.1, 0.2, 0.3],  [0.0, 0.1, 0.0],  [0.2, 0.0, 0.1],  [0.1, 0.2, 0.2],  [0.0, 0.1, 0.3],  [0.3, 0.0, 0.1]]
Входен вектор след concat:concat = [0.4062, 0.4621, 0.5129, 0.22, 0.33, 0.44]
Изчисление:
x = 0.4062*0.1 + 0.4621*0.0 + 0.5129*0.2 + 0.22*0.1 + 0.33*0.0 + 0.44*0.3  = 0.04062 + 0 + 0.10258 + 0.022 + 0 + 0.132  = 0.2972
y = 0.4062*0.2 + 0.4621*0.1 + 0.5129*0.0 + 0.22*0.2 + 0.33*0.1 + 0.44*0.0  = 0.08124 + 0.04621 + 0 + 0.044 + 0.033 + 0  = 0.2045
z = 0.4062*0.3 + 0.4621*0.0 + 0.5129*0.1 + 0.22*0.2 + 0.33*0.3 + 0.44*0.1  = 0.12186 + 0 + 0.05129 + 0.044 + 0.099 + 0.044  = 0.3602
Финален output вектор:output = [0.2972, 0.2045, 0.3602]
Стъпка 7: Добавяне на Residual (остатъчна връзка)
това е сумиране на входа на слоя с неговия изход. Събираме изхода с входния вектор, който е бил подаден на входа на блока (input embedding или изходът на предишния слой). В реален модел входът и изходът на блока имат една и съща размерност d_model и се събират поелементно; в нашия сквозен пример входът беше 4-мерен, а изходът – 3-мерен, затова за илюстрация ще вземем първите три компонента на входа.
Това се използва, за да:
се запази изходната информация (градиентите се предават назад по-лесно).
се избегне „затихването“ на сигнала през множество слоеве.
се улесни обучението дори на много дълбоки невронни мрежи.
Входни данни:
Входен векторinput = [0.035, 0.207, 0.473]
Изходен векторoutput = [0.2972, 0.2045, 0.3602]
Изчисление:
residual = output + input = residual = [0.3322, 0.4115, 0.8332]
Стъпка 8: Нормализация на слоя (Layer Normalization)
нормализира стойностите вътре в един вектор от признаци, тоест по размерността на признаците (feature dimension).
Защо е нужно:
Премахва отместването и разликите в мащаба между признаците.
Прави обучението по-стабилно.
Ускорява сходимостта на невронната мрежа.
Работи по-добре при малки партиди, за разлика от BatchNorm.
От гледна точка на математиката:
Изчисляваме средната стойност (mean):μ = (1/n) * ∑ xₙ
Изчисляваме стандартното отклонение (std):σ = sqrt((1/n) * ∑ (xₙ - μ)^2 + ε)Където ε - малко число, за да се избегне делене на нула.
Нормализираме всеки елемент:̂xₙ = (xₙ - μ) / σ
По желание мащабираме и отместваме (обучаеми параметри):yₙ = γ * ̂xₙ + β
Пример:
Входни данни:
Вземаме изхода residual от предишната стъпка:x = [0.3322, 0.4115, 0.8332]
Изчисление:
Изчисляваме средното:μ = (0.3322 + 0.4115 + 0.8332) / 3 = 1.5769 / 3 ≈ 0.5256
Изчисляваме стандартното отклонение:σ = sqrt(((0.3322 - 0.5256)^2 + (0.4115 - 0.5256)^2 + (0.8332 - 0.5256)^2) / 3)   = sqrt((0.0374 + 0.0130 + 0.0946) / 3)   = sqrt(0.0483) ≈ 0.22
Нормализираме:̂x₁ = (0.3322 - 0.5256) / 0.22 ≈ -0.88̂x₂ = (0.4115 - 0.5256) / 0.22 ≈ -0.52̂x₃ = (0.8332 - 0.5256) / 0.22 ≈ 1.40
Ако обучаемите параметри са γ = 1 и β = 0, това е и резултатът:[-0.88, -0.52, 1.40]
Стъпка 9: FFN (Feed-Forward Network) и MLP (Multilayer Perceptron)
FFN (Feed-Forward Network):
това е компонент на трансформъра, който обработва всяка дума (или токен) поотделно, без да отчита другите токени.
Прилага се независимо към всеки токен след слоя за внимание и представлява двуслойна невронна мрежа с нелинейна активационна функция.
Това позволява на модела да улавя по-сложни зависимости.
MLP (Multilayer Perceptron):
това е тип невронна мрежа, състояща се от няколко слоя напълно свързани неврони. В контекста на LLM и трансформърите MLP често означава същата Feed-Forward Network (FFN).
MLP = общото название на архитектурата,
FFN = частен случай на MLP, използван вътре в трансформърите.
От гледна точка на математиката:
x - входен вектор с размерност dW1-матрица на теглата на първия линеен слой с размерност (d_ff × d)b1-отместване на първия слой с размерност d_ffW2-матрица на теглата на втория линеен слой с размерност (d × d_ff)b2-отместване на втория слой с размерност df-активационна функция (например ReLU или GELU)d-размерност на входа/изходаd_ff-размерност на скрития слой (обикновено d_ff = 4 × d)
Основна формула на FFN:FFN(x) = W2 · f(W1 · x + b1) + b2
Разлагане стъпка по стъпка:
Линейно преобразуване, размерност на z1: (d_ff × 1):z1 = W1 · x + b1
Нелинейна активация, прилага се поелементно, размерността се запазва:z2 = f(z1)
Второ линейно преобразуване, крайният вектор е със същия размер като x: (d × 1):y = W2 · z2 + b2
Пример:
Входни данни:
Размерност на скрития слой d = 4,Вътрешна размерност d_ff = 8,Активация: ReLU,Входен вектор:x = [x[0], x[1], x[2], x[3]] = [1.0, -2.0, 0.5, 3.0]
матрица 8x4 W1 =[  [1, 0, 0, 0],  [0, 1, 0, 0],  [0, 0, 1, 0],  [0, 0, 0, 1],  [1, 1, 1, 1],  [1, -1, 1, -1],  [0.5, 0.5, 0.5, 0.5],  [-1, -1, -1, -1]]
Изчисление:
y[0] = 1 * x[0] + 0 * x[1] + 0 * x[2] + 0 * x[3] = 1.0 + 0 + 0 + 0 = 1.0y[1] = 0 * x[0] + 1 * x[1] + 0 * x[2] + 0 * x[3] = 0 - 2.0 + 0 + 0 = -2.0y[2] = 0 * x[0] + 0 * x[1] + 1 * x[2] + 0 * x[3] = 0 + 0 + 0.5 + 0 = 0.5y[3] = 0 * x[0] + 0 * x[1] + 0 * x[2] + 1 * x[3] = 0 + 0 + 0 + 3.0 = 3.0y[4] = 1 * x[0] + 1 * x[1] + 1 * x[2] + 1 * x[3] = 1.0 - 2.0 + 0.5 + 3.0 = 2.5y[5] = 1 * x[0] + (-1) * x[1] + 1 * x[2] + (-1) * x[3] = 1.0 + 2.0 + 0.5 - 3.0 = 0.5y[6] = 0.5 * x[0] + 0.5 * x[1] + 0.5 * x[2] + 0.5 * x[3] = 0.5 - 1.0 + 0.25 + 1.5 = 1.25y[7] = -1 * x[0] + (-1) * x[1] + (-1) * x[2] + (-1) * x[3] = -1.0 + 2.0 - 0.5 - 3.0 = -2.5
Вектор след линейния слой (преди активацията):y = [1.0, -2.0, 0.5, 3.0, 2.5, 0.5, 1.25, -2.5]
Прилагаме ReLU:ReLU(y[i]) = max(0, y[i])
ReLU(y) = [1.0, 0.0, 0.5, 3.0, 2.5, 0.5, 1.25, 0.0]
В съвременните модели FFN е малко по-сложен от описаното: използва се gated вариант (SwiGLU) с три матрици – две подготвят „кандидата“ и „вратата“ (gate), които се умножават поелементно, – а вместо ReLU се взема гладка активация SiLU/GELU; вътрешната размерност при това не е 4×, а около 2.7× от d_model. Същността не се променя: все така това са два линейни слоя и нелинейност, прилагани към всеки токен поотделно.
При MoE моделите точно на мястото на FFN стои набор от „експерти“: малък рутер избира за всеки токен няколко от тях (например 8 от 128) и работят само избраните – така Qwen 3 235B-A22B харчи за токен само 22 от своите 235 милиарда параметъра.
Стъпка 10: Residual + LayerNorm (втори слой за нормализация)
След FFN към резултата отново се прибавя входът на този блок (изходът от стъпка 8 – това, което е подадено във FFN) и векторът отново се нормализира – това помага да се запази информацията и да се стабилизират изчисленията
Стъпка 11: Подаване на изхода на блока към следващия трансформър блок
След като получи на изхода на един блок на трансформъра нормализиран вектор, моделът го предава на входа на следващия блок. Такива блокове може да са десетки – всеки добавя все повече „разбиране“ на контекста
Стъпка 12: Финална LayerNorm нормализация след последния блок
След последния слой още веднъж се прилага LayerNorm – това е заключителен щрих преди генерирането на логити, за да се изгладят разликите в стойностите
Стъпка 13: Линейна проекция в логити (Logits Projection) + Softmax
Нормализираният вектор от последния слой се умножава по матрицата на ембедингите (или по отделен линеен слой), за да се получат „сурови“ оценки (logits) за всеки токен от речника. След това тези оценки се превръщат във вероятности с помощта на Softmax или направо се подават на семплерите за подбор на токена
Какво са logits:
„сурови“ стойности, които още не са нормализирани във вероятности.
Например, ако речникът се състои от 50 000 токена, то logits са просто 50 000 числа, по едно за всеки токен.
За всеки токен в последователността моделът е формирал неговото представяне (hidden state).
Сега трябва този hidden state да се преобразува в логити по речника – оценка на вероятността за появата на всеки възможен следващ токен.
Преобразуване чрез Linear Layer:
logits = hidden_state @ Wᵀ + b
hidden_state: последният вектор (или цялата последователност – но по-често интересува последният токен),Wᵀ: транспонираната матрица на ембедингите (размер [vocab_size, hidden_dim]),b: отместване (bias), често се пропуска за икономия.
В част от моделите се прилага weight tying – Wᵀ се взема от същия слой, от който са ембедингите на входа; това спестява памет. Така правят основно компактните модели (Gemma, по-малките Qwen), а например големите Llama и DeepSeek държат отделна изходна матрица.
При генериране това преобразуване се прави само за последната позиция: за да се избере следващият токен, са нужни логитите само на последния hidden state – няма смисъл да се изчисляват стотици хиляди логити за всеки токен от промпта.
Стъпка 14: Избор на следващ токен (sampling)
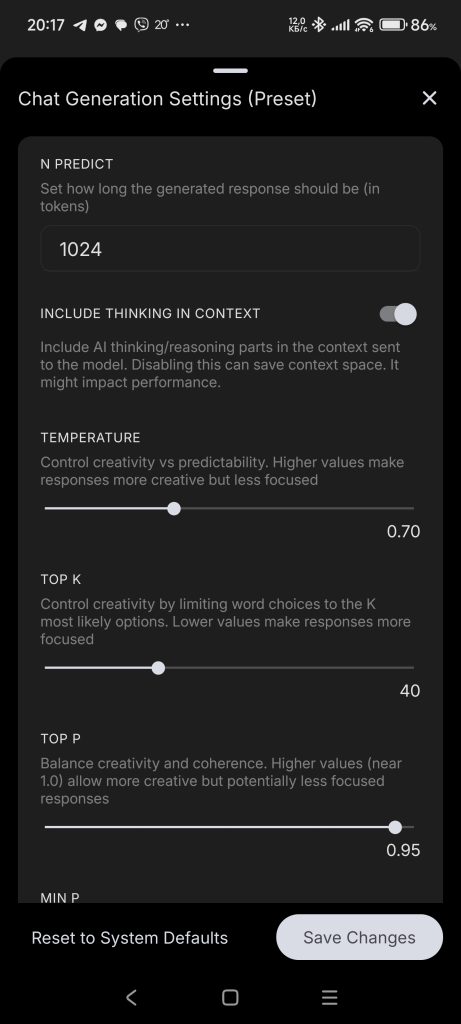
Получените logits минават през верига от семплери: първо се прилагат наказания за повторения и температура, след това филтри (top-k, top-p и др.), а накрая – финален семплер (Mirostat, алчен избор или разпределение). Именно този токен се добавя в контекста и генерирането се повтаря от стъпка 1 до достигане на края или на нужната дължина.
В бекенда LLama.cpp може да се съставят вериги от семплери: първо междинните, след това веригата трябва да завършва с финален семплер.
Редът на прилагане на семплерите в llama.cpp:
1. Наказания за повторения:   - repeat_penalty   - frequency_penalty   - presence_penalty   - DRY (наказание за повторение на n-грами)
2. Филтриране на токени:   - top_k   - typical_p   - top_p   - min_p   - XTC
3. Мащабиране на логитите:   - temperature
4. Граматични ограничения:   - grammar
5. Финален избор на токен:   - mirostat (v1 или v2) или   - greedy / dist (случайна извадка)
Пример от LLama.cpp (за разработчици):
// подготовка на параметрите на веригатаstruct llama_sampler_chain_params sparams = llama_sampler_chain_default_params();llama_sampler * smpl = llama_sampler_chain_init(sparams);
// междинни семплери:llama_sampler_chain_add(smpl, llama_sampler_init_top_k (50)); // Top-Kllama_sampler_chain_add(smpl, llama_sampler_init_typical (0.95f, 1)); // Locally Typicalllama_sampler_chain_add(smpl, llama_sampler_init_top_p (0.9f, 1)); // Top-P (nucleus)llama_sampler_chain_add(smpl, llama_sampler_init_min_p (0.05f, 1)); // Min-Pllama_sampler_chain_add(smpl, llama_sampler_init_xtc (0.9f, 1.0f, 1, LLAMA_DEFAULT_SEED)); // XTCllama_sampler_chain_add(smpl, llama_sampler_init_top_n_sigma(1.5f)); // Top-nσllama_sampler_chain_add(smpl, llama_sampler_init_temp (0.7f)); // Temperaturellama_sampler_chain_add(smpl, llama_sampler_init_temp_ext (0.7f, 0.1f, 1.5f));  // Extended temp
llama_sampler_chain_add(smpl, llama_sampler_init_grammar(vocab, grammar, "root"));llama_sampler_chain_add(smpl,llama_sampler_init_grammar_lazy_patterns(vocab, grammar, "root", patterns, 2, tokens, N));
// финален семплер, само 1 вариант от:llama_sampler_chain_add(smpl, llama_sampler_init_mirostat(32000, LLAMA_DEFAULT_SEED, 5.0f, 0.1f, 100)); // Mirostat V1llama_sampler_chain_add(smpl, llama_sampler_init_mirostat_v2(LLAMA_DEFAULT_SEED, 5.0f, 0.1f)); // Mirostat V2llama_sampler_chain_add(smpl, llama_sampler_init_greedy()); // Greedyllama_sampler_chain_add(smpl, llama_sampler_init_dist(LLAMA_DEFAULT_SEED)); // Dist
// след генерирането не забравяйте да освободите веригата:llama_sampler_free(smpl);
За llama.cpp имам отделна статия:
Пример за страница с настройки на семплерите от приложението https://github.com/a-ghorbani/pocketpal-ai

Междинни семплери
Temperature (temp)
управлява степента на случайност при избора на следващ токен от разпределението на вероятностите, изчислено от модела. Температурата стеснява или разширява „фунията на избора“ на следващата дума. Колкото е по-ниска, толкова фунията е по-тясна, колкото е по-висока – толкова е по-широка.
След като моделът е предсказал логитите (суровите стойности на вероятностите) за всички възможни токени, те минават през softmax функцията. Температурата влияе на тази функция:
P(token) = softmax(logits / temperature)Ефект на параметъра temperature:
T = 1 логитите остават такива, каквито са.
T < 1 (например 0.7) моделът усилва разликите между токените – вероятните токени стават още по-вероятни. Поведението става по-предвидимо.
T > 1 (например 1.5) разликите между токените се изглаждат – нараства шансът да се избере по-малко вероятен токен. Поведението става по-разнообразно и рисковано.
T → 0 softmax се превръща в argmax и винаги се избира един, най-вероятният токен.
Начални логити:Token A: 3.0Token B: 2.5Token C: 1.0
След softmax без промяна (temp = 1.0):A: 57%B: 35%C: 8%
С понижена температура (temp = 0.5):A: 72%B: 27%C: 1%
С повишена температура (temp = 1.5):A: 51%B: 36%C: 13%
Top-k
моделът избира следващия токен само измежду k-те най-вероятни. Всички останали токени се отхвърлят, независимо от абсолютната им вероятност.
има 6 токена със следните вероятности:A: 0.35B: 0.30C: 0.15D: 0.10E: 0.06F: 0.04
Ако top_k = 3, ще оставим само:A: 0.35B: 0.30C: 0.15
Top-p (nucleus sampling)
избира се минималното множество токени с най-големи вероятности, чийто сбор надвишава зададения праг p. Останалите токени се отсичат напълно, дори ако са имали висок ранг.
моделът е върнал вероятности на токените:A: 0.50B: 0.25C: 0.15D: 0.08E: 0.02
При top_p = 0.9 набираме токените с най-големи вероятности,докато сборът им достигне прага:0.50 + 0.25 + 0.15 = 0.90 – остават A, B, CD и E ще бъдат отхвърлени – после вероятностите на останалите се нормализират отново.
Min-p
отсичат се всички токени, чиято вероятност е под праг, зададен като дял p от вероятността на най-вероятния токен. Например при min_p = 0.1 и вероятност на лидера 0.50 прагът ще бъде 0.05 – всичко под него се отхвърля. Прагът е относителен: когато моделът е уверен, филтърът е по-строг, когато разпределението е плоско – по-мек.
Typical sampling
избира токени, близки до „типичното“ ниво на изненада (surprisal), като отсича твърде предвидимите и твърде редките. За разлика от top-k и top-p, той се ориентира по медианната стойност на surprisal, а не по вероятността на токените.
Repetition penalties, Frequency penalty, Presence penalty
намалява шансовете за повторен избор на вече генерирани токени, като понижава техните логити. Това помага да се избегнат натрапчиви повторения в текста и прави изхода по-разнообразен.
Logit bias
метод, който позволява ръчно да се промени вероятността на отделни токени преди прилагането на softmax, като към логитите им се добавят или изваждат стойности. Това дава точков контрол: например може да се накара моделът да избягва определени думи или, обратно, по-често да ги избира.
Tail Free Sampling (TFS)
отхвърля дългата „опашка“ на разпределението, като регулира плътността на вероятностите.
DRY (Don't Repeat Yourself)
наказва токени, които биха продължили вече срещани в текста n-грами: колкото по-дълго е полученото повторение, толкова по-силно е наказанието. Добре премахва зациклянето върху цели фрази, без да засяга единичните повторения на думи.
Grammar
използва правила на граматика (обикновено във вид на CFG) за строго ограничаване на допустимите токени на всяка стъпка от генерирането. Вместо да променя логитите, той просто забранява всички токени, които не съответстват на текущото допустимо състояние на граматиката, като осигурява строго структуриран изход.
и други
Финални семплери
Greedy
най-простият начин за генериране, при който моделът винаги избира токена с най-висока вероятност (максимален логит). Бърз е и детерминиран, но често води до еднообразен и предвидим текст.
Random
случаен избор на следващия токен, пропорционално на вероятността му след всички приложени семплери (top-k, top-p и т.н.). Това е противоположното на алчния избор (greedy), при който винаги се взема токенът с максимална вероятност.
Dist
така в llama.cpp се нарича финалната случайна извадка: токенът се избира случайно, пропорционално на крайното разпределение на вероятностите след всички филтри – същото като Random по-горе, с фиксиран seed за възпроизводимост.
Mirostat v1
поддържа зададено ниво на „изненада“ (перплексия), като динамично коригира избора на думи. Помага да се избегнат прекомерни повторения (капан на скуката) и несвързаност (капан на объркването), като осигурява балансирано и качествено генериране на текст.
Mirostat v2
поддържа зададено ниво на неочакваност (перплексия) с по-точно управление, отколкото Mirostat v1. Използва разширен механизъм за обратна връзка, който позволява динамично да се коригира изборът на думи за постигане на стабилно качество на текста.
и други
Стъпка 15: Итерация на генерирането
След като моделът е избрал следващия токен, неговият ID се добавя в края на входната последователност – повторна токенизация не е нужна, избраният токен вече е токен.
После цикълът се повтаря: моделът изчислява вниманието вече с отчитане на новия токен и предсказва следващия, и така докато не бъдат изпълнени условията за прекратяване.
Всички предишни токени обаче не е нужно да се преизчисляват отново: техните K- и V-вектори се пазят в KV кеша и на всяка итерация наистина се обработва само новият токен – именно затова стъпките на генерирането отнемат приблизително еднакво време.
Оттук идват двете фази на работа на модела, познати на всеки по усещането „помисли – и после пише равномерно“. Първо prefill: целият промпт се обработва с един паралелен проход, като се запълва KV кешът – това е паузата до първата дума и е толкова по-дълга, колкото по-дълъг е промптът. След това decode: токените се генерират един по един, всеки за приблизително еднакво време. Затова скоростта на модела се описва с две различни числа – време до първия токен и токени в секунда.
Такъв цикъл позволява да се построи цялата изходна последователност токен по токен.
Условия за завършване
Генерирането завършва, когато моделът издаде специален токен за край на последователността (EOS) или когато се достигне предварително зададената максимална дължина на последователността.
Това ограничение предотвратява безкрайни или твърде дълги отговори.
Генерирането се спира и от стоп-последователности: предварително зададени низове (например маркер за начало на следващата реплика от диалога), при появата на които изходът се прекъсва.
Стъпка 16: Преобразуване на токените в думи
След като моделът е генерирал нужния брой токени, те се преобразуват обратно в текст – това се нарича детокенизация. Токенизаторът взема последователност от числа (токени) и ги превръща в думи и препинателни знаци. На практика чат интерфейсите правят това в движение – това е и стрийминг: всеки избран токен веднага се детокенизира и се дописва на екрана, затова отговорът се появява дума по дума, а не изцяло накрая.
Как е обучаван моделът
Всичко описано по-горе е работата на вече готов модел. Самият той се получава на няколко етапа.
Предварително обучение (pretraining):
Моделът трилиони пъти решава една и съща задача – да предскаже следващия токен в текст от огромен корпус (уеб, книги, код). Не са нужни никакви етикети: правилният отговор е просто истинският следващ токен. На този етап моделът научава езика, фактите и закономерностите, но умее само да продължава текст.
Инструкционно дообучаване (SFT, Supervised Fine-Tuning):
Моделът се дообучава върху примери от вида „заявка → добър отговор“, написани от хора или подбрани измежду генерации. След това той отговаря на въпроси, а не ги продължава.
Подравняване (RLHF, DPO):
Хора сравняват двойки отговори на модела и избират по-добрия; върху тези предпочитания моделът се дообучава да дава полезни и безопасни отговори. Класическият начин е обучение с подкрепление по човешки оценки (RLHF); по-проста съвременна алтернатива е DPO, където предпочитанията се използват директно като обучаващи примери.
Reasoning модели
„Мислещите“ модели от таблиците по-горе (DeepSeek R1, Qwen 3 в режим на разсъждение, Gemma 4) механично с нищо не се отличават: това са същите трансформъри, които генерират същите токени. Разликата е в обучението: допълнително са ги обучавали с подкрепление върху задачи с проверим отговор, като са ги награждавали за верния резултат – и моделът сам е научил преди отговора да пише дълга верига от разсъждения, чернова, която интерфейсът после скрива зад спойлер. За това се плаща с токени: „мислещият“ отговор може да е пъти по-дълъг и по-бавен от обикновения.
Откъде се вземат халюцинациите
Направо от механиката на генерирането. Моделът е длъжен винаги да избере следващ токен – при него няма вградено състояние „не знам“, има само разпределение на вероятностите, от което нещо ще бъде избрано. Ако знанията за предмета в теглата са малко, разпределението пак ще даде правдоподобно звучащо продължение: правилната форма на отговора с измислено съдържание. Затова халюцинациите не са бъг, който някога ще бъде поправен, а свойство на самия подход; те се потискат с обучение (моделът се учи да отказва да отговаря), с инструменти като RAG и уеб търсене, но не се премахват напълно.
Интересни въпроси и отговори
Възможно ли е да се опише в няколко изречения как работи невронната мрежа?
Ще се опитам. Моделът е огромна функция, обучена за една задача: по началото на текста да предскаже кой токен (парченце от дума) най-вероятно идва след него. Вашият въпрос се превръща в последователност от токени, моделът изчислява вероятностите на всички възможни продължения, от тях се избира един токен, дописва се към текста – и всичко се повтаря, токен след токен, докато не се получи отговор. А цялото „разбиране“ се състои в това, че по време на обучението върху огромен корпус от текстове теглата на модела са се научили да предсказват продължението с оглед на смисъла и контекста на цялата фраза, а не просто по честотата на думите.
Защо в LLM моделите на входа се подава въпрос, а на изхода се получава отговор, а не перифразиран въпрос?
Моделът е обучен върху текстове от вида „въпрос→отговор“, затова когато види въпрос, нататък се генерират не думите на самия въпрос, а най-вероятното продължение – отговорът.
По време на инструкционното обучение (SFT) и RLHF той се „поощрява“ за полезни отговори, а не за повторение на формулировката, затова параметрите се изместват към отговорите.
В термините на вероятностите: за един въпрос вероятността следващият токен да е от отговора е по-висока, отколкото да е токен, повтарящ въпроса, и декодерът избира именно него.
Данните, върху които се обучава LLM моделът, остаряват – какви са възможностите, за да генерира моделът актуални отговори?
Retrieval-Augmented Generation (RAG):
При заявка моделът търси в актуална външна база (търсене по векторен или текстов индекс) релевантни документи и използва техния контекст при генерирането на отговора. Така може да се получава свежа информация без повторно обучение на основната мрежа
Параметрично ефективно дообучаване (LoRA, Adapters):
Вместо пълно преобучаване на модела в него се вграждат малки адаптери или low-rank матрици (LoRA), които се обучават върху новите данни. Това позволява бързо и евтино да се нагоди моделът към предметна област, стил или формат на отговорите. С новите факти е различно: дообучаването ги добавя зле и фактите, които трябва да са точни, е по-добре да се дават на модела чрез RAG.
За LoRA направих отделна статия:
Целево редактиране на теглата (Model Editing):
Алгоритми от типа на MEMIT/ROME локално коригират теглата на модела, за да добавят или обновят конкретни факти, без да засягат останалата част от знанията
Отделни бази от знания и графи:
Вместо да се съхраняват фактите вътре в параметрите на LLM, те се изнасят във външни KB или графи на знанията, които редовно се обновяват, а моделът само ги пита за информация
Интеграция с уеб търсене и API:
Свързването на модела с живи източници – вградено уеб търсене в чат ботовете, извикване на външни API и инструменти (function calling, MCP сървъри) – директно връща свежо съдържание.
По какъв начин LLM моделът разбира различни езици?
Моделът „разбира“ различните езици благодарение на това, че в процеса на обучение вижда текстове на много от тях и се учи да предсказва следващия фрагмент независимо от езика. Основните моменти:
Голям мултиезиков корпус:
За обучението се събират текстове (уикипедия, книги, уеб страници от Common Crawl и други) на десетки и стотици езици. Например в отворения модел BLOOM е имало около 46 езика, като делът на всеки зависи от обема на наличните данни
Обща токенизация subword:
Използват се алгоритми като BPE или SentencePiece, които разбиват думите на фрагменти (subword) и включват в речника символи и последователности от различни азбуки. Така моделът оперира с един-единствен набор от токени за всички езици
Универсална архитектура на трансформъра:
В трансформъра едни и същи тегла участват в обработката на всякакви езици. Затова при обучение върху различни езици моделът намира общи закономерности (синтаксис, семантика) и използва кръстосан пренос на знания (cross-lingual transfer)
Не всички езици и не във всички обеми:
Обучават се само върху онези езици, за които има достатъчно текстове. Редките или нискоресурсните езици попадат в отделни дообучавания или получават по-малък дял от данните, затова качеството на генериране за тях е по-ниско
Специални дообучавания и адаптери:
За да се подобри познаването на малко известните езици, се прилага дообучаване (continual pretraining) върху локални данни или се вмъкват адаптери (adapters, LoRA), които фино коригират знанията на модела за конкретен език.
Допълнителна информация
Точност на вектора
Също така числата с плаваща запетая, от които се състои векторът, могат да имат различна точност:
По-малката точност намалява размера на модела и ускорява обработката.
Обикновено моделите се обучават с пълна точност FP32 (float32), тоест векторът се състои от числа с дължина 32 бита.
Квантуване (Quantization)
за да се намали точността и да се олекоти моделът, се използва квантуване – процес на преобразуване на числата с плаваща запетая (например FP32) в по-компактни целочислени представяния (например INT8), със запазване на приблизителната стойност.
При това се въвежда малка загуба на точност, но тя често не влияе критично на качеството на изхода.
Формат: FP32 (float32), 32 бита = 4 байтаПредназначение: Пълна точност. Използва се при обучение на модели, а също и при точен инференс.Осигурява максимална точност, но изисква много памет и изчислителни ресурси.Двоична стойност: 01000000 01001001 00001111 11011011Действителна стойност: 3.14159Възможни типове квантуване: Не се използва – това е пълен (неквантуван) формат.
Формат: FP16 (float16), 16 бита = 2 байтаПредназначение: Половин точност. Използва се за ускорено обучение и инференс на GPU (например NVIDIA Tensor Cores).По-бърз и 2 пъти по-икономичен по памет в сравнение с FP32.Двоична стойност: 01000010 01001000Действителна стойност: ≈ 3.140625В GGUF файловете неквантуваните тегла с такава точност се маркират като F16.
Формат: BF16 (bfloat16), 16 бита = 2 байтаПредназначение: Алтернатива на FP16, използвана в TPU и някои GPU. Има същия експонент като FP32, но съкратена мантиса.По-бърз и по-компактен е, като същевременно запазва диапазона на FP32.Двоична стойност: 01000000 01001001(това са просто първите два байта от представянето на FP32 – мантисата е съкратена)Действителна стойност: ≈ 3.140625В GGUF файловете се маркира като BF16.
Формат: INT8 (8 бита), scale = 0.125Предназначение: Квантувано цяло число. Използва се в оптимизирани модели за инференс на CPU и мобилни устройства.Изисква възстановяване на мащаба (scale) и на отместването (zero_point).Квантувана стойност: 25Двоична стойност: 00011001Действителна стойност: 25 × 0.125 = 3.125Възможни типове квантуване: Q8_0, Q8_1, Int8Affine, PerChannelQuant (ONNX), dynamic/int8 (TensorFlow Lite)
Формат: INT4 (Q4), 4 бита, scale = 0.5 (2 числа в 1 байт)Предназначение: Много компресиран формат за езикови модели. Използва се в llama.cpp, GGUF и други системи.Осигурява съществено намаляване на размера на модела. Изисква възстановяване (деквантуване) при стартиране.Квантувана стойност:7 (максималната стойност за signed 4-битов int: -8…+7)Двоична стойност: 0111Действителна стойност: 7 × 0.5 = 3.5Възможни типове квантуване:Q4_0, Q4_1, Q4_K_S, Q4_K_M (llama.cpp, GGUF)
Формат: INT2 (Q2), 2 бита, scale = 1.0 (4 числа в 1 байт)Предназначение: Изключително компресиран формат за използване в LLM на устройства с ограничени ресурси.Използва се в някои варианти на GGUF, MLC, а също и в експерименти с екстремално квантуване.Квантувана стойност: 1 (максимум измежду стойностите: -2…+1)Двоична стойност: 01Действителна стойност: 1 × 1.0 = 1.0Възможни типове квантуване: Q2_K (llama.cpp, GGUF)Реалният Q2_K съхранява още блокови мащаби, затова на практика заема около 2.6 бита на тегло.
Формат: INT1 (Q1), 1 бит, scale = 2.0 (8 числа в 1 байт)Предназначение: Минимално възможна точност. Използва се в бинарни невронни мрежи и прототипи.Обикновено стойностите са -1 или +1. Прилага се рядко в LLM, но може да е полезен в BNN (Binary Neural Networks).Квантувана стойност: 1Двоична стойност: 1Действителна стойност: 1 × 2.0 = 2.0Възможни типове квантуване: BinaryNet, XNOR-Net (по-често в академични/експериментални BNN)Съвременен пример за екстремално квантуване на LLM – BitNet b1.58 с тернарни тегла -1/0/+1 (~1.58 бита на тегло).
Също така моделите могат да имат допълнителни параметри на квантуване:
_K- Означава „K-блоково“ квантуване (K-Block Quantization).- Теглата се разбиват на блокове с фиксирана дължина (например по 32 или 64 стойности).- Във всеки блок се използват общи scale и zero_point.- Това позволява съществено да се намали размерът на модела, като се запазва по-висока точност в сравнение с простото квантуване.- Примери за формати: Q2_K, Q4_K, Q6_K, Q8_K
_0, _1- Показват каква схема на квантуване се прилага:  - _0: базова схема, без отмествания (bias), един scale на блок  - _1: подобрена схема, с допълнителни bias или scale отмествания- Използват се във формати: Q4_0, Q4_1, Q5_0, Q5_1, Q8_0, Q8_1- По правило _1 осигурява по-добра точност при незначително увеличение на размера
Етикети за вариант по размер: K_S, K_M, K_L
K_S- Small – най-малкият и най-агресивно компресираният вариант- Максимална икономия на памет за сметка на качеството
K_M- Medium – среден компромис между точност и обем- Най-популярният избор за локално стартиране
K_L- Large – най-големият и най-точният от K-вариантите- Малко повече памет, малко по-високо качество
Пример за име на модел:„mistral-7b.Q4_K_M.gguf“ – това означава:- Модел Mistral 7B- Използва се квантуване Q4_K (4-битово K-блоково)- Вариант по размер: Medium
Освен K-квантите в llama.cpp има по-нови I-кванти(IQ2_XXS, IQ3_S, IQ4_XS и др.) – те дават по-добро качествопри същия размер за сметка на по-сложна схема на кодиране.
Продуктово квантуване (Product Quantization)
Метод, който позволява силно да се компресират векторите на характеристиките (ембединги), като се разбиват на части и всяка част се кодира чрез най-близкия шаблон (клъстер). Използва се във векторни бази и при търсене на най-близки съседи (например FAISS); теглата на самите LLM обикновено не се компресират с него.
Как работи:
Има вектор (например с размер 128 числа). Това може да е ембединг на текст или изображение от невронна мрежа.
Разбиваме вектора на парчета – например 8 части по 16 числа (128 / 8 = 16).
За всяка позиция на парче обучаваме свой кодер (квантайзер) – върху големи обеми данни предварително се избира кои „шаблони“ (центрове на клъстери) приличат на възможните парчета.
Например:
първото парче може да прилича на шаблон №12,
второто – на шаблон №3,
третото – на шаблон №88,
и така нататък.
Запазваме само номерата на тези шаблони. Вместо да съхраняваме 128 числа (float32 = 512 байта), съхраняваме например 8 числа (по 1 байт на шаблон) – общо 8 байта.
QAT (Quantization-Aware Training) квантуване:
това е метод за квантуване на невронни мрежи, при който квантуването се отчита още по време на обучението на модела. Той позволява да се постигне почти същата точност като при оригиналния модел с float параметри, като при това моделът ще използва по-компактни int8 или други нискоразредни формати, подходящи за ефективно стартиране на устройства с ограничени ресурси (например смартфони или микроконтролери).
Как работи QAT – стъпка по стъпка:
Модел във float32:
Обучението започва с обикновен модел, който използва числа с плаваща запетая (обикновено float32). Това осигурява висока точност и стабилност на обучението.
Имитация на квантуване по време на forward pass (fake quantization):
При всяко преминаване напред стойностите (тегла, активации) се емулират като квантувани, т.е. преобразуват се в int8, а след това обратно във float32. Това дава възможност на модела да „види“ грешките от квантуването още на етапа на обучение.
float32 → int8 → float32
Така по време на обратното разпространение (backpropagation) градиентите се изчисляват по float32 версията, но грешките заради квантуването все пак влияят на обучението.
Обновяване на параметрите (backward pass):
Градиентите се изчисляват както обикновено, но с отчитане на изкривяванията от fake quantization. Това позволява на модела да се адаптира към това, че теглата и активациите впоследствие ще се използват с ниска точност.
Експорт на финалния модел в int8:
След приключване на обучението теглата наистина се квантуват в int8 и моделът може да бъде компилиран и пуснат в продукционна среда.
Какво точно се квантува:
Тегла (weights) – float32 → int8
Активации (activations) – float32 → int8
(Понякога се квантуват и градиентите и междинните състояния, но това е рядкост.)
Защо да се използва QAT:
По-висока точност, отколкото при post-training quantization (PTQ)
Ниска консумация на памет
По-бързо изпълнение на CPU/GPU/NPUs с поддръжка на int8
Особено важно за мобилни и embedded устройства (например Android)
Колко памет е нужна на модела
Груба формула: брой параметри × байтове на тегло, плюс KV кеш, плюс малко за активациите.
Модел 7-8B:FP16 (2 байта на тегло)   ≈ 14-16 ГБQ8 (1 байт на тегло)      ≈ 7-8 ГБQ4 (~0.6 байта на тегло)  ≈ 4-5 ГБ
Модел 27-32B в Q4         ≈ 16-20 ГБМодел 70B в Q4            ≈ 40+ ГБ
Плюс KV кеш: зависи от дължината на контекста,при десетки хиляди токена – още гигабайти.
Практическо правило за локално стартиране: да се гледа не „милиардите параметри“, а размерът на конкретния GGUF файл – той честно показва колко памет ще заемат теглата – и да се оставя запас за контекста.
Начини за стартиране (бекенди) на LLM модели
vLLM:
Основен сървърен двигател за LLM инференс: непрекъснато батчване на заявките и PagedAttention за икономичен KV кеш; де факто стандарт за внедряване на отворени модели на GPU.
Формати: тегла на Hugging Face (.safetensors)
SGLang:
Бързо растяща алтернатива на vLLM с повторно използване на KV кеша между заявките (RadixAttention); силен е при структурирано генериране и агентни натоварвания.
Формати: тегла на Hugging Face (.safetensors)
NVIDIA TensorRT-LLM:
Специализирана LLM надстройка над TensorRT: компилира модела за конкретни GPU на NVIDIA, максимална скорост за сметка на гъвкавостта.
Формат: компилиран двигател
ONNX Runtime:
Кросплатформен двигател за изпълнение на модели във формат ONNX.
Формат на файла: .onnx
TensorFlow (Inference API):
Стандартен двигател за модели на TensorFlow, поддържа SavedModel и замразен граф.
Формати: папка SavedModel (saved_model.pb + variables/), единичен файл .pb
LiteRT (бивш TensorFlow Lite):
Лек двигател за мобилни и вградени устройства, оптимизиран по размер и скорост.
Формат: .tflite
PyTorch (TorchScript):
Позволява да се сериализират и стартират модели без зависимост от Python, с JIT оптимизации.
Формати: .pt, .pth
NVIDIA TensorRT:
Хардуерно ускорен двигател за GPU на NVIDIA, компилира моделите (обикновено от ONNX) за конкретна карта.
Формат: компилиран двигател .engine (или план UFF/ONNX → .engine)
Intel OpenVINO:
Оптимизира и ускорява мрежи на CPU и Intel GPU/VPU, конвертира моделите в IR формат.
Формати: .xml (структура) + .bin (тегла)
Apple Core ML:
Фреймуърк за стартиране на модели на iOS/macOS, интегрира се с Xcode и се ускорява чрез Core ML Runtime.
Формати: .mlpackage, остарял .mlmodel
Microsoft ML.NET:
.NET двигател за инференс на CPU, подходящ за C# и F#.
Формат: архив на модела .zip
Apache TVM:
Компилира и оптимизира модели за разнообразен хардуер, създава нативни библиотеки.
Формати: сериализиран Relay модул или компилирана библиотека (.so, .dll)
Alibaba MNN:
Мобилен невронен двигател с широки оптимизации за ARM, поддържа и стартиране на сървър.
Формат: .mnn
Tencent NCNN:
Компактен двигател за мобилни CPU/GPU, без външни зависимости.
Формати: .param (структура) + .bin (тегла)
OpenCV DNN:
Модул за компютърно зрение с поддръжка на различни формати (ONNX, Caffe, TensorFlow, Darknet).
Формати: зависи от изходния – .onnx, .pb, .caffemodel + .prototxt, .weights
Unity Sentis (по-рано Barracuda):
Двигател за стартиране на невронни мрежи в игри на Unity, поддържа ONNX модели.
Формати: .onnx, .sentis
MLC LLM:
ML компилатор и двигател за LLM, компилира теглата в свой IR и ги разпределя на шардове.
Формат: каталог …-MLC с .bin шардове и JSON конфигурации (например mlc-chat-config.json)
MediaPipe:
Фреймуърк за създаване на мултимодални пайплайни (детекция, сегментация и др.), опира се на TFLite.
Формати: .tflite (модел) + .pbtxt (граф)
llama.cpp:
C++ двигател за LLaMA-подобни модели с поддръжка на квантуване на CPU/GPU.
Формат: .gguf (старият GGML формат .bin е остарял)
GGML:
Библиотека за ефективен инференс на модели (основа на llama.cpp и др.).
Формати: .gguf, .bin
NeuralMagic DeepSparse:
Оптимизиран двигател за разредени невронни мрежи на CPU.
Формат: .onnx
AWS Neuron SDK:
Двигател за ускоряване на инференса на AWS Inferentia, компилира моделите за Neuron.
Формати: Neuron артефакти (.nef или библиотека)
По-нататък са изброени двигатели, които са по-скоро исторически: днес почти не се срещат, но се споменават в стари материали.
Glow:
Компилатор и рънтайм от Facebook за невронни мрежи, входният формат е ONNX.
Формати: междинен файл .bc или компилирана библиотека .so
Apache MXNet:
Фреймуърк със собствен рънтайм за CPU/GPU, поддържа внедряване с Docker.
Формати: .params (тегла) + .json (мрежа)
Caffe:
Класически двигател за CV мрежи, често използван в изследвания.
Формати: .caffemodel (тегла) + .prototxt (описание на мрежата)
Приложения за стартиране на LLM модели
LM Studio:
Десктоп приложение за Windows, macOS и Linux с GUI за стартиране на локални LLM (GPT-подобни).
Формати на моделите: .gguf, .bin
Ollama:
Лек CLI/GUI клиент за Windows, macOS и Linux, работи „от кутията“ с LLM.
Формати на моделите: .gguf, .bin
Jan:
Отворен десктоп клиент за Windows, macOS и Linux в духа на LM Studio, но изцяло open source; работи върху llama.cpp.
Формати на моделите: .gguf
Open WebUI:
Уеб интерфейс към Ollama и всякакви OpenAI-съвместими сървъри: чатове, RAG върху собствени документи, няколко потребители; инсталира се локално или на собствен сървър.
Формати на моделите: тези, които поддържа свързаният бекенд
KoboldCpp:
Еднофайлов билд на llama.cpp с уеб интерфейс и богати настройки на семплерите, популярен за творческо генериране.
Формати на моделите: .gguf
llama.cpp (prebuilt binaries):
Готови изпълними файлове за Windows/macOS/Linux, позволяват да се стартират LLaMA-подобни модели без инсталиране на зависимости.
Формати на моделите: .bin, .gguf
Отделна група са приложенията за генериране на изображения (Stable Diffusion), не са LLM:
Automatic1111 Stable Diffusion WebUI:
Най-популярният локален уеб интерфейс за генериране на изображения на Windows/macOS/Linux.
Формати на моделите: .ckpt, .safetensors
DiffusionBee:
Настолно приложение за macOS (има бета версии за Windows), „всичко в едно“ за Stable Diffusion.
Формати на моделите: .ckpt, .safetensors
InvokeAI:
Кросплатформен пакет с CLI и WebUI за генериране на изображения на базата на Stable Diffusion.
Формати на моделите: .ckpt, .safetensors
Формат за съхранение на LLM модели
.pt / .pth
Използват се в PyTorch за запазване на обучени модели
Съхраняват тегла и структура на модела (или само теглата).
Основани са на сериализацията на Python (pickle), което ги прави не особено сигурни.
Подходящи са за обучение и дообучаване.
Не са оптимизирани за мобилен инференс или външен инференс
Могат да заемат много памет (FP32).
.safetensors
Алтернатива на .pt, сигурен и бърз формат за PyTorch.
Не използва pickle, затова е безопасен при зареждане.
Поддържа паралелно зареждане, което ускорява работата.
Само за съхранение на теглата (структурата е отделно).
Подходящ е за инференс и дообучаване.
Поддържа се от HuggingFace, PyTorch, JAX.
.bin
Универсален или частен двоичен формат за тегла на модели, особено в HuggingFace и в стария GGML.
Може да е неформализиран (структурата зависи от фреймуърка).
Може да съдържа пълни тегла или квантувани данни.
Подходящ е за зареждане в персонализирани двигатели (например llama.cpp).
Изисква точно да се знае как да се интерпретира съдържанието.
Често се използва в стари проекти или персонализирани пайплайни.
.gguf
Стандарт на екосистемата GGML за стартиране на LLM в llama.cpp, Ollama, LM Studio.
Включва всичко в един файл: тегла, речник, токенизатор, параметри на модела.
Поддържа различни типове квантуване (Q2_K, Q4_0, Q8_1 и т.н.).
Добре е компресиран и оптимизиран за стартиране на CPU, GPU, Android.
Зарежда се бързо и лесно се обработва от C++ код.
Основен избор за локално стартиране на LLM (Gemma, LLaMA, Mistral).
.onnx
Кросфреймуърк формат за стартиране на модел в различни среди (Windows, Web, C#, Java и др.).
Стандартизиран е, поддържа се от много фреймуъркове (PyTorch, TF, Keras).
Улеснява пренасянето на модели между платформи.
Подходящ е за инференс (не за обучение).
Оптимизира се със средствата на ONNX Runtime (компресиране, квантуване).
Отличен избор за стартиране на модели в embedded среди и .NET.
.tflite
Формат за стартиране на модели на TensorFlow на мобилни устройства (Android, iOS).
Много е компактен и бърз.
Поддържа INT8 и FP16 квантуване.
Работи с интерпретатора LiteRT (бивш TensorFlow Lite), лесно се вгражда в Android.
Не може да се обучава или дообучава – само стартиране.
Първоначално е бил предвиден за компактни CNN/RNN модели, но сега чрез LiteRT и MediaPipe LLM Inference върху него се стартират и малки LLM (например Gemma).
Формат MLC LLM
Стартиране на LLM на Android/iOS/GPU чрез компилация; единен файл-контейнер няма – моделът се съхранява като каталог с шардове на теглата и JSON конфигурации плюс компилирана библиотека.
Моделът предварително се компилира в ефективен байткод.
Поддържа Vulkan/Metal/OpenCL за ускорение.
Използва се за Gemma, Mistral, LLaMA на телефон.
Изисква сложна подготовка (TVM, скриптове, настройка).
Отлично подхожда за мобилни приложения без сървъри.